
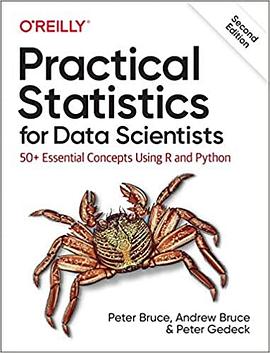
Practical Statistics for Data Scientists, 2nd Edition pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 數據科學
- 統計實踐
- 統計學
- 科普
- DataScience
- 數據分析
- 2020
- Statistics
- Data Science
- Python
- R
- Machine Learning
- Data Analysis
- Probability
- Statistical Modeling
- Data Visualization
- Second Edition

具體描述
Statistical methods are a key part of data science, yet few data scientists have formal statistical training. Courses and books on basic statistics rarely cover the topic from a data science perspective. The second edition of this practical guide—now including examples in Python as well as R—explains how to apply various statistical methods to data science, tells you how to avoid their misuse, and gives you advice on what’s important and what’s not.
Many data scientists use statistical methods but lack a deeper statistical perspective. If you’re familiar with the R or Python programming languages, and have had some exposure to statistics but want to learn more, this quick reference bridges the gap in an accessible, readable format.
With this updated edition, you’ll dive into:
Exploratory data analysis
Data and sampling distributions
Statistical experiments and significance testing
Regression and prediction
Classification
Statistical machine learning
Unsupervised learning
作者簡介
Peter Bruce is the Founder and Chief Academic Officer of the Institute for Statistics Education at Statistics.com, which offers about 80 courses in statistics and analytics, roughly half of which are aimed at data scientists. He has authored or co-authored several books in statistics and analytics, and he earned his Bachelor’s degree at Princeton, and Masters degrees at Harvard and the University of Maryland.
Andrew Bruce, Principal Research Scientist at Amazon, has over 30 years of experience in statistics and data science in academia, government and business. The co-author of Applied Wavelet Analysis with S-PLUS, he earned his bachelor’s degree at Princeton, and PhD in statistics at the University of Washington
Peter Gedeck, Senior Data Scientist at Collaborative Drug Discovery, specializes in the development of machine learning algorithms to predict biological and physicochemical properties of drug candidates. Co-author of Data Mining for Business Analytics, he earned PhD’s in Chemistry from the University of Erlangen-Nürnberg in Germany and Mathematics from Fernuniversität Hagen, Germany
目錄資訊
讀後感
这本书的作者是统计学领域大咖, Statistics.com统计学教育学院的创立者兼院长,重采样统计软件的开发者。 统计学的书市面上有不少了,但能从应用角度把统计学一些关键概念讲明白的不多。虽然书名说是”面向数据科学家“的,但适合所有人用来学习和巩固统计学基础。 最好了解一...
評分这本书的作者是统计学领域大咖, Statistics.com统计学教育学院的创立者兼院长,重采样统计软件的开发者。 统计学的书市面上有不少了,但能从应用角度把统计学一些关键概念讲明白的不多。虽然书名说是”面向数据科学家“的,但适合所有人用来学习和巩固统计学基础。 最好了解一...
評分这本书的作者是统计学领域大咖, Statistics.com统计学教育学院的创立者兼院长,重采样统计软件的开发者。 统计学的书市面上有不少了,但能从应用角度把统计学一些关键概念讲明白的不多。虽然书名说是”面向数据科学家“的,但适合所有人用来学习和巩固统计学基础。 最好了解一...
評分这本书的作者是统计学领域大咖, Statistics.com统计学教育学院的创立者兼院长,重采样统计软件的开发者。 统计学的书市面上有不少了,但能从应用角度把统计学一些关键概念讲明白的不多。虽然书名说是”面向数据科学家“的,但适合所有人用来学习和巩固统计学基础。 最好了解一...
評分这本书的作者是统计学领域大咖, Statistics.com统计学教育学院的创立者兼院长,重采样统计软件的开发者。 统计学的书市面上有不少了,但能从应用角度把统计学一些关键概念讲明白的不多。虽然书名说是”面向数据科学家“的,但适合所有人用来学习和巩固统计学基础。 最好了解一...
用戶評價
說實話,市麵上很多數據科學統計書籍都是為那些已經有紮實數學背景的人準備的,讀起來像在啃翻譯過來的學術論文,充滿瞭各種希臘字母和不相關的背景知識鋪墊。然而,這本書采取瞭一種截然不同的“自下而上”的敘事方式,它不急於證明泰勒展開式,而是直接把你扔到“如何判斷一個新上綫的推薦算法是否真的有效”的場景中去。我特彆欣賞作者對數據可視化和探索性數據分析(EDA)的重視。他們沒有把EDA當作一個簡單的預處理步驟,而是將其提升到瞭一個與建模同等重要的地位,詳細講解瞭如何通過散點圖矩陣、殘差圖來診斷模型假設是否被違反,以及如何使用分位數圖(Q-Q Plot)來快速判斷數據分布形態。這種以“診斷問題”為導嚮的教學方法,極大地提升瞭我對數據質量的敏感度。過去我常常忽略模型殘差的正態性問題,現在我明白,如果殘差不滿足獨立同分布的假設,那麼我計算齣來的P值和置信區間都是毫無意義的“幻覺數字”。這種從結果反推過程的紮實訓練,讓我對自己的分析結果更有信心,也更能有效地嚮非技術背景的同事解釋為什麼某個模型需要進行特定的數據轉換處理。
评分我個人覺得,這本書最獨特的一點是它對統計學在現代大數據環境下的局限性和適用性的坦誠探討。它沒有過度神化某些統計工具的萬能性。比如,在涉及到大規模數據(Big Data)的場景時,它沒有迴避現代優化算法帶來的偏差,而是提齣瞭“樣本權重”和“欠采樣/過采樣”背後的統計學原理。這對我來說是一個巨大的啓發,因為在處理數百萬甚至上億級彆的數據集時,傳統的假設檢驗方法往往會因為樣本量過大而得齣“在業務上毫無意義但統計上高度顯著”的結論。這本書非常現實地指導我們如何在這種情況下設定更閤理的閾值,以及如何利用Bootstrap方法來模擬數據的抽樣分布,從而獲得更穩健的結論。它教會我,一個好的數據科學傢必須懂得何時應該相信統計檢驗的結果,何時應該聽從業務直覺,並用統計學的方法來量化這種直覺的閤理性。這種哲學層麵的指導,加上其詳盡的實操細節,使得這本書成為我工作颱麵上最常翻閱的參考書,它提供的不僅僅是知識,更是一種嚴謹的思維方式。
评分這本書的結構設計非常巧妙,它似乎是按照一個數據科學傢從接到任務到最終交付報告的完整生命周期來組織的。初學者可能會被它涵蓋的廣度稍微震懾一下,但深入閱讀後會發現,這種廣度恰恰是它最大的優點——它讓你明白,統計學不是一個孤立的模塊,而是貫穿於整個數據科學流程的底層邏輯。例如,在討論特徵選擇時,它不僅提到瞭Lasso和Ridge迴歸,還深入探討瞭特徵重要性評估中的偏倚問題,這一點非常關鍵,因為很多工具默認給齣的特徵重要性得分往往是帶有誇大成分的。我印象最深的是關於時間序列分析的部分,它沒有像傳統教材那樣大談特談ARIMA模型的復雜係數,而是聚焦於如何識彆序列的平穩性、季節性和趨勢性,以及如何利用殘差來判斷時間序列模型的擬閤優劣。這對我處理金融和電商日誌數據幫助極大。它提供瞭一個清晰的統計框架,讓我們能夠係統地評估解決方案的有效性,而不是僅僅依賴於試錯法。這本書不是讓你成為一個理論統計學傢,而是讓你成為一個更嚴謹、更不容易犯低級統計錯誤的實踐者,這一點至關重要。
评分這本書,坦率地說,簡直是為我這種在數據科學領域摸爬滾打,但理論基礎又有點虛的“實戰派”量身定做的救星。我記得剛開始接觸機器學習模型時,麵對那些動輒要求“假設正態分布”、“協方差矩陣可逆”的各種提示,簡直是丈二和尚摸不著頭腦。我能跑齣結果,但底層的邏輯就像濛著一層紗。這本書的厲害之處就在於,它沒有把我拉迴枯燥的數學係課堂去啃那些晦澀的證明,而是直接從數據科學任務的痛點齣發,比如特徵工程、模型選擇、A/B 測試的實際操作中,去講解統計學的核心概念。它會告訴你,為什麼在處理異常值時,你不能隻盯著IQR範圍看,而是要理解背後的對數轉換或魯棒性估計。讀完關於因果推斷和混雜變量處理的那幾章後,我纔真正明白,為什麼有時候模型預測準確率很高,但業務決策層卻不買賬——原來是我忽略瞭時間序列中的自相關性,或者沒有正確地對安慰劑效應進行校正。這本書的案例代碼質量極高,示例豐富到讓人覺得簡直是把一個完整的項目流程拆解給你看,從數據清洗到最終的指標解讀,每一步的統計學依據都交代得清清楚楚,這對於我這種依賴Python和R環境的工程師來說,簡直是實操手冊級彆的寶藏。它成功地架起瞭一座橋梁,讓我從一個隻會調用庫函數的“調參俠”,變成瞭一個能理解參數背後含義的“模型架構師”。
评分我必須承認,我曾經對“統計學”這個詞感到本能的抗拒,總覺得那是統計學專業人士纔需要精通的領域,對我們搞應用數據科學的來說,隻要會用`scikit-learn`裏內置的`fit()`和`predict()`就夠瞭。但當我開始深入研究高維數據和正則化方法時,我發現基礎知識的缺失嚴重限製瞭我的上限。這本書徹底顛覆瞭我的看法。它用一種極其貼近工程實踐的語言,把貝葉斯思維引入到日常的建模流程中,不再是那種冷冰冰的頻率派假設。尤其是在模型驗證和性能評估那塊,它對交叉驗證、置信區間和統計顯著性檢驗的闡述,簡直是教科書級彆的清晰。我之前一直習慣於隻看準確率(Accuracy)和F1分數,但這本書讓我開始正視混淆矩陣中每一個元素的實際業務含義,以及如何根據業務目標選擇最閤適的評估指標——比如在欺詐檢測中,漏報的代價遠高於誤報的代價,這直接影響瞭我們對召迴率和精確率的權衡。更棒的是,它沒有強迫你記住復雜的公式,而是側重於“什麼時候用這個工具”以及“用這個工具時要注意什麼陷阱”。這使得學習過程非常流暢,即便是麵對那些稍微復雜的概念,比如多重假設檢驗時的Bonferroni校正,它也能用一個簡單直觀的例子來解釋其必要性,讓人茅塞頓開。
评分作為用來準備麵試的書,很好。
评分作為用來準備麵試的書,很好。
评分作為用來準備麵試的書,很好。
评分作為用來準備麵試的書,很好。
评分作為用來準備麵試的書,很好。
相關圖書





本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有