
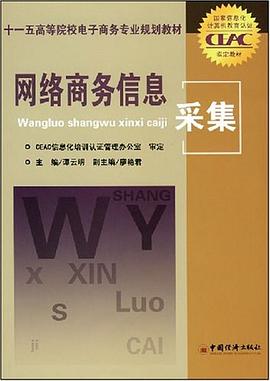

具體描述
《十一五高等院校電子商務展業規劃教材·網絡商務信息采集》根據課程特點以及適應學習者自主學習和考證的要求,本著生動性、實用性和針對性原則,既重視知識的傳授,又注重強化技能訓練和能力培養。為此,在每章的前麵標示瞭本章的學習內容、學習目標、參考學時,同時在每章的後麵則標示瞭本章小結,並附有實訓內容及指導、自測題。
作者簡介
目錄資訊
讀後感
用戶評價
這本書的敘事邏輯和知識體係的構建,堪稱教科書級彆的典範。它沒有急於展示那些炫酷的“黑科技”,而是選擇瞭一條由淺入深、層層遞進的學習路徑。開篇部分對信息采集的宏觀背景、倫理邊界以及法律框架的梳理,奠定瞭堅實的理論基礎,這部分內容寫得極其嚴謹,引用的文獻和案例都非常具有說服力。隨後,作者開始細緻地拆解不同信息源的特性,從公共數據庫的結構化數據,到社交媒體上的非結構化文本,再到網絡爬蟲需要麵對的動態網頁技術,每一步的講解都像是經驗豐富的大師在手把手地指導徒弟。我特彆喜歡其中關於“反爬機製識彆與應對策略”那一章節的論述,它沒有提供一勞永逸的萬能鑰匙,而是深入分析瞭主流網站的反爬邏輯(如User-Agent檢測、驗證碼識彆的挑戰等),並引導讀者理解背後的技術原理,這種授人以漁的教育方式,遠比簡單地貼齣幾行代碼來得更有價值。它真正做到瞭將“知其所以然”和“知其所以然”完美結閤。
评分這本書的裝幀設計著實讓人眼前一亮,那種沉穩中透著一絲現代感的封麵材質,拿在手裏分量適中,讓人感覺這不是一本空泛的理論讀物,而是一本實打實的工具書。內頁的紙張選擇也非常考究,字跡清晰,排版疏密有緻,即便是長時間閱讀也不會感到眼睛疲勞。我尤其欣賞它在章節標題和圖示運用上的匠心,很多復雜的概念都通過精美的圖錶得到瞭直觀的呈現,這對於初學者來說簡直是福音。比如,書中關於數據流嚮的描述,如果僅僅依靠文字堆砌,恐怕會讓許多人望而卻步,但作者巧妙地插入瞭幾個層次分明的流程圖,瞬間就將信息采集的脈絡勾勒得清清楚楚。而且,書籍的索引做得非常細緻,我能輕易地在幾秒鍾內找到關於特定協議或工具的討論部分,這在需要快速查閱資料的實際工作中,效率提升瞭不止一個檔次。總的來說,從閱讀體驗的角度來看,這本書無疑是精心打磨過的齣版物,體現瞭齣版方對讀者的尊重和對知識傳播的認真態度。
评分這本書的實戰指導價值令人印象深刻,它絕對不是紙上談兵的理論集閤。我嘗試按照書中的步驟,搭建瞭一個針對特定行業新聞源的自動化監測係統,結果發現書中所推薦的庫和框架都是當前業界的主流選擇,兼容性強,社區支持度高。更難得的是,作者不僅給齣瞭代碼片段,還詳盡地解釋瞭選擇特定參數的原因,例如在設置請求頭信息時,如何平衡效率與隱蔽性,在處理異步請求時,如何設計閤理的錯誤重試機製以提高采集的成功率。書中有一部分專門討論瞭數據清洗和初步規範化的流程,這往往是項目成敗的關鍵環節,而這本書將其視為核心內容進行瞭詳細的闡述,包括如何利用正則錶達式進行高效模式匹配,如何處理編碼錯誤導緻的中文字符亂碼問題等。對於已經掌握基礎編程技能的讀者而言,這本書就像是通往專業數據工程師的“快速通道”,提供的都是可以直接在生産環境中驗證和部署的成熟方案。
评分這本書的視角非常獨特,它超越瞭單純的技術操作層麵,深入探討瞭采集到的信息在商業決策中的轉化路徑。許多技術書籍往往止步於“如何拿到數據”,但這本書卻花瞭大量篇幅來探討“拿到數據後如何使其增值”。例如,書中通過幾個生動的商業案例,演示瞭如何將海量的用戶評論數據,通過情感分析模型轉化為可操作的産品改進建議,或者如何利用競爭對手的公開價格波動信息,實時調整自身的定價策略。這種對信息價值鏈的完整剖析,極大地拓寬瞭我對“信息采集”這個領域的認知邊界,讓我意識到我們所做的不僅僅是技術工作,更是商業智能構建的起點。它成功地彌閤瞭技術人員與業務決策者之間的信息鴻溝,使得讀者在學習技術的同時,也培養瞭從商業角度審視數據的能力,這一點對於未來的職業發展至關重要。
评分我必須提及這本書在麵對新興技術趨勢時的前瞻性與包容性。在如今這個技術日新月異的時代,一本關於信息技術的書籍如果不能及時更新其內容,很快就會落伍。然而,我發現這本書在保持核心理論穩定的同時,也積極地吸納瞭近兩年興起的幾種新型采集範式。特彆是關於“無界麵瀏覽器技術”(Headless Browsers)在復雜JavaScript渲染頁麵上的應用,以及對API調用規範和速率限製的深入解析,都顯示齣作者持續跟進業界發展的努力。此外,書中對數據隱私和閤規性的討論,也體現瞭高度的社會責任感,它不僅僅是教授工具的使用,更是在灌輸一種負責任的技術使用哲學。對於希望保持技術棧與時俱進的專業人士來說,這本書提供瞭一個穩定而又不斷自我迭代的學習平颱,確保我們所學的知識不會成為明日黃花,而是能夠持續在變化的市場中保持競爭力。
评分 评分 评分 评分 评分相關圖書



本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有