
具体描述
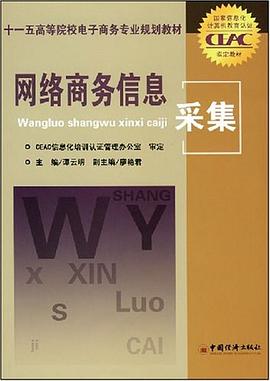
《十一五高等院校电子商务展业规划教材·网络商务信息采集》根据课程特点以及适应学习者自主学习和考证的要求,本着生动性、实用性和针对性原则,既重视知识的传授,又注重强化技能训练和能力培养。为此,在每章的前面标示了本章的学习内容、学习目标、参考学时,同时在每章的后面则标示了本章小结,并附有实训内容及指导、自测题。
作者简介
目录信息
读后感
用户评价
这本书的装帧设计着实让人眼前一亮,那种沉稳中透着一丝现代感的封面材质,拿在手里分量适中,让人感觉这不是一本空泛的理论读物,而是一本实打实的工具书。内页的纸张选择也非常考究,字迹清晰,排版疏密有致,即便是长时间阅读也不会感到眼睛疲劳。我尤其欣赏它在章节标题和图示运用上的匠心,很多复杂的概念都通过精美的图表得到了直观的呈现,这对于初学者来说简直是福音。比如,书中关于数据流向的描述,如果仅仅依靠文字堆砌,恐怕会让许多人望而却步,但作者巧妙地插入了几个层次分明的流程图,瞬间就将信息采集的脉络勾勒得清清楚楚。而且,书籍的索引做得非常细致,我能轻易地在几秒钟内找到关于特定协议或工具的讨论部分,这在需要快速查阅资料的实际工作中,效率提升了不止一个档次。总的来说,从阅读体验的角度来看,这本书无疑是精心打磨过的出版物,体现了出版方对读者的尊重和对知识传播的认真态度。
这本书的实战指导价值令人印象深刻,它绝对不是纸上谈兵的理论集合。我尝试按照书中的步骤,搭建了一个针对特定行业新闻源的自动化监测系统,结果发现书中所推荐的库和框架都是当前业界的主流选择,兼容性强,社区支持度高。更难得的是,作者不仅给出了代码片段,还详尽地解释了选择特定参数的原因,例如在设置请求头信息时,如何平衡效率与隐蔽性,在处理异步请求时,如何设计合理的错误重试机制以提高采集的成功率。书中有一部分专门讨论了数据清洗和初步规范化的流程,这往往是项目成败的关键环节,而这本书将其视为核心内容进行了详细的阐述,包括如何利用正则表达式进行高效模式匹配,如何处理编码错误导致的中文字符乱码问题等。对于已经掌握基础编程技能的读者而言,这本书就像是通往专业数据工程师的“快速通道”,提供的都是可以直接在生产环境中验证和部署的成熟方案。
我必须提及这本书在面对新兴技术趋势时的前瞻性与包容性。在如今这个技术日新月异的时代,一本关于信息技术的书籍如果不能及时更新其内容,很快就会落伍。然而,我发现这本书在保持核心理论稳定的同时,也积极地吸纳了近两年兴起的几种新型采集范式。特别是关于“无界面浏览器技术”(Headless Browsers)在复杂JavaScript渲染页面上的应用,以及对API调用规范和速率限制的深入解析,都显示出作者持续跟进业界发展的努力。此外,书中对数据隐私和合规性的讨论,也体现了高度的社会责任感,它不仅仅是教授工具的使用,更是在灌输一种负责任的技术使用哲学。对于希望保持技术栈与时俱进的专业人士来说,这本书提供了一个稳定而又不断自我迭代的学习平台,确保我们所学的知识不会成为明日黄花,而是能够持续在变化的市场中保持竞争力。
这本书的叙事逻辑和知识体系的构建,堪称教科书级别的典范。它没有急于展示那些炫酷的“黑科技”,而是选择了一条由浅入深、层层递进的学习路径。开篇部分对信息采集的宏观背景、伦理边界以及法律框架的梳理,奠定了坚实的理论基础,这部分内容写得极其严谨,引用的文献和案例都非常具有说服力。随后,作者开始细致地拆解不同信息源的特性,从公共数据库的结构化数据,到社交媒体上的非结构化文本,再到网络爬虫需要面对的动态网页技术,每一步的讲解都像是经验丰富的大师在手把手地指导徒弟。我特别喜欢其中关于“反爬机制识别与应对策略”那一章节的论述,它没有提供一劳永逸的万能钥匙,而是深入分析了主流网站的反爬逻辑(如User-Agent检测、验证码识别的挑战等),并引导读者理解背后的技术原理,这种授人以渔的教育方式,远比简单地贴出几行代码来得更有价值。它真正做到了将“知其所以然”和“知其所以然”完美结合。
这本书的视角非常独特,它超越了单纯的技术操作层面,深入探讨了采集到的信息在商业决策中的转化路径。许多技术书籍往往止步于“如何拿到数据”,但这本书却花了大量篇幅来探讨“拿到数据后如何使其增值”。例如,书中通过几个生动的商业案例,演示了如何将海量的用户评论数据,通过情感分析模型转化为可操作的产品改进建议,或者如何利用竞争对手的公开价格波动信息,实时调整自身的定价策略。这种对信息价值链的完整剖析,极大地拓宽了我对“信息采集”这个领域的认知边界,让我意识到我们所做的不仅仅是技术工作,更是商业智能构建的起点。它成功地弥合了技术人员与业务决策者之间的信息鸿沟,使得读者在学习技术的同时,也培养了从商业角度审视数据的能力,这一点对于未来的职业发展至关重要。