
具体描述
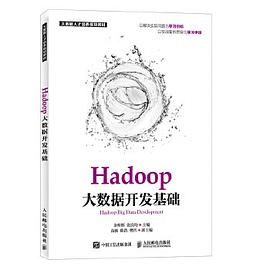
本书以任务为导向,较为全面地介绍了Hadoop大数据技术的相关知识。全书共6章,具体内容包括Hadoop介绍、Hadoop集群的搭建及配置、Hadoop基础操作、MapReduce编程入门、MapReduce进阶编程、项目案例:电影网站用户性别预测。本书的2~5章包含了实训与课后练习,通过练习和操作实践,帮助读者巩固所学的内容。
本书可以作为高校大数据技术类专业的教材,也可作为大数据技术爱好者的自学用书。
作者简介
张良均,高 级信息系统项目管理师,泰迪杯全国大学生数据挖掘竞赛(www.tipdm.org)发起人。华南师范大学、广东工业大学兼职教授,广东省工业与应用数学学会理事。兼有大型高科技企业和高校的工作经历,主要从事大数据挖掘及其应用的策划、研发及咨询培训。全国计算机技术与软件专业技术资格(水平)考试继续教育和CDA数据分析师培训讲师。发表数据挖掘相关论文数二十余篇,已取得国家发明专利12项,主编《Hadoop大数据分析与挖掘实战》《Python数据分析与挖掘实战》《R语言数据分析与挖掘实战》等多本畅销图书,主持并完成科技项目9项。获得SAS、SPSS数据挖掘认证及Hadoop开发工程师证书,具有电力、电信、银行、制造企业、电子商务和电子政务的项目经验和行业背景。
目录信息
1.1 Hadoop概述 1
1.1.1 Hadoop简介 1
1.1.2 Hadoop的发展历史 2
1.1.3 Hadoop的特点 3
1.2 Hadoop核心 4
1.2.1 分布式文件系统——HDFS 4
1.2.2 分布式计算框架——MapReduce 7
1.2.3 集群资源管理器——YARN 9
1.3 Hadoop生态系统 12
1.4 Hadoop应用场景 14
小结 15
二章 Hadoop集群的搭建及配置 16
任务2.1 安装及配置虚拟机 17
2.1.1 创建Linux虚拟机 17
2.1.2 设置固定IP 25
2.1.3 远程连接虚拟机 27
2.1.4 虚拟机在线安装软件 29
2.1.5 任务实现 32
任务2.2 安装Java 32
2.2.1 在Windows下安装Java 33
2.2.2 在Linux下安装Java 35
2.2.3 任务实现 36
任务2.3 搭建Hadoop完全分布式集群 36
2.3.1 修改配置文件 36
2.3.2 克隆虚拟机 41
2.3.3 配置SSH免密码登录 43
2.3.4 配置时间同步服务 44
2.3.5 启动关闭集群 46
2.3.6 监控集群 47
小结 50
实训 50
实训1 为Hadoop集群增加一个节点 50
实训2 编写Shell脚本同步集群时间 51
课后练习 51
第3章 Hadoop基础操作 53
任务3.1 查看Hadoop集群的基本信息 54
3.1.1 查询集群的存储系统信息 55
3.1.2 查询集群的计算资源信息 58
任务3.2 上传文件到HDFS目录 59
3.2.1 了解HDFS文件系统 59
3.2.2 掌握HDFS的基本操作 62
3.2.3 任务实现 65
任务3.3 运行MapReduce任务 67
3.3.1 了解Hadoop官方的示例程序包 67
3.3.2 提交MapReduce任务给集群运行 68
任务3.4 管理多个MapReduce任务 71
3.4.1 查询MapReduce任务 72
3.4.2 中断MapReduce任务 74
小结 76
实训 77
实训1 统计文件中所有单词的平均长度 77
实训2 查询与中断MapReduce任务 77
课后练习 78
第4章 MapReduce编程入门 80
任务4.1 使用Eclipse创建MapReduce工程 81
4.1.1 下载与安装Eclipse 81
4.1.2 配置MapReduce环境 82
4.1.3 新建MapReduce工程 84
任务4.2 通过源码初识MapReduce编程 86
4.2.1 通俗理解MapReduce原理 86
4.2.2 了解MR实现词频统计的执行流程 88
4.2.3 读懂官方提供的WordCount源码 89
任务4.3 编程实现按日期统计访问次数 94
4.3.1 分析思路与处理逻辑 94
4.3.2 编写核心模块代码 95
4.3.3 任务实现 97
任务4.4 编程实现按访问次数排序 99
4.4.1 分析思路与处理逻辑 99
4.4.2 编写核心模块代码 100
4.4.3 任务实现 102
小结 104
实训 104
实训1 获取成绩表的高分记录 104
实训2 对两个文件中的数据进行合并与去重 105
课后练习 107
第5章 MapReduce进阶编程 110
任务5.1 筛选日志文件并生成序列化文件 111
5.1.1 MapReduce输入格式 111
5.1.2 MapReduce输出格式 113
5.1.3 任务实现 113
任务5.2 Hadoop Java API读取序列化日志文件 115
5.2.1 FileSystem API管理文件夹 115
5.2.2 FileSystem API操作文件 119
5.2.3 FileSystem API读写数据 121
5.2.4 任务实现 123
任务5.3 优化日志文件统计程序 124
5.3.1 自定义键值类型 124
5.3.2 初步探索Combiner 128
5.3.3 浅析Partitioner 130
5.3.4 自定义计数器 132
5.3.5 任务实现 134
任务5.4 Eclipse提交日志文件统计程序 137
5.4.1 传递参数 137
5.4.2 Hadoop辅助类ToolRunner 139
5.4.3 Eclipse自动打包并提交任务 140
小结 144
实训 144
实训1 统计全球每年的高气温和低气温 144
实训2 筛选气温在15~25℃之间的数据 145
课后练习 146
第6章 项目案例:电影网站用户性别预测 151
任务6.1 认识KNN算法 152
6.1.1 KNN算法简介 152
6.1.2 KNN算法原理及流程 152
任务6.2 数据预处理 154
6.2.1 获取数据 154
6.2.2 数据变换 155
6.2.3 数据清洗 160
6.2.4 划分数据集 163
任务6.3 实现用户性别分类 167
6.3.1 实现思路 167
6.3.2 代码实现 169
任务6.4 评价分类结果的准确性 179
6.4.1 评价思路 179
6.4.2 实现分类评价 180
6.4.3 寻找优K值 184
小结 188
参考文献 189
· · · · · · (收起)
读后感
用户评价
我一直对分布式系统和海量数据处理抱有浓厚的兴趣,而Hadoop作为这个领域的先驱者,自然是我学习的重点。选择这本书,很大程度上是因为它的标题——“Hadoop大数据开发基础”。我希望这本书能够为我提供一个坚实的起点,让我能够系统地理解Hadoop这个庞大的技术体系。我非常想了解HDFS是如何工作的,它如何将巨大的数据分散存储在多个节点上,同时保证数据的安全性和可访问性。MapReduce编程模型是Hadoop的核心计算方式,我希望书中能够清晰地解释它的工作流程,以及如何编写高效的MapReduce程序来完成复杂的计算任务。YARN作为Hadoop 2.x引入的资源管理框架,它的出现使得Hadoop更加灵活和强大,我希望能够深入理解YARN的架构和工作原理,了解它是如何管理集群资源并调度各种计算任务的。除了Hadoop的核心组件,我也对Hadoop生态系统中一些重要的工具,如Hive、HBase、Pig、Sqoop、Flume等充满了好奇。我希望书中能够对这些工具进行介绍,说明它们各自的功能、应用场景以及如何与Hadoop集成。对我来说,一本优秀的入门书籍不仅仅是理论的堆砌,更需要有实际的指导意义。我期待书中能够提供详尽的安装配置步骤,让我能够亲手搭建一个Hadoop开发环境,并进行实际的编程练习。代码示例的质量和数量也至关重要,我希望能够看到清晰、可运行的示例代码,帮助我理解编程模型和API的使用。如果书中还能包含一些常见的大数据处理问题的解决方案,并分析其在大数据应用中的实际价值,那将是极好的。
我一直认为,要掌握一项技术,必须从它的“基础”入手,而Hadoop作为大数据领域的基石,其“基础”知识的学习至关重要。这本书的标题“Hadoop大数据开发基础”正是我所寻找的。我希望能通过这本书,系统地建立起对Hadoop整体概念的认知。我非常好奇HDFS是如何实现分布式存储的,数据是如何被分割、存储和管理的,以及它的容错机制是如何工作的。MapReduce编程模型是Hadoop的核心,我希望能够清晰地理解其工作原理,学会如何编写Map和Reduce函数来处理大规模数据集,并了解如何进行性能优化。YARN作为Hadoop 2.x版本中资源管理的创新,它如何扮演着集群“大管家”的角色,又是如何实现高效的资源调度,这些都是我非常想深入了解的。除了Hadoop的核心组件,我也对Hadoop生态系统中广泛使用的其他技术,比如Hive,我希望能学习如何用SQL来查询HDFS中的数据;HBase,了解它在实时数据访问中的应用;以及Spark,这个被广泛认为是Hadoop下一代计算框架的技术,希望能初步了解它的架构和优势。我尤其看重书中是否提供了详细的安装和配置指导,能够带领我一步步搭建一个可用的Hadoop开发环境。代码示例的质量和实用性对我来说也非常重要,我希望看到能够直接运行并解决实际问题的代码片段。如果书中还能提供一些大数据开发的最佳实践和常见问题的解决方法,那将是非常宝贵的财富,能够帮助我少走弯路,更快地成长为一名合格的大数据开发者。
我最近在研究如何将我手上现有的数据分析流程迁移到分布式计算环境中,尤其是在处理 TB 级别的数据集时,传统的单机分析工具已经显得捉襟见肘,效率低下。身边有朋友推荐了Hadoop,但坦白说,我对这个技术栈一直有些敬畏,感觉它非常庞大和复杂,入门门槛很高。在选书的时候,我特别留意了那些标题里带有“基础”或者“入门”字样的书籍,因为我需要一个能够让我逐步建立起对Hadoop整体认识的框架。这本书吸引我的地方在于它的“基础”二字,这让我相信它不会上来就抛出一堆我根本看不懂的专业术语和复杂的架构图。我希望能通过这本书,系统地了解Hadoop的核心组成部分,比如分布式文件系统(HDFS)是如何工作的,数据是如何存储和管理的,以及MapReduce模型是如何进行并行计算的。我也很想知道YARN(Yet Another Resource Negotiator)在整个Hadoop集群中的作用,它又是如何调度和管理计算资源的。更重要的是,我希望这本书能提供一些实际操作的指导,例如如何搭建一个简单的Hadoop集群,如何编写第一个MapReduce程序,以及如何调试和优化我的MapReduce作业。此外,我也希望这本书能介绍一些Hadoop生态系统中常用的工具,比如Hive,它能让我用类SQL的语法来查询HDFS中的数据,这对我来说非常有吸引力。了解HBase,一个分布式、面向列的NoSQL数据库,也对我的项目非常有帮助,因为它能够支持大规模的实时读写。我期待这本书能够提供足够详细的配置步骤和代码示例,让我能够边学边练,将理论知识转化为实际技能。我深信,通过这本书的学习,我能够克服对Hadoop的畏难情绪,逐步掌握这项强大的技术,为我解决当前数据处理的瓶颈提供一条有效的途径。
作为一名对技术发展趋势保持高度关注的开发者,我深知在大数据时代,掌握Hadoop技术的重要性。我选择这本书,是因为它清晰地标示了“Hadoop大数据开发基础”这个定位,这意味着它会从最根本的知识点出发,为我构建起对Hadoop的全面认识。我期待它能够深入浅出地讲解Hadoop的架构设计,包括NameNode、DataNode、ResourceManager、NodeManager等核心组件的职责与协作。对于HDFS,我希望能理解其分布式存储的原理,包括数据块的划分、副本策略以及如何保证数据的高可用性和容错性。MapReduce作为Hadoop的计算模型,我希望能学习其编程范式,理解Map和Reduce函数的编写,以及如何通过这种模型处理海量数据。YARN在Hadoop 2.x中的引入,极大地提升了Hadoop的灵活性和资源利用率,我希望能详细了解YARN的架构,包括它如何进行资源调度和应用程序管理。此外,我对Hadoop生态系统中其他重要的技术,如Hive(用于数据仓库和SQL查询)、HBase(分布式列存储)、Spark(内存计算引擎)等也充满兴趣,希望书中能够对这些技术进行介绍,说明它们各自的特点、优势以及在Hadoop体系中的应用。我尤其看重书中是否提供了实践性的指导,例如如何从零开始搭建Hadoop开发环境,包括安装、配置和验证。代码示例的质量和可读性对我来说非常重要,我希望能够看到清晰、注释详尽的示例代码,帮助我理解各种API和开发模式。如果书中能包含一些实际的数据处理案例,并展示如何利用Hadoop解决这些问题,那将极大地提升我的学习效果,让我能够更快地将所学知识应用于实际工作中,从而在这个充满机遇的大数据领域中占据一席之地。
作为一名对新兴技术充满好奇心的开发者,我一直在关注大数据领域的发展,而Hadoop无疑是这个领域中绕不开的基石。我选择这本书,更多的是因为它承诺能够提供“基础”层面的知识。我之前接触过一些关于大数据处理的零散信息,但总觉得不够系统,很多概念就像浮在水面一样,抓不住重点。特别是Hadoop的分布式特性,让我感到既神奇又有点不知所措。我希望这本书能够像一位经验丰富的向导,带我一步步走入Hadoop的世界。我期待它能清晰地解释Hadoop的核心概念,比如分布式存储的原理,数据在HDFS中的冗余和容错机制,以及MapReduce编程模型的设计思想,包括Map和Reduce阶段是如何协同工作的。更让我感兴趣的是,我希望这本书能够深入浅出地介绍YARN,它是如何管理集群资源,如何确保应用程序的顺畅运行。除了核心组件,我也非常渴望了解Hadoop生态系统中其他关键技术,例如Hive,我一直想学习如何使用SQL来查询海量数据;HBase,我想知道它在什么场景下能够发挥巨大的作用;以及Spark,这个被誉为Hadoop下一代的计算引擎,它的性能优势在哪里,又该如何与Hadoop结合使用。我特别看重书中是否提供了详尽的配置指南,例如如何部署和配置一个Hadoop集群,从最简单的单节点模式到更复杂的伪分布式和完全分布式模式。代码示例更是不可或缺,我希望能看到实际的MapReduce程序编写,以及如何使用HiveQL和Spark API进行数据分析。如果书中还能包含一些实际应用场景的案例分析,那将是锦上添花,能够帮助我更好地理解Hadoop在解决实际业务问题中的价值。这本书的出现,为我系统学习Hadoop提供了一个坚实的起点,我对此充满期待。
在当前快速发展的技术浪潮中,大数据已经成为各行各业不可忽视的关键要素。我所在的团队正在积极探索如何利用Hadoop来优化我们的数据处理和分析流程,尤其是在面对日益增长的数据量时,如何实现高效、可扩展的数据存储和计算。我选择这本书,是因为它明确地指向了“Hadoop大数据开发基础”,这正是我们团队目前最迫切需要的内容。我期待这本书能够为我们提供一个清晰、系统性的Hadoop学习路径,让我们能够从根本上理解Hadoop的架构和核心组件。具体来说,我希望它能够深入讲解HDFS的工作原理,包括数据块的划分、副本机制、NameNode和DataNode的角色,以及如何保证数据的可靠性和可用性。MapReduce编程模型是Hadoop进行分布式计算的基础,我希望书中能够提供详细的讲解,包括Map和Reduce函数的编写规范,以及如何设计高效的算法来处理大规模数据集。YARN作为Hadoop 2.x版本中的资源管理器,它的出现极大地提高了Hadoop集群的灵活性和效率,我希望书中能够详细介绍YARN的架构,包括 ResourceManager、NodeManager、ApplicationMaster 和 Container 的概念,以及它是如何实现资源分配和作业调度的。除了Hadoop的核心组件,我也对Hadoop生态系统中其他重要技术,如Hive、HBase、Spark等非常感兴趣,希望书中能够简要介绍这些技术的定位和应用场景,以及它们与Hadoop的集成方式。我尤其看重书中是否能提供实际操作的指导,例如如何搭建一个Hadoop集群,如何部署和配置相关的服务,以及如何编写和运行MapReduce程序。如果书中能包含一些典型的企业级应用案例,并分析其在大数据处理中的优势和挑战,那将对我们团队的决策和实践有重要的参考价值。
随着数据量的爆炸式增长,传统的单机处理方式已经难以满足需求,因此,学习Hadoop这样的分布式计算技术势在必行。我选择这本书,是因为它的书名“Hadoop大数据开发基础”直接点明了它所涵盖的内容,我期望它能为我打下扎实的大数据开发基础。我希望书中能够清晰地介绍Hadoop的整体架构,以及构成这个架构的各个核心组件,比如HDFS,它如何实现分布式存储,又是如何保证数据的可靠性和可用性的。MapReduce编程模型是Hadoop的核心计算框架,我希望能够通过这本书学习如何编写MapReduce程序,理解其Map和Reduce阶段的设计理念,以及如何优化MapReduce作业以获得更好的性能。YARN作为Hadoop 2.x引入的资源管理系统,它扮演着怎样的角色,又是如何有效地管理集群资源,这些都是我非常想深入了解的内容。除了Hadoop本身,我也对Hadoop生态系统中的其他重要技术,如Hive(用于数据仓库)、HBase(分布式数据库)、Spark(内存计算框架)等充满了好奇。我希望书中能够对这些技术进行简要介绍,说明它们各自的特点和应用场景,以及如何与Hadoop协同工作。对我来说,一本优秀的入门书籍需要包含详尽的安装和配置步骤,能够指导我搭建一个完整的Hadoop开发环境。代码示例的质量和数量也至关重要,我希望看到清晰、可运行的示例代码,能够帮助我理解概念并进行实践。如果书中还能包含一些大数据开发的常见问题和解决方案,那将非常有价值,能够帮助我少走弯路,更快地掌握Hadoop大数据开发技能。
在数字化浪潮席卷全球的今天,大数据处理和分析能力已经成为企业核心竞争力的重要组成部分。我所在的团队正面临着海量数据的处理挑战,而Hadoop作为业界领先的分布式计算框架,是我们探索的方向。我选择这本书,是因为它提供了“Hadoop大数据开发基础”的系统性讲解,这正是我们团队成员急需的。我期待书中能够详细阐述Hadoop的核心架构,包括HDFS、MapReduce和YARN等关键组件的设计理念和工作机制。对于HDFS,我希望能理解其高可用性、容错性和数据冗余是如何实现的,以及如何在实际环境中进行有效的存储管理。MapReduce模型是Hadoop的计算基石,我希望能学习如何编写高效的MapReduce程序,理解其中的Map和Reduce阶段是如何协同工作的,并掌握一些调优技巧来提升计算性能。YARN作为Hadoop 2.x推出的资源管理器,其在集群资源分配、调度和应用管理方面的作用,是我非常想深入了解的。此外,我也对Hadoop生态系统中其他重要的技术,如Hive、HBase、Spark等充满兴趣,希望书中能够介绍这些技术的定位、功能以及它们如何与Hadoop进行集成,以构建完整的解决方案。我尤其看重书中是否能提供详细的安装部署指南,以及实际的代码示例,能够帮助团队成员快速上手,并在实际项目中进行应用。如果书中能包含一些实际的案例分析,展示Hadoop在不同行业中的应用场景和解决方案,那将极大地提升我们团队对Hadoop技术价值的认识,并为我们制定具体的大数据战略提供有力的参考。
我是一名刚刚接触大数据领域的初学者,在了解了Hadoop在处理海量数据方面的强大能力后,我迫切地需要一本能够指引我入门的书籍。这本书的标题“Hadoop大数据开发基础”正是瞄准了我这样的需求。我希望它能够从最基础的概念讲起,逐步引导我理解Hadoop的整体架构和工作原理。我对HDFS(Hadoop Distributed File System)的分布式存储机制充满好奇,想知道它是如何实现高可用性和容错性的。MapReduce模型是Hadoop的核心计算框架,我希望能学习到它的编程模型,理解Map和Reduce函数是如何工作的,以及如何设计高效的MapReduce作业。YARN(Yet Another Resource Negotiator)作为Hadoop的资源管理器,它的作用是什么,如何管理集群中的计算资源,这些都是我非常想了解的内容。此外,我对Hadoop生态系统中的其他组件,如Hive、HBase、Spark等也很有兴趣。我希望这本书能够简要介绍这些组件的功能和用途,以及它们是如何与Hadoop协同工作的。对我来说,一个好的入门书籍应该包含清晰的概念讲解,大量的图示来帮助理解复杂的架构,以及实际的操作步骤和代码示例。我希望这本书能够提供从零开始搭建Hadoop开发环境的详细指导,包括软件的安装、配置和验证。如果书中还能提供一些常见的Hadoop开发场景,并给出相应的解决方案,那对我来说将是巨大的帮助。我希望通过阅读这本书,能够建立起对Hadoop的全面认识,掌握基本的Hadoop开发技能,为我进一步深入学习和应用大数据技术打下坚实的基础。
这本书的装帧设计很简洁大气,封面上的Hadoop logo和“大数据开发基础”几个大字,在书架上显得尤为醒目。拿到手里,份量十足,让人感觉内容一定相当厚实,也寄予了我很大的期望。我之所以选择这本书,是因为我当前的工作内容和大数据技术息息相关,但在此之前,我对于Hadoop的理解还停留在非常表面的层面,知道它是个分布式计算框架,但具体如何搭建、如何开发,如何优化,对我来说都是一片空白。我尝试过阅读一些零散的网络文章,但往往碎片化严重,缺乏系统性,而且很多技术更新迭代很快,旧的文章可能已经不再适用。我希望找到一本能够从零开始,系统地讲解Hadoop技术栈,并且能够指导我实际操作的书籍。这本书的标题“Hadoop大数据开发基础”正好符合了我的需求,它承诺了“基础”,意味着它会从最根本的概念讲起,循序渐进,不会让我因为理解不了前置知识而卡壳。同时,“大数据开发”的字眼也表明了它不仅仅是理论介绍,更会涉及到实际的开发应用,这正是我最看重的部分。我迫切地希望通过这本书,能够掌握Hadoop的核心组件,比如HDFS、MapReduce、YARN等,理解它们的工作原理,并且学习如何使用它们来处理和分析海量数据。此外,我对Hadoop生态系统中其他重要的工具,如Hive、HBase、Spark等,也充满好奇,希望这本书能为我打开认识这些工具的大门,了解它们在Hadoop体系中的作用以及如何与Hadoop结合使用。我非常期待在阅读过程中,能够遇到清晰易懂的讲解,丰富的代码示例,以及有指导意义的实践案例,这对我来说将是无价的财富,能够帮助我快速提升在大数据开发领域的实战能力,从而更好地应对工作中的挑战,为公司创造更多的价值。这本书的出现,就像是在我迷茫的大数据学习之路上点亮了一盏指路明灯,让我看到了前进的方向和清晰的路径,对此我充满信心和期待。
Hadoop是一个由Apache基金会所开发的可靠的、可扩展的用于分布式计算的分布式系统基础架构和开发开源软件。Apache Hadoop软件库是一个框架,允许使用简单的编程模型在计算机集群中对大规模数据集进行分布式处理。它的目的是从单一的服务器扩展到成千上万的机器,将集群部署在多台机器中,每台机器提供本地计算和存储,并且将存储的数据备份在多个节点,由此提升集群的可用性,而不是通过硬件提升。当一台机器宕机时,其他节点依然可以提供备份数据和计算服务。 Hadoop框架最核心的设计是HDFS(Hadoop Distributed File System)和MapReduce。HDFS是可扩展、高容错、高性能的分布式文件系统,负责数据的分布式存储和备份,文件写入后只能读取,不能修改。MapRed
Hadoop是一个由Apache基金会所开发的可靠的、可扩展的用于分布式计算的分布式系统基础架构和开发开源软件。Apache Hadoop软件库是一个框架,允许使用简单的编程模型在计算机集群中对大规模数据集进行分布式处理。它的目的是从单一的服务器扩展到成千上万的机器,将集群部署在多台机器中,每台机器提供本地计算和存储,并且将存储的数据备份在多个节点,由此提升集群的可用性,而不是通过硬件提升。当一台机器宕机时,其他节点依然可以提供备份数据和计算服务。 Hadoop框架最核心的设计是HDFS(Hadoop Distributed File System)和MapReduce。HDFS是可扩展、高容错、高性能的分布式文件系统,负责数据的分布式存储和备份,文件写入后只能读取,不能修改。MapRed
Hadoop是一个由Apache基金会所开发的可靠的、可扩展的用于分布式计算的分布式系统基础架构和开发开源软件。Apache Hadoop软件库是一个框架,允许使用简单的编程模型在计算机集群中对大规模数据集进行分布式处理。它的目的是从单一的服务器扩展到成千上万的机器,将集群部署在多台机器中,每台机器提供本地计算和存储,并且将存储的数据备份在多个节点,由此提升集群的可用性,而不是通过硬件提升。当一台机器宕机时,其他节点依然可以提供备份数据和计算服务。 Hadoop框架最核心的设计是HDFS(Hadoop Distributed File System)和MapReduce。HDFS是可扩展、高容错、高性能的分布式文件系统,负责数据的分布式存储和备份,文件写入后只能读取,不能修改。MapRed
Hadoop是一个由Apache基金会所开发的可靠的、可扩展的用于分布式计算的分布式系统基础架构和开发开源软件。Apache Hadoop软件库是一个框架,允许使用简单的编程模型在计算机集群中对大规模数据集进行分布式处理。它的目的是从单一的服务器扩展到成千上万的机器,将集群部署在多台机器中,每台机器提供本地计算和存储,并且将存储的数据备份在多个节点,由此提升集群的可用性,而不是通过硬件提升。当一台机器宕机时,其他节点依然可以提供备份数据和计算服务。 Hadoop框架最核心的设计是HDFS(Hadoop Distributed File System)和MapReduce。HDFS是可扩展、高容错、高性能的分布式文件系统,负责数据的分布式存储和备份,文件写入后只能读取,不能修改。MapRed
Hadoop是一个由Apache基金会所开发的可靠的、可扩展的用于分布式计算的分布式系统基础架构和开发开源软件。Apache Hadoop软件库是一个框架,允许使用简单的编程模型在计算机集群中对大规模数据集进行分布式处理。它的目的是从单一的服务器扩展到成千上万的机器,将集群部署在多台机器中,每台机器提供本地计算和存储,并且将存储的数据备份在多个节点,由此提升集群的可用性,而不是通过硬件提升。当一台机器宕机时,其他节点依然可以提供备份数据和计算服务。 Hadoop框架最核心的设计是HDFS(Hadoop Distributed File System)和MapReduce。HDFS是可扩展、高容错、高性能的分布式文件系统,负责数据的分布式存储和备份,文件写入后只能读取,不能修改。MapRed