
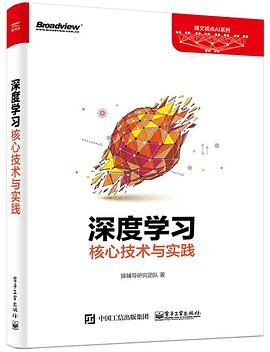

具体描述
《深度学习核心技术与实践》主要介绍深度学习的核心算法,以及在计算机视觉、语音识别、自然语言处理中的相关应用。《深度学习核心技术与实践》的作者们都是业界一线的深度学习从业者,所以书中所写内容和业界联系紧密,所涵盖的深度学习相关知识点比较全面。《深度学习核心技术与实践》主要讲解原理,较少贴代码。
《深度学习核心技术与实践》适合深度学习从业人士或者相关研究生作为参考资料,也可以作为入门教程来大致了解深度学习的相关前沿技术。
作者简介
猿辅导应用研究团队成立于2014年年中,一直从事深度学习在教育领域的应用和研究工作。团队成员均毕业于北京大学、清华大学、上海交大、中科院、香港大学等知名高校,大多数拥有硕士或博士学位。研究方向涵盖了图像识别、语音识别、自然语言理解、数据挖掘、深度学习等领域。团队成功运用深度学习技术,从零开始打造出活跃用户过亿的拍照搜题APP——小猿搜题,开源了分布式机器学习系统ytk-learn和分布式通信系统ytk-mp4j。此外,团队自主研发的一系列成果均成功应用到猿辅导公司的产品中。包括:速算应用中的在线手写识别、古诗词背诵中的语音识别、英语口语智能批改、英文手写拍照识别和英语作文智能批改等技术。
目录信息
1 概述2
1.1 人工智能 3
1.1.1 人工智能的分类 3
1.1.2 人工智能发展史 3
1.2 机器学习 7
1.2.1 机器学习的由来 7
1.2.2 机器学习发展史 9
1.2.3 机器学习方法分类 10
1.2.4 机器学习中的基本概念 11
1.3 神经网络 12
1.3.1 神经网络发展史 13
参考文献 16
2 神经网络17
2.1 在神经科学中对生物神经元的研究 17
2.1.1 神经元激活机制 17
2.1.2 神经元的特点 18
2.2 神经元模型 19
2.2.1 线性神经元 19
2.2.2 线性阈值神经元 19
2.2.3 Sigmoid 神经元 21
2.2.4 Tanh 神经元 22
2.2.5 ReLU 22
2.2.6 Maxout 24
2.2.7 Softmax 24
2.2.8 小结 25
2.3 感知机 27
2.3.1 感知机的提出 27
2.3.2 感知机的困境 28
2.4 DNN 29
2.4.1 输入层、输出层及隐层 30
2.4.2 目标函数的选取 30
2.4.3 前向传播 32
2.4.4 后向传播 33
2.4.5 参数更新 35
2.4.6 神经网络的训练步骤 36
参考文献 36
3 初始化模型38
3.1 受限玻尔兹曼机 38
3.1.1 能量模型 39
3.1.2 带隐藏单元的能量模型 40
3.1.3 受限玻尔兹曼机基本原理 41
3.1.4 二值RBM 43
3.1.5 对比散度 45
3.2 自动编码器 47
3.2.1 稀疏自动编码器 48
3.2.2 降噪自动编码器 48
3.2.3 栈式自动编码器 49
3.3 深度信念网络 50
参考文献 52
4 卷积神经网络53
4.1 卷积算子 53
4.2 卷积的特征 56
4.3 卷积网络典型结构 59
4.3.1 基本网络结构 59
4.3.2 构成卷积神经网络的层 59
4.3.3 网络结构模式 60
4.4 卷积网络的层 61
4.4.1 卷积层 61
4.4.2 池化层 66
参考文献 67
5 循环神经网络68
5.1 循环神经网络简介 68
5.2 RNN、LSTM 和GRU 69
5.3 双向RNN 76
5.4 RNN 语言模型的简单实现 77
参考文献 80
6 深度学习优化算法81
6.1 SGD 81
6.2 Momentum 82
6.3 NAG 83
6.4 Adagrad 85
6.5 RMSProp 86
6.6 Adadelta 87
6.7 Adam 88
6.8 AdaMax 90
6.9 Nadam 90
6.10 关于优化算法的使用 92
参考文献 92
7 深度学习训练技巧94
7.1 数据预处理 94
7.2 权重初始化 95
7.3 正则化 96
7.3.1 提前终止 96
7.3.2 数据增强 96
7.3.3 L2/L1 参数正则化 98
7.3.4 集成 100
7.3.5 Dropout 101
参考文献 102
8 深度学习框架103
8.1 Theano 103
8.1.1 Theano 103
8.1.2 安装 104
8.1.3 计算图 104
8.2 Torch 105
8.2.1 概述 105
8.2.2 安装 106
8.2.3 核心结构 107
8.2.4 小试牛刀 110
8.3 PyTorch 113
8.3.1 概述 113
8.3.2 安装 113
8.3.3 核心结构 114
8.3.4 小试牛刀 114
8.4 Caffe 117
8.4.1 概述 117
8.4.2 安装 118
8.4.3 核心组件 119
8.4.4 小试牛刀 125
8.5 TensorFlow 125
8.5.1 概述 125
8.5.2 安装 126
8.5.3 核心结构 126
8.5.4 小试牛刀 127
8.6 MXNet 131
8.6.1 概述 131
8.6.2 安装 131
8.6.3 核心结构 132
8.6.4 小试牛刀 133
8.7 Keras 135
8.7.1 概述 135
8.7.2 安装 136
8.7.3 模块介绍 136
8.7.4 小试牛刀 136
参考文献 139
第2 部分计算机视觉篇140
9 计算机视觉背景141
9.1 传统计算机视觉 141
9.2 基于深度学习的计算机视觉 145
9.3 参考文献 146
10 图像分类模型147
10.1 LeNet-5 147
10.2 AlexNet 149
10.3 VGGNet 154
10.3.1 网络结构 155
10.3.2 配置 157
10.3.3 讨论 157
10.3.4 几组实验 158
10.4 GoogLeNet 159
10.4.1 NIN 161
10.4.2 GoogLeNet 的动机 161
10.4.3 网络结构细节 162
10.4.4 训练方法 164
10.4.5 后续改进版本 165
10.5 ResNet 165
10.5.1 基本思想 165
10.5.2 网络结构 167
10.6 DenseNet 169
10.7 DPN 170
参考文献 170
11 目标检测173
11.1 相关研究 175
11.1.1 选择性搜索 175
11.1.2 OverFeat 177
11.2 基于区域提名的方法 179
11.2.1 R-CNN 179
11.2.2 SPP-net 181
11.2.3 Fast R-CNN 182
11.2.4 Faster R-CNN 184
11.2.5 R-FCN 185
11.3 端到端的方法 186
11.3.1 YOLO 186
11.3.2 SSD 187
11.4 小结 188
参考文献 190
12 语义分割192
12.1 全卷积网络 193
12.1.1 FCN 193
12.1.2 DeconvNet 195
12.1.3 SegNet 197
12.1.4 DilatedConvNet 198
12.2 CRF/MRF 的使用 199
12.2.1 DeepLab 199
12.2.2 CRFasRNN 201
12.2.3 DPN 203
12.3 实例分割 205
12.3.1 Mask R-CNN 205
参考文献 206
13 图像检索的深度哈希编码208
13.1 传统哈希编码方法 208
13.2 CNNH 209
13.3 DSH 210
13.4 小结 212
参考文献 212
第3 部分语音识别篇214
14 传统语音识别基础215
14.1 语音识别简介 215
14.2 HMM 简介 216
14.2.1 HMM 是特殊的混合模型 218
14.2.2 转移概率矩阵 219
14.2.3 发射概率 220
14.2.4 Baum-Welch 算法 220
14.2.5 后验概率 224
14.2.6 前向-后向算法 224
14.3 HMM 梯度求解 227
14.3.1 梯度算法1 228
14.3.2 梯度算法2 230
14.3.3 梯度求解的重要性 234
14.4 孤立词识别 234
14.4.1 特征提取 234
14.4.2 孤立词建模 235
14.4.3 GMM-HMM 237
14.5 连续语音识别 240
14.6 Viterbi 解码 243
14.7 三音素状态聚类 245
14.8 判别式训练 248
参考文献 254
15 基于WFST 的语音解码256
15.1 有限状态机 257
15.2 WFST 及半环定义 257
15.2.1 WFST 257
15.2.2 半环(Semiring) 258
15.3 自动机操作 260
15.3.1 自动机基本操作 261
15.3.2 转换器基本操作 262
15.3.3 优化操作 265
15.4 基于WFST 的语音识别系统 277
15.4.1 声学模型WFST 279
15.4.2 三音素WFST 281
15.4.3 发音字典WFST 281
15.4.4 语言模型WFST 282
15.4.5 WFST 组合和优化 284
15.4.6 组合和优化实验 285
15.4.7 WFST 解码 286
参考文献 287
16 深度语音识别288
16.1 CD-DNN-HMM 288
16.2 TDNN 292
16.3 CTC 295
16.4 EESEN 299
16.5 Deep Speech 301
16.6 Chain 310
参考文献 313
17 CTC 解码315
17.1 序列标注 315
17.2 序列标注任务的解决办法 316
17.2.1 序列分类 316
17.2.2 分割分类 317
17.2.3 时序分类 318
17.3 隐马模型 318
17.4 CTC 基本定义 319
17.5 CTC 前向算法 321
17.6 CTC 后向算法 324
17.7 CTC 目标函数 325
17.8 CTC 解码基本原理 327
17.8.1 最大概率路径解码 327
17.8.2 前缀搜索解码 328
17.8.3 约束解码 329
参考文献 333
第4 部分自然语言处理篇334
18 自然语言处理简介335
18.1 NLP 的难点 335
18.2 NLP 的研究范围 336
19 词性标注338
19.1 传统词性标注模型 338
19.2 基于神经网络的词性标注模型 340
19.3 基于Bi-LSTM 的神经网络词性标注模型 342
参考文献 344
20 依存句法分析345
20.1 背景 346
20.2 SyntaxNet 技术要点 348
20.2.1 Transition-based 系统 349
20.2.2 “模板化” 技术 353
20.2.3 Beam Search 355
参考文献 357
21 word2vec 358
21.1 背景 359
21.1.1 词向量 359
21.1.2 统计语言模型 359
21.1.3 神经网络语言模型 362
21.1.4 Log-linear 模型 364
21.1.5 Log-bilinear 模型 365
21.1.6 层次化Log-bilinear 模型 365
21.2 CBOW 模型 366
21.3 Skip-gram 模型 369
21.4 Hierarchical Softmax 与Negative Sampling 371
21.5 fastText 372
21.6 GloVe 373
21.7 小结 374
参考文献 374
22 神经网络机器翻译376
22.1 机器翻译简介 376
22.2 神经网络机器翻译基本模型 377
22.3 基于Attention 的神经网络机器翻译 379
22.4 谷歌机器翻译系统GNMT 381
22.5 基于卷积的机器翻译 382
22.6 小结 383
参考文献 384
第5 部分深度学习研究篇385
23 Batch Normalization 386
23.1 前向与后向传播 387
23.1.1 前向传播 387
23.1.2 后向传播 390
23.2 有效性分析 393
23.2.1 内部协移 393
23.2.2 梯度流 393
23.3 使用与优化方法 395
23.4 小结 396
参考文献 396
24 Attention 397
24.1 从简单RNN 到RNN + Attention 398
24.2 Soft Attention 与Hard Attention 398
24.3 Attention 的应用 399
24.4 小结 401
参考文献 402
25 多任务学习403
25.1 背景 403
25.2 什么是多任务学习 404
25.3 多任务分类与其他分类概念的关系 406
25.3.1 二分类 406
25.3.2 多分类 407
25.3.3 多标签分类 407
25.3.4 相关关系 408
25.4 多任务学习如何发挥作用 409
25.4.1 提高泛化能力的潜在原因 410
25.4.2 多任务学习机制 410
25.4.3 后向传播多任务学习如何发现任务是相关的 412
25.5 多任务学习被广泛应用 413
25.5.1 使用未来预测现在 413
25.5.2 多种表示和度量 413
25.5.3 时间序列预测 413
25.5.4 使用不可操作特征 414
25.5.5 使用额外任务来聚焦 414
25.5.6 有序迁移 414
25.5.7 多个任务自然地出现 414
25.5.8 将输入变成输出 414
25.6 多任务深度学习应用 416
25.6.1 脸部特征点检测 416
25.6.2 DeepID2 418
25.6.3 Fast R-CNN 419
25.6.4 旋转人脸网络 420
25.6.5 实例感知语义分割的MNC 422
25.7 小结 423
参考文献 425
26 模型压缩426
26.1 模型压缩的必要性 426
26.2 较浅的网络 428
26.3 剪枝 428
26.4 参数共享 434
26.5 紧凑网络 437
26.6 二值网络 438
26.7 小结 442
参考文献 442
27 增强学习445
27.1 什么是增强学习 445
27.2 增强学习的数学表达形式 448
27.2.1 MDP 449
27.2.2 策略函数 450
27.2.3 奖励与回报 450
27.2.4 价值函数 452
27.2.5 贝尔曼方程 453
27.2.6 最优策略性质 453
27.3 用动态规划法求解增强学习问题 454
27.3.1 Agent 的目标 454
27.3.2 策略评估 455
27.3.3 策略改进 456
27.3.4 策略迭代 457
27.3.5 策略迭代的例子 458
27.3.6 价值迭代 459
27.3.7 价值迭代的例子 461
27.3.8 策略函数和价值函数的关系 462
27.4 无模型算法 462
27.4.1 蒙特卡罗法 463
27.4.2 时序差分法 465
27.4.3 Q-Learning 466
27.5 Q-Learning 的例子 467
27.6 AlphaGo 原理剖析 469
27.6.1 围棋与机器博弈 469
27.6.2 Alpha-Beta 树 472
27.6.3 MCTS 473
27.6.4 UCT 476
27.6.5 AlphaGo 的训练策略 478
27.6.6 AlphaGo 的招式搜索算法 482
27.6.7 围棋的对称性 484
27.7 AlphaGo Zero 484
参考文献 484
28 GAN 486
28.1 生成模型 486
28.2 生成对抗模型的概念 488
28.3 GAN 实战 492
28.4 InfoGAN——探寻隐变量的内涵 493
28.5 Image-Image Translation 496
28.6 WGAN(Wasserstein GAN) 499
28.6.1 GAN 目标函数的弱点 500
28.6.2 Wasserstein 度量的优势 501
28.6.3 WGAN 的目标函数 504
参考文献 505
A 本书涉及的开源资源列表 506
· · · · · · (收起)
读后感
用户评价
这本书最打动我的一点,是它对“不确定性”的探讨。在如今这个AI领域日新月异的时代,很多技术很快就会过时,但对底层原理和不确定性量化的理解是永恒的。书中专门辟了一个章节讨论贝叶斯深度学习的基本思想,这在许多入门或中级书籍中是极其罕见的。它引导读者思考,模型给出的预测结果,其背后隐藏的置信度究竟是多少。这种对模型“知道自己不知道”的探究,极大地提升了整个技术体系的可靠性。此外,作者在案例分析中,也强调了模型的可解释性(XAI)的重要性,展示了如何用SHAP值或LIME等工具去剖析决策过程,而不是仅仅依赖准确率的数字。这让我意识到,未来的AI工程师不仅要会训练模型,更要懂得如何向业务方“解释”模型,这本书为我提供了必要的思维框架和工具储备。
评分说实话,我对市面上那些动辄宣称“一小时精通XX”的书籍已经有点审美疲劳了。这本书给我的感觉是截然不同的——它非常“慢热”,但后劲十足。开篇花了大量的篇幅在优化算法和损失函数的选择上做深入探讨,这一点非常重要,因为在实际项目中,模型结构设计往往不如调参和收敛过程来得折磨人。作者并没有直接抛出最新的Transformer架构,而是先用最原始的感知机和反向传播算法把脉络讲透。我记得有一次我被一个梯度消失的问题困扰了很久,这本书里关于激活函数选择和梯度流的分析,竟然奇迹般地帮我找到了症结所在。它不是那种堆砌代码片段的书,代码只是辅助理解的工具,重点全在于背后的数学逻辑和工程考量。阅读过程中,我不得不经常停下来,拿起草稿纸推导公式,这过程虽然累,但带来的那种“我理解了”的成就感是无与伦比的。
评分这本书的结构安排着实体现了作者深厚的行业经验。它没有拘泥于某一个特定的深度学习框架,比如TensorFlow或者PyTorch的最新版本特性,而是将重点放在了那些跨越框架限制的通用知识上。我特别喜欢它关于数据预处理和特征工程的章节,这部分在很多同类书中经常被一带而过,但实际上,数据质量决定了模型上限。作者详尽地介绍了不同类型数据(图像、文本、序列)的最佳实践,包括如何应对数据不平衡、如何进行有效的正则化处理,这些都是实战中经常遇到的“硬骨头”。读到后面关于模型部署和性能评估的部分,作者的笔锋一转,开始探讨计算资源限制下的模型压缩和量化技术,这让我意识到,深度学习不仅仅是实验室里的玩具,它必须落地到实际产品中才能发挥价值。这种由理论到实践,再到工程优化的完整闭环思考,是这本书最大的亮点。
评分这本书的封面设计挺有意思的,那种深邃的蓝色调和简约的排版,一下子就抓住了我的眼球。我一直觉得,技术类的书籍如果能兼顾美感和内容深度,那绝对是加分项。拿到手里沉甸甸的,感觉内容肯定很扎实。我原本是冲着那些时髦的AI名词去的,但翻开目录后才发现,作者似乎更注重打地基,从最基础的数学原理和算法推导讲起。这对我这种喜欢刨根问底的人来说简直是福音。我尤其欣赏作者在解释那些复杂概念时,总能找到非常形象的比喻,比如他把神经网络的层级结构比作工厂的流水线,每一层都有特定的加工任务,这让那些抽象的计算过程变得可视化了许多。而且,书中穿插的不少早期经典论文的解读,也让我对深度学习的发展脉络有了更清晰的认识,而不是仅仅停留在“用模型”的层面。我感觉这不是一本速成手册,更像是一本值得反复研读的工具书,每次翻开都能发现新的领悟。
评分我是一个偏爱逻辑严谨和论证充分的读者,这本书在这方面做得相当出色。它不像某些教材那样,在介绍完理论后就直接跳到成功的案例,而是非常坦诚地讨论了各种主流模型(比如CNN、RNN)在面对特定挑战时的局限性。比如,它没有把卷积神经网络描绘成万能钥匙,而是深入分析了它在处理旋转不变性和尺度变化时的内在缺陷,并顺势引出了更现代的注意力机制的必要性。阅读体验上,作者的叙事风格非常克制且专业,没有过多煽情的辞藻,一切都以严谨的数学推导和清晰的逻辑链条为支撑。这使得我在阅读过程中几乎不需要进行“信息过滤”,可以直接吸收知识点。唯一需要注意的是,对于完全没有线性代数和微积分基础的读者来说,初期可能会有一点阅读障碍,但坚持下来,回报是巨大的。
评分贵组出书了,还是要支持一下啊
评分还行吧,7.5分。
评分马马虎虎
评分马马虎虎
评分算是很不错的一本讲深度学习的书了,相比市面上同类书籍,简直良心太多。现在一些互联网企业技术团队出的书都不错,美团的,hulu的,还有猿辅导的这本也挺好的了,介绍了很多工程层面的技巧,全面。
相关图书




本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有