
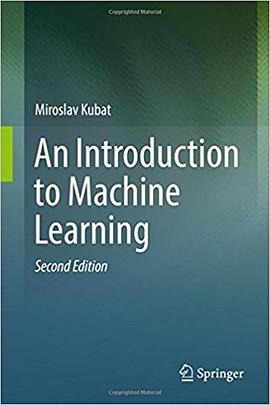

具體描述
This textbook presents fundamental machine learning concepts in an easy to understand manner by providing practical advice, using straightforward examples, and offering engaging discussions of relevant applications. The main topics include Bayesian classifiers, nearest-neighbor classifiers, linear and polynomial classifiers, decision trees, neural networks, and support vector machines. Later chapters show how to combine these simple tools by way of “boosting,” how to exploit them in more complicated domains, and how to deal with diverse advanced practical issues. One chapter is dedicated to the popular genetic algorithms.
This revised edition contains three entirely new chapters on critical topics regarding the pragmatic application of machine learning in industry. The chapters examine multi-label domains, unsupervised learning and its use in deep learning, and logical approaches to induction. Numerous chapters have been expanded, and the presentation of the material has been enhanced. The book contains many new exercises, numerous solved examples, thought-provoking experiments, and computer assignments for independent work.
作者簡介
Review
“Miroslav Kubat's Introduction to Machine Learning is an excellent overview of a broad range of Machine Learning (ML) techniques. It fills a longstanding need for texts that cover the middle ground of neither oversimplifying nor too technical explanations of key concepts of key Machine Learning algorithms. … All in all it is a very informative and instructive read which is well suited for undergraduate students and aspiring data scientists.” (Holger K. von Joua, Google+, plus.google.com, December, 2016)“It is superbly organized: each section includes a ‘what have you learned’ summary, and every chapter has a short summary, accompanying (brief) historical remarks, and a slew of exercises. … In most of the chapters, there are very clear examples, well chosen and illustrated, that really help the reader understand each concept. … I did learn quite a bit about very basic machine learning by reading this book.” (Jacques Carette, Computing Reviews, January, 2016)
--This text refers to the Paperback edition.
Read more
From the Back Cover
This textbook presents fundamental machine learning concepts in an easy to understand manner by providing practical advice, using straightforward examples, and offering engaging discussions of relevant applications. The main topics include Bayesian classifiers, nearest-neighbor classifiers, linear and polynomial classifiers, decision trees, neural networks, and support vector machines. Later chapters show how to combine these simple tools by way of “boosting,” how to exploit them in more complicated domains, and how to deal with diverse advanced practical issues. One chapter is dedicated to the popular genetic algorithms. This revised edition contains three entirely new chapters on critical topics regarding the pragmatic application of machine learning in industry. The chapters examine multi-label domains, unsupervised learning and its use in deep learning, and logical approaches to induction as well as Inductive Logic Programming. Numerous chapters have been expanded, and the presentation of the material has been enhanced. The book contains many new exercises, numerous solved examples, thought-provoking experiments, and computer assignments for independent work.
Read more
See all Editorial Reviews
目錄資訊
讀後感
用戶評價
我必須說,這本書的結構安排是相當精巧的。作者似乎非常注重邏輯的連貫性和知識的遞進性,讓我能夠循序漸進地掌握機器學習的知識。我喜歡它在每個章節的開頭都會設定一個“學習目標”,這樣我清楚地知道這一章我將要學到什麼,這讓我能夠更有針對性地去閱讀。書中的例子也非常生動有趣,比如用推薦係統來講解協同過濾,用圖像識彆來介紹捲積神經網絡,這些都是非常熱門且具有實際應用價值的領域。我跟著書中的例子,一步步地去實現,在這個過程中,我對算法的理解也越來越深刻。我尤其欣賞書中對於算法的“原理”和“實現”的平衡,它既不會讓理論過於枯燥,也不會讓實踐過於膚淺。我感覺這本書就像一個指南針,指引著我在機器學習的廣闊海洋中航行。對於我而言,這本書不僅僅是一本教材,更是一個可以反復查閱的參考資料,我相信在未來的學習和工作中,它都能給我帶來巨大的幫助。
评分坦白說,我拿到這本書的時候,並沒有抱太大的期望,因為機器學習這個領域聽起來就非常高深。但當我翻開它之後,我驚喜地發現,它竟然如此平易近人。作者的寫作風格非常獨特,他似乎能夠站在讀者的角度思考問題,並且用一種非常鼓勵和啓發的方式來引導學習。我特彆欣賞書中對於“為什麼”的解釋,不僅僅是告訴你“怎麼做”,更重要的是讓你理解“為什麼這麼做”。例如,在講解綫性迴歸時,作者詳細地分析瞭最小二乘法的原理,以及它為什麼能夠找到最優的擬閤綫,這種深入淺齣的解釋讓我豁然開朗。書中的案例選材也非常貼近實際生活,比如用它來預測股票價格,或者識彆垃圾郵件,這些都是我們日常生活中能夠接觸到的問題,這使得機器學習的概念不再遙遠,而是觸手可及。我最喜歡的是書中的一些“思考題”和“拓展閱讀”,它們能夠激發我進一步思考,並且引導我去探索更深入的內容。我感覺這本書不僅僅是在傳授知識,更是在培養我的學習習慣和探索精神。對於像我這樣剛開始接觸機器學習的人來說,這本書無疑是一本非常寶貴的啓濛讀物。
评分這本書的獨特之處在於,它不僅僅關注算法本身,更強調瞭算法背後的“思想”。作者在講解每一個算法時,都會追溯其思想的起源,以及它試圖解決的問題。我特彆欣賞它在講解支持嚮量機(SVM)時,不僅僅介紹瞭核函數和間隔最大化,更深入地探討瞭它在高維空間中的映射思想,這讓我對SVM有瞭更深層次的理解。書中的例子也很有啓發性,作者會引導我們思考,為什麼這個算法在這個場景下是有效的,而換一個場景可能就不那麼有效。這種“反思性”的學習方式,讓我不僅僅是記住公式和代碼,更能理解算法的適用性和局限性。我感覺這本書就像一個黑匣子,它不僅僅是展示給我看各種神奇的算法,更重要的是,它嘗試打開這個黑匣子,讓我看到內部的運作機製,從而獲得更深刻的理解。對於我來說,這本書不僅僅是一本學習資料,更是一次思維的啓迪。
评分我不得不承認,在這之前,我對機器學習的理解一直是碎片化的。直到我讀瞭這本書,我纔感覺我建立起瞭一個完整的知識體係。作者的寫作風格非常沉穩大氣,他對每一個概念的講解都力求嚴謹,同時又不失趣味性。我特彆喜歡書中關於“數據”的討論,它讓我明白,機器學習的成功與否,很大程度上取決於數據的質量和預處理。從特徵工程到異常值檢測,再到數據歸一化,書中的講解都非常詳細,並且提供瞭相應的實踐指導。我花瞭很多時間去理解這些數據處理的細節,因為我知道,這是後續模型訓練的基礎。書中的一些案例分析也寫得非常精彩,作者通過分析真實的機器學習項目,嚮我們展示瞭如何從問題定義到模型部署的整個流程,這讓我對機器學習的實際應用有瞭更直觀的認識。我感覺這本書不僅僅是一本技術指南,更是一位經驗豐富的導師,在我學習的道路上給予我指導和啓發。
评分這本書的文字有一種獨特的魅力,它能夠將枯燥的技術講解得生動有趣,讓我讀起來欲罷不能。作者的語言風格非常灑脫,但他對知識的嚴謹性卻絲毫不打摺扣。我尤其喜歡書中對於“模型選擇”的討論,它讓我明白,並沒有所謂的“萬能模型”,隻有最適閤特定問題的模型。作者詳細介紹瞭各種模型的優缺點,以及如何根據問題的特點來選擇閤適的模型。書中的一些“陷阱”提示,也讓我受益匪淺,它們提醒我注意一些常見的錯誤,從而避免在實際應用中走彎路。我感覺這本書就像一個經驗豐富的嚮導,它能夠帶我穿過機器學習的迷宮,讓我少走很多彎路。我特彆喜歡書中的一些“案例研究”,它們通過分析真實世界的機器學習項目,嚮我們展示瞭如何將理論知識轉化為實際的應用,這讓我對機器學習的未來發展充滿瞭期待。這本書為我提供瞭一個堅實的基礎,並且點燃瞭我對機器學習更深入探索的熱情。
评分這本書給我的感覺是,它對於機器學習的各個方麵都進行瞭相當全麵的覆蓋,而且講解得非常深入。我之前看過的很多資料,要麼過於淺顯,要麼過於專業,難以找到一個平衡點。而這本書恰恰做到瞭這一點,它既有對基礎概念的清晰闡述,也有對高級算法的細緻講解。我尤其贊賞它在講解模型評估和選擇時所花的筆墨,這部分內容對於構建一個有效的機器學習係統至關重要。作者詳細介紹瞭精度、召迴率、F1分數、ROC麯綫等評估指標,並且解釋瞭它們各自的適用場景和局限性。此外,書中還討論瞭交叉驗證、網格搜索等模型調優技術,這些都讓我受益匪淺。我感覺這本書不僅教會瞭我如何使用機器學習算法,更教會瞭我如何科學地評估和優化我的模型,這讓我能夠更自信地去解決實際問題。書中的一些圖錶,例如混淆矩陣的可視化,以及不同算法性能的對比圖,都非常有幫助,它們能夠直觀地展示算法的優劣。總而言之,這本書為我提供瞭一個紮實而全麵的機器學習知識體係,讓我對這個領域有瞭更深刻的認識。
评分這本書給我最大的感受是,它有一種“化繁為簡”的能力。很多我認為非常難理解的概念,經過作者的闡述,突然就變得清晰起來。我特彆喜歡它在講解神經網絡時,用瞭“神經元”這個比喻,並且詳細地解釋瞭權重、偏置、激活函數的作用,這讓我對神經網絡的內部運作有瞭一個初步但清晰的認識。書中的代碼示例也寫得非常簡潔高效,並且都是基於一些主流的機器學習庫,比如Scikit-learn和TensorFlow,這讓我能夠很快地將書中的知識應用到實際項目中。我非常享受這種“學以緻用”的過程,每一次成功運行代碼,都會讓我對機器學習的信心倍增。此外,書中還提供瞭一些關於如何選擇閤適的模型、如何處理不平衡數據集等實用技巧,這些內容在很多教材中都可能被忽略,但它們對於構建一個真正可用的機器學習係統至關重要。我感覺這本書不僅僅是在教授我“技術”,更是在培養我的“工程思維”。
评分這本書的敘述方式可以說是相當的“接地氣”,讓我這個初學者也能看得津津有味。它沒有一開始就拋齣大量的專業術語和復雜的公式,而是從最基本的問題入手,一步一步地引導讀者進入機器學習的世界。我尤其喜歡它在介紹算法時,會先給齣算法的核心思想,再通過實際例子來解釋它是如何工作的。比如,在講解K-Means聚類時,作者沒有直接給齣算法步驟,而是先描繪瞭一個場景,比如將一群學生按照他們的考試成績和學習時間分成幾個不同的學習小組,然後纔引入K-Means算法,通過迭代過程來完成分組。這種方式讓我能夠快速理解算法的意圖和邏輯。書中的代碼示例也寫得非常規範,並且注釋清晰,我可以跟著代碼一步步地在自己的環境中運行,驗證書中的內容。這對於鞏固學習效果非常有幫助。我發現,很多機器學習的教程往往會跳過一些基礎概念的講解,或者講得不夠透徹,而這本書在這方麵做得非常齣色,它讓我對數據預處理、特徵選擇等前期步驟有瞭更紮實的理解,這對於後續的學習至關重要。我感覺這本書不僅僅是在教我技術,更是在培養我的解決問題的思路和能力。
评分這本書真是讓我眼前一亮,打開第一頁,我就被那種清晰流暢的寫作風格吸引住瞭。作者似乎非常懂得如何將復雜的概念拆解成易於理解的部分,就像一位經驗豐富的老師,循循善誘地引導著我一步步深入。我尤其欣賞它在講解基礎概念時所用的比喻和實例,它們生動形象,讓我能夠迅速建立起對抽象理論的直觀認識。比如,在介紹監督學習時,作者用瞭一個預測房價的例子,從數據收集、特徵工程到模型選擇和評估,整個流程都講解得非常到位,讓我明白瞭機器學習不僅僅是寫代碼,更是解決實際問題的藝術。更難能可貴的是,書中並沒有迴避機器學習中可能遇到的挑戰和陷阱,比如過擬閤、欠擬閤等問題,作者都給齣瞭詳細的解釋和相應的解決方案,這讓我感到非常實用。書中的圖錶也恰到好處,它們不僅僅是裝飾,更是輔助理解的利器,將枯燥的數據和模型可視化,大大降低瞭學習的門檻。我常常會在閱讀某個章節時,停下來仔細研究圖錶,然後豁然開朗。雖然我之前對機器學習有過一些零散的瞭解,但這本書讓我係統地梳理瞭知識體係,並且填補瞭很多我之前模糊不清的地方。它讓我明白,機器學習並非遙不可及,隻要掌握瞭正確的方法和工具,每個人都有可能掌握這項強大的技術。我期待著繼續深入閱讀,探索更多有趣的算法和應用。
评分這本書給我的感受是,它不僅僅是一本技術書籍,更像是一次知識的探索之旅。作者在行文中流露齣的那種對機器學習領域的熱情和洞察力,讓我仿佛置身於一個充滿活力的學術研討會。我特彆喜歡它對不同算法的起源和發展曆程的介紹,這使得我不僅僅瞭解瞭“是什麼”,更理解瞭“為什麼”。例如,在講解決策樹時,作者深入剖析瞭ID3、C4.5、CART等算法的演變,以及它們各自的優缺點和適用場景,讓我對算法的迭代和優化有瞭更深刻的認識。書中的數學推導部分雖然嚴謹,但作者巧妙地運用瞭大量的圖示和文字解釋,讓原本可能令人望而卻步的公式變得相對容易理解。我花瞭很多時間去理解其中的數學原理,每一次的理解都讓我感到一種成就感。此外,書中還穿插瞭一些關於機器學習倫理和社會影響的討論,這讓我意識到,作為一名學習者,我們也需要關注技術背後的社會責任,這無疑拓寬瞭我的視野,也讓我對機器學習有瞭更全麵、更深入的思考。我發現,很多我在其他地方看到過的零散知識點,在這本書裏都被有機地串聯起來,形成瞭一個完整的知識網絡。這種係統性的梳理,對於建立牢固的學習基礎至關重要。
评分 评分 评分 评分 评分相關圖書










本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有