
具体描述
机器学习和预测分析正在改变商业和其他组织的运作模式。
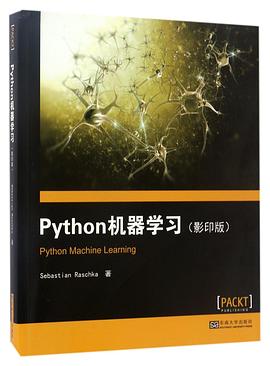
由塞巴斯蒂安·拉什卡著的《Python机器学习(影印版)(英文版)》将带你进入预测分析的世界,通过演示告诉你为什么Python是世界顶尖的数据科学语言之一。如果你想询问更深入的数据问题,或是想增进、拓展机器学习系统的能力,这本实用的书籍可谓是无价之宝。书中涵盖了包括scikit-learn、
Theano和Keras在内的大量功能强大的Python库、操作指南以及从情感分析到神经网络的各色小技巧,很快你就能够解答你个人及组织所面对的那些最重要的问题。
作者简介
SebastianRaschkaisaPhDstudentatMichiganStateUniversity,whodevelopsnewcomputationalmethodsinthefieldofcomputationalbiology.HehasbeenrankedasthenumberonemostinfluentialdatascientistonGitHubbyAnalyticsVidhya.HehasayearlongexperienceinPythonprogrammingandhehasconductedseveralseminarsonthepracticalapplicationsofdatascienceandmachinelearning.Talkingandwritingaboutdatascience,machinelearning,andPythonreallymotivatedSebastiantowritethisbookinordertohelppeopledevelopdata-drivensolutionswithoutnecessarilyneedingtohaveamachinelearningbackground.Hehasalsoactivelycontributedtoopensourceprojectsandmethodsthatheimplemented,whicharenowsuccessfullyusedinmachinelearningcompetitions,suchasKaggle.Inhisfreetime,heworksonmodelsforsportspredictions,andifheisnotinfrontofthecomputer,heenjoysplayingsports.
目录信息
读后感
用户评价
从作者的写作风格来看,我能感觉到他是一位资深的数据科学家,而非仅仅是理论研究者。他的语气中带着一种对细节的苛求和对效率的追求。比如,在讨论模型泛化能力时,他没有仅仅停留在Bias-Variance权衡的理论层面,而是引入了“鲁棒性测试”的概念,并提供了一套非常实用的交叉验证策略组合,包括Leave-One-Out和Stratified K-Fold的适用场景分析。这种注重工程实践的叙述方式,极大地拓宽了我的思路。我特别欣赏他对于“不确定性量化”的强调,书中用好几处笔墨说明了,一个好的预测结果必须伴随着一个可靠的置信区间,这在金融和医疗等高风险领域至关重要。这种思维方式,使得这本书超越了单纯的算法堆砌,上升到了数据科学方法论的高度。读完后,我感觉自己对如何构建一个“负责任”的AI系统有了更深刻的理解,而不是盲目追求最高的准确率数字。
语言的精确性是影印版书籍的一大考验,但这本书在这方面做得非常出色。即使是直接翻译的英文原文,其行文逻辑也极其顺畅,没有那种“翻译腔”的别扭感。特别是专业术语的用法,都精准地把握住了其在特定上下文中的含义。例如,对“Regularization”的解释,作者巧妙地区分了L1和L2范数在模型稀疏性和参数平滑性上的不同影响,并且通过清晰的数学公式对比展示了它们对损失函数的修正作用。书中大量的图示辅助理解,尤其是那些高维数据的可视化展示,极大地帮助我理解了降维算法(如PCA和t-SNE)的内在机制。很多时候,看一遍文字描述可能还是一头雾水,但配合图表走一遍流程,立马就豁然开朗了。这种图文并茂的讲解方式,极大地降低了学习曲线的陡峭程度,让原本高深的统计学习理论变得触手可及。
这本书的实战性强到让人惊喜。我以前看过不少号称“实战”的书,结果拿到手发现里面充斥着大量过时的库版本或者只是简单地调用了几个API就草草收尾。然而,这本书的每一章后面都紧跟着一个完整的、可运行的案例项目。从数据清洗、特征工程,到模型选择、超参数调优,每一步的考量点都写得非常详尽。作者似乎没有放过任何一个细节,比如在处理时间序列数据时,他不仅提到了ARIMA模型,还花了大量的篇幅对比了Facebook的Prophet在处理季节性和节假日效应时的优势和劣势,这种前沿的视角在同类书籍中是比较少见的。更重要的是,它没有局限于Scikit-learn这个“瑞士军刀”,还深入探讨了TensorFlow和PyTorch在深度学习任务中的应用,虽然篇幅相对精简,但足以搭建起一个对现代AI工具栈的基本认知框架。每次我按照书中的步骤敲完代码,运行出结果时,那种成就感是实实在在的,它让我觉得机器学习不再是遥不可及的黑箱,而是可以通过系统学习掌握的工程技能。
这本书给我的最大价值在于它提供了一个完整的知识体系地图,而不是零散的知识点集合。它不仅仅教授了监督学习和无监督学习的基本算法,更重要的是,它在章节的过渡和总结部分,不断地引导读者思考这些技术在真实世界复杂系统中的整合与局限。比如,在讨论集成学习时,它不仅对比了Bagging和Boosting的底层差异,还详细分析了Stacking结构如何通过元学习器进一步优化组合效果,甚至还提到了模型异构性对集成效果的潜在负面影响。这让阅读体验从“学习一个新算法”转变为“设计一个端到端的解决方案”。对我来说,这本书就像是一个经验丰富的导师,在指引我构建自己的机器学习知识树时,确保每一个分支都能稳固地扎根于坚实的理论基础之上,并朝着最高效的工程实现方向发展,这在很多国内的速成类书籍中是很难获得的深度和广度。
这本书的封面设计确实很有吸引力,那种深邃的蓝色背景配上简洁的白色字体,让人一眼就能感受到它专业且严谨的气质。初次翻开,最让我印象深刻的是它对基础概念的阐述,没有那种生硬的教科书式的说教,而是通过非常生活化的例子来引入复杂的机器学习原理。比如,讲解决策树的时候,作者用了好几页篇幅详细描述了一个虚拟的公司如何利用数据来做招聘决策的场景,把ID3、C4.5这些算法的逻辑拆解得非常透彻,甚至连信息增益和熵的计算过程都清晰地展示了推导过程,这对于我这种希望真正理解“为什么”而不是仅仅知道“怎么做”的初学者来说,简直是如沐春风。它似乎在时刻提醒读者,背后的数学逻辑才是构建强大模型的基石。而且,排版处理得非常好,代码块和理论公式之间穿插得恰到好处,读起来一点也不觉得冗长枯燥,反而有一种跟随作者思路层层深入的流畅感。尽管是影印版,但文字的清晰度和图表的质量都没有任何打折,这对于需要对照原文学习的读者来说,无疑是一个加分项。
错误太多。
自己第一本用python实操机器学习的书,使用sklearn 实验常用的模型练下手不错,还能建个网页展示一下,实操满满,入门机器学习不错,书中的数学也比较简单,错误有作者主页勘误,英文版没多大问题
错误太多。
错误太多。
错误太多。