
具体描述
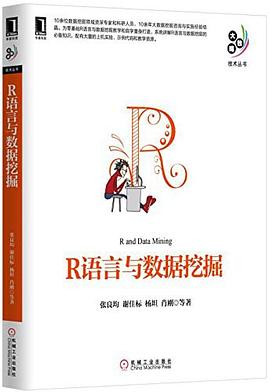
本书主要分为三个部分,基础篇、建模应用篇和Rattle篇。基础篇(第1~5章)介绍了有关R语言的安装与使用、R语言中的数据结构、常用操作和绘图功能等基础功能。建模应用篇(第6~10章)主要介绍了目前在数据挖掘中的常用的建模方法在R语言中的实现函数,并对输出结果进行了解释,有助于读者快速掌握应用R语言进行分析挖掘建模的方法。Rattle篇(第11章)介绍了一个R语言的图形界面工具。图书配套提供了程序代码及数据,读者可通过上机实验,快速掌握书中所介绍的R语言的使用方法。
作者简介
目录信息
前言
第一部分 基础篇
第1章 R语言的安装与使用
1.1 R安装与升级
1.2 R使用入门
1.3 R数据分析包
1.4 配套资源使用说明
1.5 小结
1.6 上机实验
第2章 数据对象与数据读写
2.1 数据类型
2.2 数据结构
2.3 数据文件的读写
2.4 小结
2.5 上机实验
第3章 R语言常用数据管理
3.1 变量的重命名
3.2 缺失值分析
3.3 数据排序
3.4 随机抽样
3.5 数值运算函数
3.6 字符串处理
3.7 文本分词
3.8 apply函数族
3.9 数据整合
3.10 控制流
3.11 函数的编写
3.12 小结
3.13 上机实验
第4章 图形探索
4.1 图形元素
4.2 图形组合
4.3 图形保存
4.4 图形函数
4.5 小结
4.6 上机实验
第5章 高级绘图工具
5.1 lattice包绘图工具
5.2 ggplot2包绘图工具
5.3 交互式绘图工具简介
5.4 小结
5.5 上机实验
第二部分 建模应用篇
第6章 分类与预测
6.1 回归分析
6.2 决策树
6.3 人工神经网络
6.4 KNN算法
6.5 朴素贝叶斯分类
6.6 其他分类与预测算法函数
6.7 分类与预测算法评价
6.8 小结
6.9 上机实验
第7章 聚类分析
7.1 K-Means聚类分析函数
7.2 层次聚类算法
7.3 其他聚类分析函数
7.4 小结
7.5 上机实验
第8章 关联规则
8.1 Apriori关联规则
8.2 小结
8.3 上机实验
第9章 智能推荐
9.1 智能推荐模型构建
9.2 智能推荐模型评价
9.3 小结
9.4 上机实验
第10章 时间序列
10.1 ARIMA模型
10.2 其他时间序列模型
10.3 小结
10.4 上机实验
第三部分 Rattle篇
第11章 可视化数据挖掘工具Rattle
11.1 Rattle简介及其安装
11.2 功能预览
11.3 数据导入
11.4 数据探索
11.5 数据建模
11.6 模型评估
11.7 小结
11.8 上机实验
参考资料
· · · · · · (收起)
读后感
用户评价
关联规则挖掘在商品推荐、购物篮分析等领域具有广泛的应用。我期待《R语言与数据挖掘》能够详细阐述Apriori算法、FP-growth算法等经典关联规则挖掘方法的原理,以及如何在R语言中实现这些算法。书中是否会讲解如何设置支持度(Support)、置信度(Confidence)和提升度(Lift)等参数,以及如何解读这些参数的含义。对于这些参数的设置,往往需要根据具体的数据集和业务场景进行调整,我希望能从书中获得一些指导性的建议。 更吸引我的是,书中是否会提供一些实际的案例,展示如何利用关联规则挖掘来发现数据中的隐藏关联。例如,在零售业中,通过分析顾客的购物篮数据,找出哪些商品经常被一起购买,从而为商品陈列、捆绑销售等提供依据。这样的案例分析,能够帮助我理解关联规则挖掘在实际业务中的应用价值,并学会如何将理论知识转化为可操作的解决方案。
异常检测(Anomaly Detection)在欺诈检测、网络安全、工业故障诊断等领域具有至关重要的意义。我期待《R语言与数据挖掘》能深入浅出地介绍各种异常检测的原理和方法,包括基于统计的方法、基于机器学习的方法(如孤立森林、One-Class SVM)等。书中是否会指导我如何使用R语言实现这些算法,并对检测到的异常进行可视化和解释。 我尤其关注书中关于如何定义“异常”以及如何评估异常检测模型表现的讨论。异常检测的边界往往比较模糊,书中是否会提供一些实际操作的指导,帮助我选择合适的阈值,以平衡漏报和误报。此外,是否会包含一些实际的案例,例如检测信用卡交易中的欺诈行为,或者识别工业设备运行中的异常模式。这些案例将帮助我更深刻地理解异常检测的实际应用价值,并学会如何构建有效的异常检测系统。
聚类分析作为无监督学习的重要分支,其在用户画像、市场细分等领域的应用价值不言而喻。我希望《R语言与数据挖掘》中关于聚类算法的部分,能够详尽地介绍K-means、层次聚类、DBSCAN等常用算法的原理,以及它们各自的优缺点和适用场景。更重要的是,这本书能否指导我如何使用R语言的强大工具来实现这些算法,例如使用`cluster`包进行聚类分析,并利用`factoextra`等包来可视化聚类结果,如绘制散点图、树状图等,以便更直观地理解数据中的分组情况。 我特别期待书中关于如何确定最优聚类数量的讨论。在实际操作中,选择合适的聚类数量往往是一个挑战,书中是否会介绍一些常用的方法,如肘部法则(Elbow Method)、轮廓系数(Silhouette Score)等,并结合R语言代码进行演示。此外,书中是否会涉及如何对聚类结果进行解释和评估,例如对每个簇的特征进行总结和分析,从而为业务决策提供支持。拥有清晰的聚类结果和深入的分析,将极大地提升我处理无结构化数据的能力。
对于书中关于分类算法的阐述,我抱有极大的兴趣。分类是数据挖掘中最常见的任务之一,其应用范围之广,从垃圾邮件检测到医疗诊断,无处不在。我希望这本书能够深入浅出地讲解各种经典的分类算法,比如逻辑回归、支持向量机(SVM)、决策树、随机森林以及朴素贝叶斯等。不仅仅是算法的原理介绍,更重要的是如何利用R语言实现这些算法,并对模型进行评估。例如,讲解如何使用`caret`包来统一建模流程,如何绘制混淆矩阵、计算准确率、召回率、F1分数等指标来评估模型的性能。书中是否会涉及模型的调优,例如通过交叉验证来选择最优参数,以避免过拟合和欠拟合,这些都是我非常关心的问题。 尤其期待的是,书中能否提供一些实际案例,展示如何将这些分类算法应用于真实场景。比如,在金融领域,如何利用这些算法来预测客户的信用风险;在电商领域,如何根据用户的购买历史和行为来预测其是否会流失。通过具体的案例分析,我能够更直观地理解算法的适用性,以及在实践中可能遇到的问题和解决方案。这些案例的讲解,不仅能巩固我所学的理论知识,更能激发我解决实际问题的能力。
文本挖掘是处理海量非结构化文本数据,从中提取有价值信息的核心技术。我期望《R语言与数据挖掘》能为我打开这扇大门,详细介绍文本预处理的各个环节,例如分词、去除停用词、词干提取等。我相信书中会重点讲解如何利用R语言的强大文本挖掘包,如`tm`、`jiebaR`(针对中文)等,来实现这些操作。 除了基础的文本预处理,我更期待书中能够深入讲解主题模型(如LDA)、情感分析、文本分类等高级文本挖掘技术。如何从大量的文档中发现潜在的主题?如何判断一段文本表达的情感是积极还是消极?如何将文本数据转化为模型能够理解的数值特征,并进行分类?这些都是我非常感兴趣且渴望掌握的技能。书中是否会提供一些实际的文本挖掘案例,例如分析新闻报道以了解热点话题,或者对用户评论进行情感分析以评估产品口碑,这将极大地提升我理解和应用文本挖掘的能力。
模型评估与选择是数据挖掘过程中不可或缺的一环,它决定了最终模型的性能和可靠性。《R语言与数据挖掘》在这方面的内容,我非常期待。我希望书中能够详尽地介绍各种模型评估指标,例如在回归问题中的均方误差(MSE)、R²分数,在分类问题中的准确率(Accuracy)、精确率(Precision)、召回率(Recall)、F1分数、AUC值等等。 更重要的是,书中是否会深入讲解如何通过交叉验证(Cross-validation)等技术来评估模型的泛化能力,以及如何避免过拟合和欠拟合。是否会介绍一些模型选择的策略,例如基于信息准则(AIC、BIC)的模型选择,或者通过网格搜索(Grid Search)、随机搜索(Random Search)等方法来寻找最优模型参数。这些内容将帮助我建立起一个严谨的模型评估体系,从而选择出最适合特定问题的模型。
时间序列分析在金融预测、销售预测、天气预报等领域扮演着至关重要的角色。我希望《R语言与数据挖掘》能够深入讲解时间序列数据的特性,如趋势、季节性、周期性等,以及如何使用R语言对这些特性进行分析和可视化。书中是否会介绍ARIMA模型、指数平滑法等经典的预测模型,并指导我如何使用R语言实现这些模型的构建、训练和预测。 我特别关注书中关于模型评估和选择的部分。如何判断一个时间序列模型是否表现良好?书中是否会介绍一些常用的评估指标,如均方根误差(RMSE)、平均绝对误差(MAE)等,并演示如何使用R语言计算这些指标。此外,书中是否会讨论如何处理非平稳时间序列数据,例如通过差分等方法将其转化为平稳序列,以便应用ARIMA等模型。拥有扎实的理论基础和实践经验,我才能更好地应对各种时间序列预测的挑战。
降维技术在处理高维数据时,能够有效地减少数据维度,提高模型训练效率,并帮助我们更好地理解数据。我希望《R语言与数据挖掘》能详细介绍主成分分析(PCA)、独立成分分析(ICA)、t-SNE 等经典的降维方法。书中是否会讲解这些方法的数学原理,以及如何在R语言中实现它们,例如使用`prcomp()`函数进行PCA。 我特别期待书中关于如何选择合适的降维方法和确定降维后的维度数的讨论。不同的降维方法有不同的适用场景,书中是否会提供一些指导性的建议?降维后的数据如何进行可视化,以便我们能够直观地观察数据的结构和分布?例如,使用`ggplot2`绘制降维后的二维或三维散点图。此外,是否会包含一些实际案例,展示降维技术在图像识别、基因数据分析等领域的应用。
数据可视化作为数据挖掘的“最后一公里”,其重要性不言而喻。我希望《R语言与数据挖掘》能够 devote substantial attention to this aspect. 我期待书中能够介绍R语言中强大的可视化包,如`ggplot2`,并提供丰富的图表示例,包括散点图、折线图、柱状图、箱线图、热力图等,以及如何根据不同的分析目的选择合适的图表类型。 我尤其期待书中能够讲解如何通过可视化来探索性地分析数据,例如发现数据中的模式、趋势、异常值以及变量之间的关系。是否会介绍一些交互式可视化的方法,使得用户能够更深入地探索数据。此外,书中是否会包含一些案例,展示如何通过高质量的可视化来有效地沟通分析结果,例如制作用于报告或演示的图表。一个清晰、直观且富有洞察力的可视化,能够极大地增强数据分析的价值。
一本期待已久的书终于捧在手心,书名为《R语言与数据挖掘》。翻开目录,看到的是一个精心构建的知识体系,从R语言的基础语法,到各种经典的挖掘算法,再到实际的应用场景,内容详实,逻辑清晰。作为一名渴望深入理解数据奥秘的学生,我深知掌握一门强大的工具和理论的重要性。R语言以其开源、免费、功能强大而受到数据科学界的青睐,而数据挖掘更是现代数据分析不可或缺的关键环节。这本书无疑为我提供了一个绝佳的学习平台。 我尤其关注书中关于数据预处理的部分。在实际的数据分析过程中,原始数据的质量往往不尽如人意,噪声、缺失值、异常值等问题层出不穷。如何有效地清洗和转换数据,是决定后续挖掘结果成败的关键。这本书对这一环节的讲解,我相信会非常细致,可能会涵盖如何使用R语言的各种包来识别和处理这些数据问题,例如利用`dplyr`进行数据筛选和转换,使用`tidyr`处理宽窄表,以及运用`imputeTS`等包来填充缺失值。此外,特征工程也是我非常期待的部分,如何从原始数据中提取出有意义的特征,构建更具预测能力的模型,这需要深厚的理论功底和丰富的实践经验,这本书能否提供一些实用的技巧和方法,让我拭目以待。
看起来写得很好。但是我一点也不想看,一点也看不懂啊。老师上课也不想听。完了,我要挂了
太烂了,主体部分讲的少,上机实验部分要求却多,浪费大把时间找资料,却没学到什么实在的东西。
果然是一本烂书,你的《R语言与数据挖掘》《python与数据挖掘》都说完全面向零基础,可是介绍线性回归的时候就描述得根本不是零基础读者。
本来想了解一下,这评价让我打消念头了解
果然是一本烂书,你的《R语言与数据挖掘》《python与数据挖掘》都说完全面向零基础,可是介绍线性回归的时候就描述得根本不是零基础读者。