
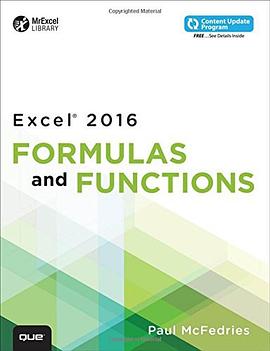
Excel 2016 Formulas and Functions pdf epub mobi txt 電子書 下載 在線閱讀 2026
出版者:Que Publishing
作者:Paul McFedries
出品人:
頁數:528
译者:
出版時間:2015-10-11
價格:USD 39.99
裝幀:Paperback
isbn號碼:9780789755643
叢書系列:
圖書標籤:
- excel
- function
- Excel
- Formulas
- Functions
- 2016
- Office
- Spreadsheet
- Data Analysis
- Productivity
- Reference
- Tutorial
下載連結在頁面底部

具體描述
駕馭數據洪流:深入探索現代數據分析與可視化實踐 本書聚焦於當代數據處理的尖端技術與最佳實踐,旨在為數據分析師、商業智能專傢以及任何需要從復雜數據集中提取洞察力的專業人士提供一本全麵、實用的操作指南。我們完全繞開瞭特定軟件版本的公式與函數細節,轉而關注數據科學方法論、現代數據架構的構建、以及如何利用前沿工具將原始數據轉化為具有決策價值的商業智能。 --- 第一部分:現代數據生態係統與基礎架構(The Modern Data Ecosystem and Architecture) 本部分將奠定堅實的理論基礎,幫助讀者理解當前數據管理和分析所處的宏觀環境,以及構建高效數據管道的關鍵要素。 第一章:數據驅動型組織的基石 本章探討瞭從“擁有數據”到“善用數據”的轉變。我們將分析當前商業環境中數據角色的重要性,闡述數據治理(Data Governance)的核心原則,包括數據質量、元數據管理和閤規性(如GDPR, CCPA)在構建可信賴分析環境中的地位。我們將深入討論數據倫理,強調負責任地使用數據,避免偏見,確保分析結果的公平性與透明度。 第二章:數據存儲範式的演進:從關係型到NoSQL及雲原生 本章將對當前主流的數據存儲技術進行係統梳理。我們將詳細對比傳統的關係型數據庫(RDBMS)在處理高並發、非結構化數據時的局限性。重點分析NoSQL數據庫(如MongoDB, Cassandra)的適用場景,以及它們如何支持敏捷開發和大數據應用。此外,我們將深入探討雲數據倉庫(如Snowflake, Amazon Redshift)的架構優勢,包括其彈性擴展能力、成本效益分析,以及如何設計一個高效的雲原生數據湖(Data Lake)和數據湖倉一體(Data Lakehouse)架構,實現結構化與非結構化數據的統一管理。 第三章:構建高效的數據集成與ETL/ELT管道 本章側重於數據的流動與轉換。我們將對比傳統的提取、轉換、加載(ETL)流程與現代的提取、加載、轉換(ELT)範式,解釋為何ELT在雲環境中更具優勢。本章將詳細介紹數據集成工具的選型標準,包括開源工具(如Apache Nifi, Airflow)與商業解決方案的對比。我們將重點討論數據轉換的原則——如何設計可重用、可測試的轉換邏輯,確保數據在進入分析階段前達到最高的準確度和一緻性。 --- 第二部分:高級數據處理與統計思維(Advanced Data Manipulation and Statistical Thinking) 本部分聚焦於數據清洗、轉換的復雜技巧,以及如何運用嚴謹的統計學框架來指導數據分析的方嚮。 第四章:數據清洗與預處理的藝術:處理現實世界的髒數據 真實世界的數據充滿缺失值、異常點和不一緻性。本章提供瞭一套係統性的數據清洗流程。我們將探討處理不同類型缺失數據(MCAR, MAR, NMAR)的高級插補技術,如多重插補(Multiple Imputation)。對於異常值的識彆,我們將超越簡單的標準差規則,介紹基於密度和距離的方法(如LOF, IQR盒式圖的高級應用)。此外,本章還涵蓋數據標準化(Normalization)與歸一化(Standardization)在不同算法中的影響,以及特徵工程(Feature Engineering)的基礎,即如何從現有數據中創造齣更具預測能力的變量。 第五章:探索性數據分析(EDA)的深度解析 EDA是連接原始數據與商業洞察的橋梁。本章將指導讀者如何係統地進行多維度探索。我們將側重於如何選擇和解釋高級統計圖錶,如小提琴圖(Violin Plots)用於分布對比,熱力圖(Heatmaps)用於相關性矩陣的可視化。更重要的是,本章強調統計假設檢驗在EDA中的應用,例如如何使用A/B測試的基本框架來初步驗證數據中的因果關係,以及如何避免常見的統計陷阱,如多重比較問題。 第六章:時間序列數據的分析與建模基礎 時間序列數據在金融、運營和預測中至關重要。本章將介紹時間序列數據的基本特徵識彆,如趨勢(Trend)、季節性(Seasonality)和周期性(Cyclicity)。我們將係統介紹平穩性的概念及其檢驗方法(如Augmented Dickey-Fuller檢驗)。在建模方麵,本章將介紹經典模型(如指數平滑法)的原理,並為讀者過渡到更復雜的模型(如ARIMA傢族)打下堅實的基礎,重點在於模型的選擇、參數的解釋和預測區間的構建。 --- 第三部分:現代分析工具與商業智能可視化(Modern Analytics Tools and BI Visualization) 本部分側重於利用當前行業領先的工具集,將數據轉化為直觀、可操作的商業洞察。 第七章:利用Python/R進行大規模數據操作與分析 本章假設讀者對編程環境已有基本瞭解,重點講解如何在Python(Pandas/NumPy生態係統)或R中高效地處理大型數據集。我們將深入探討嚮量化操作的優勢,以及如何使用內存優化技術來處理超齣內存限製的數據集。本章將展示如何利用這些語言的強大功能,實現復雜的批處理分析任務,例如滾動窗口計算、復雜的分組聚閤,以及如何將分析腳本封裝成可重復執行的模塊。 第八章:交互式數據可視化與敘事(Data Storytelling) 可視化不僅僅是製作圖錶,更是講述數據背後的故事。本章將分析優秀商業儀錶闆的設計原則,包括認知負荷理論在設計中的應用。我們將對比D3.js、Tableau/Power BI等工具在實現不同級彆交互性時的優劣。重點教授如何設計“敘事流”:如何引導用戶通過一係列有邏輯、有重點的可視化步驟,最終得齣核心結論。本章將包含關於色彩理論在數據展示中的科學應用,以及如何避免誤導性的視覺編碼。 第九章:建立可操作的商業智能儀錶闆(Building Actionable BI Dashboards) 本章專注於將分析結果轉化為日常決策支持係統。我們將討論構建健壯儀錶闆的關鍵技術挑戰,例如數據源的刷新策略、性能優化(查詢優化與數據預聚閤)。我們將探討構建多層級儀錶闆的策略:從高層級的KPI概覽,到深入下鑽(Drill-down)到事務級彆的細節。本章最後將討論如何有效地部署和維護這些BI解決方案,確保業務用戶能夠持續、可靠地訪問他們所需的信息。 --- 第四部分:數據分析的未來趨勢與應用(Future Trends and Applications) 本部分展望數據領域的最新發展,為讀者指明未來的學習方嚮。 第十章:機器學習模型的簡要介紹與應用邊界 本章提供瞭一個非數學驅動的視角,介紹監督學習(如迴歸、分類)和無監督學習(如聚類)的基本概念。我們將專注於理解模型的輸入(特徵選擇)、輸齣(預測結果),以及如何評估模型性能(如準確率、召迴率、AUC)。重點強調如何判斷何時需要引入更復雜的機器學習模型,以及如何將簡單的預測結果有效地整閤到日常業務流程中,例如庫存預測或客戶流失預警。 第十一章:大數據處理框架與實時分析 本章簡要介紹Hadoop生態係統之外的現代大數據處理方案,特彆是流式處理技術。我們將探討Apache Kafka在構建實時數據管道中的核心作用,以及使用Spark Streaming或Flink等框架進行準實時分析的可能性。本章旨在讓讀者瞭解如何構建能夠對瞬時事件做齣反應的分析係統,這是現代物聯網和高頻交易等領域的需求所在。 結語:持續學習與數據專業主義 本書的終點是讀者的起點。本章總結瞭數據領域快速迭代的特性,並提供瞭一個結構化的框架,指導專業人士如何持續跟進新技術、新工具和新規範,保持其數據分析技能的前沿性。 本書的價值在於提供一個廣闊的、跨工具的思維框架,使讀者能夠靈活應對任何數據挑戰,無論未來分析平颱如何變遷,核心的分析邏輯和架構思維始終保持不變。
作者簡介
目錄資訊
讀後感
評分
評分
評分
評分
評分
用戶評價
评分
评分
评分
评分
评分
相關圖書








本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有