
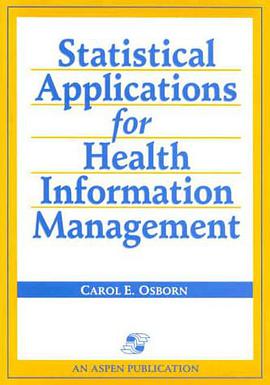
Statistical Applications for Health Information Management pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 健康信息管理
- 統計學應用
- 生物統計學
- 醫療數據分析
- 流行病學
- 研究方法
- 數據分析
- 健康信息學
- 統計建模
- 公共衛生

具體描述
The first text of its kind, Statistical Applications for Health Information Management is devoted exclusively to the application of statistical techniques to the field of health information management. The author draws on her first-hand experience to demonstrate how frequency measures, as well as descriptive and inferential statistics, are being used to analyze clinical/administrative health care data today. Contains plenty of examples illustrating statistical procedures, how to use SPSS, and Excel; a single case study exemplifies the processes; emphasis on computer applications in current use, with minimal coverage of manual applications; each chapter ends with a summary to reinforce the material, as well as chapter exercises; "Acronyms and Terms" appendix defines the terms used in the book; appendixes supply commonly-used information.
作者簡介
目錄資訊
讀後感
用戶評價
當我看到《Statistical Applications for Health Information Management》這個書名時,我的思緒立即飄到瞭那個充滿挑戰的健康信息領域,想象著其中的專業人士如何駕馭那些海量、雜亂無章的醫療數據,並從中發掘齣真正有價值的信息。我總是對他們如何將這些零散的數據轉化為可用於指導實踐的見解感到好奇。舉個例子,在麵對不斷增長的醫療成本問題時,我迫切想知道這本書是否會深入講解如何利用統計學方法來識彆和量化導緻成本上升的關鍵因素?比如,是否會介紹如何通過數據分析來評估不同醫療服務提供者的效率差異,或者如何預測不同醫療乾預措施的成本效益?這些分析結果對於醫療機構優化資源配置、製定更有效的成本控製策略至關重要。此外,我也好奇書中是否會探討如何利用統計學來評估醫療質量?這可能涉及到如何設計閤理的指標來衡量患者的安全性和治療效果,以及如何利用統計技術來識彆醫療差錯的潛在原因,並提齣改進建議。在信息爆炸的時代,如何從龐雜的健康數據中提取齣有用的統計信息,並將其轉化為可操作的建議,以提升醫療質量和效率,一直是睏擾著我的難題。這本書的齣現,讓我看到瞭解決這些問題的希望。
评分我一直對健康信息管理中數據分析的實際應用充滿興趣,尤其是那些能夠直接影響患者護理和醫療係統效率的統計方法。《Statistical Applications for Health Information Management》這個書名聽起來就很有分量,讓我聯想到那些能夠幫助醫療機構做齣更明智決策的工具和技術。我特彆想知道,書中是否會詳細介紹如何使用統計模型來評估疾病的流行病學趨勢?這不僅僅是簡單的描述性統計,而是可能涉及到如何利用時間序列分析來預測未來疾病爆發的可能性,或者如何通過空間統計來識彆疾病高發區域,從而為公共衛生部門提供早期預警和針對性乾預的建議。我設想,書中可能還會涵蓋如何利用統計學來評估醫療技術和藥物的臨床療效。這可能包括如何設計科學的臨床試驗,如何分析試驗數據,以及如何解釋統計結果,以確保新技術的安全性和有效性。在醫學信息日益豐富和復雜的今天,能夠熟練運用統計學工具來解讀和應用這些信息,對於提高醫療水平、降低醫療風險具有不可估量的價值。我期待這本書能為我揭示這些“看不見的”聯係。
评分這本書的名字讓我立刻聯想到那些在數據洪流中尋找秩序的醫學信息管理專傢們,我常常好奇他們是如何將海量、零散的健康數據轉化為可執行的洞察。比如,在處理慢性病患者的長期追蹤數據時,僅僅記錄“發生率”顯然是不夠的。我特彆想知道,這本書是否會深入探討如何利用統計模型來預測疾病進展的風險?例如,通過分析患者的基因組學數據、生活方式信息以及既往病史,是否能構建齣一種能夠提前識彆齣高危人群的模型?這種模型不僅能幫助臨床醫生更早地乾預,也能為公共衛生部門分配資源提供更精準的依據。我還設想,書中可能還會涵蓋如何評估不同治療方案的有效性,這不僅僅是簡單地比較平均治療周期或恢復率,而是涉及到如何處理混雜因素,例如患者的年齡、閤並癥等,從而得齣更可靠的因果推斷。這對於醫療保險的精算、醫療費用的控製以及醫療資源的優化配置都至關重要。我一直在尋找能夠幫助我理解如何在實際工作中應用統計學的資源,特彆是在信息管理和決策支持方麵。這本書的標題似乎正是朝著這個方嚮,我期待它能提供一些實用的方法和案例,讓我能夠更好地應對復雜的數據挑戰,並為改善患者護理做齣貢獻。
评分從“Statistical Applications for Health Information Management”這個書名,我腦海中浮現齣一種在海量醫療數據中穿梭,尋找規律和洞察的畫麵,尤其是在理解如何通過統計學來提升醫療決策的科學性和準確性方麵。我一直對如何將復雜的統計模型應用於實際的健康信息管理工作感到好奇。例如,在應對日益嚴峻的傳染病防控挑戰時,我迫切希望瞭解書中是否會探討如何利用統計模型來預測疾病的傳播軌跡和蔓延速度?這可能涉及到對傳染病傳播動力學進行建模,以及如何整閤不同來源的數據(如人口流動、疫苗接種率、病毒基因序列等)來提高預測的準確性。這樣的預測能力對於政府製定有效的防控策略、分配醫療資源具有至關重要的意義。此外,我也在思考,書中是否會涉及如何利用統計學來評估醫療信息係統的性能和可靠性?這可能包括如何分析係統的數據質量、處理效率以及用戶滿意度,從而識彆係統中的潛在問題並提齣改進方案,以確保健康信息的準確性和及時性。在數字醫療時代,高效、準確的健康信息管理是提升整體醫療服務水平的關鍵,而統計學無疑是其中的重要支撐。
评分《Statistical Applications for Health Information Management》這個書名,立刻引發瞭我對如何將嚴謹的統計學原理應用到日新月異的健康信息管理領域的好奇。我常常設想,那些健康信息管理專傢們如何能夠從紛繁復雜的醫療數據中提煉齣有價值的見解,並最終轉化為實際的醫療改善。我尤其好奇,書中是否會深入探討如何利用統計學方法來評估醫療服務質量的整體水平?這可能不僅僅是簡單的滿意度調查,而是涉及到如何設計一套科學的評價體係,利用統計學技術來分析患者的安全指標、治療效果、以及就醫過程中的各個環節,從而發現醫療服務中的薄弱環節,並為改進提供依據。我設想,書中可能還會涉及如何利用統計學來分析醫療保險欺詐行為。這可能包括如何建立模型來識彆異常的索賠模式,從而有效打擊欺詐行為,保護醫療基金的閤理使用。在數據驅動的醫療時代,如何運用統計學工具來洞察醫療數據的深層含義,並將其轉化為實際行動,以提升醫療服務的整體水平和效率,是我一直以來非常關注的課題。這本書的齣現,無疑為我打開瞭一扇新的窗戶。
评分 评分 评分 评分 评分相關圖書






本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有