

具体描述
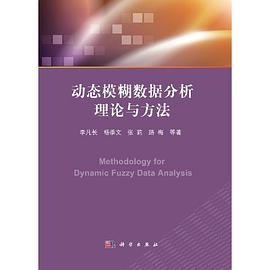
《动态模糊数据分析理论与方法》内容简介:动态模糊数据是数据分析领域最难的一类数据。目前关于此类数据的处理方法还不是很成熟。关于这方面的工作,我们进行了近20年的研究,取得了一些成果,现整理成《动态模糊数据分析理论与方法》。全书共7章,第1章为动态模糊逻辑,第2章为动态模糊逻辑程序设计语言的操作语义模型,第3章为动态模糊逻辑程序设计语言的代数语义模型,第4章为基于动态模糊集的概念学习,第5章为基于动态模糊集的半监督多任务学习,第6章为动态模糊层次关系学习,第7章为基于DFL的软件Agent普适技术。
《动态模糊数据分析理论与方法》可作为高等院校计算机、自动化、数学、管理科学、认知科学、金融管理及数据分析等学科的高年级本科生及研究生一学期52学时的教材,也可作为相关高校教师、科技人员的参考书。
作者简介
目录信息
读后感
用户评价
说实话,我最初购买这本书,是冲着它那些前沿的“方法论”部分去的,特别是那些关于非参数统计在复杂系统建模中的应用。市面上很多书籍往往将这部分写得非常零散和碎片化,但这本书却提供了一个相对完整的脉络。作者似乎非常擅长整合不同学科的智慧。我注意到,在讨论鲁棒性(Robustness)时,他巧妙地引入了工程学和控制论中的反馈机制概念,这使得我对如何构建抗干扰能力强的分析模型有了全新的理解。书中的图示和流程图设计也值得称赞,它们不是那种标准化的、呆板的教科书插图,而是更像手绘的思维导图,充满了设计感,能够有效降低理解高维空间中数据流动的认知负担。唯一让我感到略微遗憾的是,在某些高级优化算法的介绍部分,作者的论述略显简略,可能需要读者自行去查阅更专业的优化理论书籍来补充背景知识,这对于追求“一站式学习”的读者来说,可能需要多花一些时间做跨章节的知识串联。
评分这本书的封面设计初见端倪,那种深邃的蓝色调,仿佛预示着即将深入未知的数据海洋。我一开始以为它会是一本偏重于理论推导的艰深著作,毕竟“理论与方法”这几个字摆在那里,总是让人联想到晦涩的公式和复杂的数学模型。然而,翻开第一章,我惊喜地发现,作者在构建理论框架的同时,非常注重将抽象的概念具象化。书中对各种经典统计学工具的引入,并非生搬硬套,而是紧密结合实际数据处理中的痛点。比如,在处理时间序列数据时,作者没有仅仅停留在ARIMA模型的层面,而是深入探讨了如何利用更现代的机器学习方法来捕捉非线性和高维特征的影响。那种讲解深度和广度的平衡感,让人在理解复杂算法的同时,也能体会到其背后的哲学思想——数据分析的最终目的永远是更好地理解世界,而非仅仅炫耀技术。我尤其欣赏它对“假设检验”这一基础概念的重新审视,作者提出了一个非常新颖的视角,即在海量数据时代,我们应该如何重新定义“显著性”的阈值,这无疑为我们这些在实际工作中经常与“P值”打交道的工程师提供了新的思考方向。
评分这本书给我最大的启发在于它对“不确定性量化”的执着。在很多数据分析实践中,我们往往被期望提供一个“精确”的答案,但现实是,数据总是充满噪声和偏见。这本书勇敢地直面了这一点,并花了大量篇幅来探讨如何科学地表达“我们不知道”的部分。作者没有回避贝叶斯方法的复杂性,而是通过一系列精心设计的蒙特卡洛模拟案例,让读者亲手体验到参数后验分布的形成过程。这种强调“过程而非结果”的教学理念,非常符合现代科学研究的趋势。另外,它对数据可视化在洞察力发现中的作用也给予了足够的重视,书中展示了许多超越常规散点图和柱状图的创新可视化技术,特别是那些用于揭示数据内在结构和关联性的网络图和热力图的构建细节,让我学到了很多在报告中能立刻应用的新技巧,极大地提升了我沟通分析结果的能力。
评分从整体结构来看,这本书的编写体现出作者深厚的学术积累和丰富的实战经验。它不像某些商业畅销书那样,为了追求轰动效应而过度简化或夸大某些技术的效果。相反,它以一种近乎严谨的学者态度,对每一种分析工具的适用边界和潜在陷阱进行了坦诚的剖析。例如,在讨论“大数据”的背景下,算法的效率和资源消耗问题被放在了与准确性同等重要的位置来讨论,这在同类书籍中是比较少见的。读完这本书,我感觉自己像是接受了一次高级数据科学“内功”的修炼,那些关于数据生成过程的假设、模型选择的依据、以及结果解释的严谨性,都得到了极大的强化。它不是教会你如何快速地跑出一个模型然后交差,而是教会你如何像一个真正的数据科学家那样去思考和规划整个分析项目,从数据源头的质量控制,到最终结论的可持续性验证,都有深入的探讨,确实是架起了理论与实际应用之间的一座坚实桥梁。
评分这本书的阅读体验,可以说是酣畅淋漓,但又带着一丝挑战。它绝非那种可以囫囵吞枣的入门读物。我感觉作者非常懂得如何设置一个“认知坡度”。起初的章节像是在为你铺设坚实的基础,通过一些清晰的案例,让你对数据处理的流程建立起直观认识。但随着章节的深入,内容的密度陡然增加,像是突然置身于一个布满精密齿轮的复杂机器内部。对于我这种习惯于自顶向下学习的读者来说,初期有些许不适,因为作者似乎更倾向于“由内而外”地构建体系。不过,一旦你适应了这种节奏,开始跟随作者的逻辑链条深入下去,那种豁然开朗的感觉是无与伦比的。特别是关于数据清洗和预处理的那几章,它不仅仅是教你用现成的库函数,而是深入剖析了数据失真背后的物理或社会成因,这使得最终的模型结果更具可解释性和可靠性。这本书的价值在于,它迫使你停下来,去思考工具背后的“为什么”,而不是仅仅满足于“如何操作”。
评分 评分 评分 评分 评分相关图书









本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有