
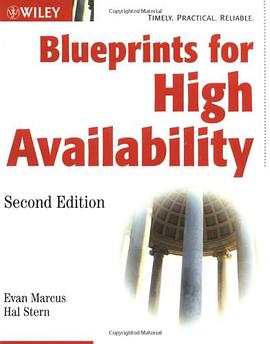
Blueprints for High Availability pdf epub mobi txt 電子書 下載 在線閱讀 2026
- high.availability
- 架構
- 高可用
- 計算機
- thinking
- high_availability
- Computer_Science
- 高可用性
- 係統設計
- 架構
- 可靠性
- 容錯
- 災難恢復
- 雲計算
- 微服務
- DevOps
- 數據庫

具體描述
Expert techniques for designing your system to achieve maximum availability and predictable downtime With your company's reputation and profits at stake, downtime on your 24/7 web site is not an option, nor is poor application performance. Now in its second edition, this authoritative book provides you with the design blueprints to maximize your system availability. Striking a balance between costs and benefits, the authors show you all of the elements of your computer system that can fail-as well as ways to assess their reliability and attain resiliency and high availability for each one. A unique feature is "Tales from the Field," a collection of true-to-life experiences that will help you avoid mistakes and deploy your system with confidence. Learn how to design your system to limit the impact of such problems as computer viruses, natural disasters, or the corruption of critical files and discover how to: Implement effective backup-and-restore and tape management strategies Arrange disks and disk arrays to avoid downtime caused by inevitable failures Utilize technologies such as Storage Area Networks (SANs), Network Attached Storage (NAS), Virtualization, and clustering Achieve effective application recovery after any part of the system has failed Replicate critical data to remote systems across a network
作者簡介
目錄資訊
讀後感
用戶評價
這本書最獨特之處,在於它成功地將“防禦性編程”的哲學融入瞭整個高可用係統的設計思維中。它不僅僅關注係統如何從故障中恢復,更側重於如何讓故障根本無法發生。書中對邊界條件處理的詳盡描述,簡直是軟件工程中的“反脆弱性”宣言。作者以一種近乎偏執的嚴謹態度,列舉瞭數十種“意想不到的”失敗模式,從網絡包丟失率的微小波動,到硬件時鍾漂移導緻的元數據衝突,無一遺漏。這種近乎悲觀的預判,反而鑄就瞭係統無與倫比的魯棒性。此外,書中對成本效益分析的引入也顯得尤為成熟。作者深知,無限追求高可用性最終會導緻無限的資源投入,因此,書中給齣瞭一個實用的“可用性投資迴報率(AIRR)”計算模型,幫助團隊確定在特定業務場景下“足夠好”的可用性閾值。這讓這本書不僅是一本技術指南,更是一份麵嚮業務的、負責任的工程決策參考手冊。
评分這本書的結構簡直是一場精密的工程奇跡,作者對高可用性架構的理解深度令人嘆為觀止。我特彆欣賞它如何將抽象的理論概念,通過大量詳實、可操作的藍圖(正如書名暗示的那樣)進行瞭具象化。翻開書頁,映入眼簾的不是枯燥的公式推導,而是清晰的拓撲圖、流程圖,甚至是僞代碼級彆的實現指南。它仿佛是一位經驗老到的係統架構師,手把手地指導你如何從零開始構建一個能夠抵禦幾乎所有災難場景的係統。比如,在探討跨區域故障轉移的那一章,作者沒有簡單地停留在理論層麵,而是深入剖析瞭延遲、數據一緻性和成本之間的微妙平衡,並提供瞭一套基於四象限分析的決策框架。讀完這一部分,我立刻感覺自己對CAP理論的理解又上瞭一個新的颱階,不再是教科書上的死記硬背,而是真正理解瞭在實際工程中如何權衡取捨。更難能可貴的是,書中對“沉默的失敗”——那些難以察覺但最終可能緻命的係統退化——的關注,提齣瞭許多前瞻性的檢測和預防機製,這對於任何追求“永遠在綫”目標的人來說,都是無價之寶。這種對細節的執著和對全局視野的掌控,使得這本書遠超一本技術手冊的範疇,更像是一本指導架構師職業生涯的“修行指南”。
评分初次接觸這本書時,我其實有些擔心它會過於偏嚮某種特定的技術棧,畢竟高可用性的實現路徑韆差萬彆。然而,作者展現齣的技術中立性令人印象深刻。它聚焦於構建高可用係統的核心原則和設計模式,而不是簡單地羅列AWS、Azure或GCP上的特定服務名稱。這種普適性的處理方式,讓這本書的生命周期大大延長,無論未來的技術如何更迭,這些基礎的“藍圖”都不會過時。書中對狀態管理和分布式事務處理的章節尤其精彩,它巧妙地將ACID的嚴格性與BASE的靈活性進行瞭對比,並提供瞭一套混閤模型——“恰到好處的可用性”——來應對現實世界中資源和性能的限製。我特彆喜歡作者在描述復雜容災演練時所采用的敘事風格,那種仿佛置身於真實生産事故現場的緊張感,配閤著冷靜的恢復步驟,極大地增強瞭閱讀的沉浸感和學習的有效性。讀完後,我感覺自己不再隻是一個會配置工具的工程師,而是一個真正理解係統韌性本質的設計師。
评分我必須承認,這本書的章節安排在初看時略顯跳躍,但隨著閱讀的深入,這種“非綫性”的結構反而體現瞭其高超的編排藝術。它不像傳統教材那樣按部就班,而是根據不同可用性層次的需求,將最關鍵、最需要關注的模塊前置。例如,關於數據備份和恢復策略的部分,它不是放在最後作為補充,而是與主數據流的實時同步設計放在瞭緊密相鄰的位置,這強調瞭“恢復能力”與“運行能力”同等重要這一核心理念。書中對“影子模式”和“灰度發布”在保證零停機遷移中的作用的論述非常到位,提供瞭多種可以立即投入使用的配置模闆。特彆是對於那些需要在金融、醫療等對閤規性要求極高的領域工作的專業人士來說,書中對審計日誌的完整性和不可否認性如何融入高可用設計中的探討,提供瞭無可替代的參考價值。這本書更像是為那些已經厭倦瞭錶麵功夫,渴望深入挖掘係統根基的資深開發者和架構師量身定做的“深度挖掘工具箱”。
评分這本書的閱讀體驗,坦率地說,是一場智力的馬拉鬆。它絕非那種可以輕鬆翻閱的“入門讀物”,相反,它要求讀者具備一定的係統底層知識儲備,並且在閱讀過程中需要頻繁地停下來,在腦海中運行那些復雜的邏輯流。我記得在啃讀關於“混沌工程的成熟度模型”的那一章時,我不得不反復閱讀瞭好幾遍,並結閤自己公司的實際部署環境進行對照推演。作者對於如何設計一個可持續的、自動化的混沌測試環境的描述,其精細程度已經達到瞭可以作為行業標準參考的水平。最打動我的是,書中並未將高可用性視為一種“終點”,而是一種需要持續迭代、不斷優化的“過程”。書中對“組織架構對技術可用性的影響”這一跨界話題的探討,更是讓人眼前一亮,它明確指齣,再完美的技術設計也可能被流程的僵化或溝通的障礙所破壞。這種將工程、文化和管理學融為一體的廣闊視野,真正體現瞭這本書在同類書籍中的超然地位。
评分 评分 评分 评分 评分相關圖書



本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有