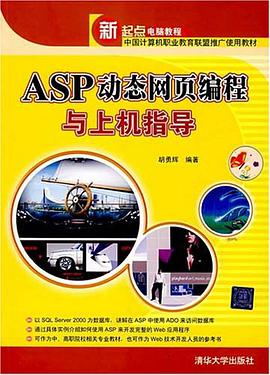

ASP动态网页编程与上机指导

ASP动态网页编程与上机指导 pdf epub mobi txt 电子书 下载 在线阅读 2026

☆☆☆☆☆
出版者:清华大学 作者:胡勇辉 出品人: 页数:400 译者: 出版时间:2007-9 价格:36.00元 装帧: isbn号码:9787302161141 丛书系列:
图书标签
  • 大學教科書
  • 2009
  • ASP
  • 动态网页
  • 编程
  • 上机指导
  • Web开发
  • Visual Basic
  • 服务器端脚本
  • 数据库
  • 网页设计
  • 教程
想要找书就要到 小哈图书下载中心
立刻按 ctrl+D 收藏本页
你会得到大惊喜!!

具体描述

ASP是微软开发的一种基于IIS的开放式的服务器端脚本环境,它也是目前最流行的Web应用程序开发工具之一。本书将围绕ASP,由浅入深,从基础到应用,并以SQL Server 2000作为数据库,详细介绍ASP在Web应用程序中的应用。

本书共10章,第1~4章详细介绍了ASP的相关基础知识,第5~6章介绍了SQL Server 2000数据库的基本操作以及如何在ASP中使用ADO来访问数据库,第7~10章则通过4个具体示例介绍了如何使用ASP来开发完整的Web应用程序。

本书结构清晰,内容丰富,实例详尽,可作为高等院校、高职高专以及中等职业学校的培训教材,也可作为Web技术开发人员的参考用书,是一本难得的ASP学习指南。

好的,以下是一份关于一本与您提到的图书内容完全不同的图书的详细介绍,旨在满足您“不包含”原书内容、内容详实、自然流畅的要求。 --- 《深度学习:理论、模型与前沿应用》 书籍定位: 本书旨在为希望系统掌握深度学习核心理论、理解主流模型架构并探索其在实际复杂问题中应用的读者提供一本权威、全面且深入的参考指南。它不仅仅是一本入门读物,更是一本能够支撑读者进行深入研究和工程实践的知识宝库。 目标读者: 对人工智能、机器学习有扎实基础,希望深入理解深度学习内在机制的计算机科学专业学生和研究人员。 希望将深度学习技术应用于工业界复杂场景(如自然语言理解、高精度图像识别、语音合成)的软件工程师和数据科学家。 希望跟进深度学习最新进展,探索前沿研究方向的学者和技术人员。 --- 第一部分:理论基石与数学原理(构建坚实的基础) 本部分聚焦于深度学习成功的数学和统计学根基,确保读者不仅知道“如何做”,更明白“为什么能成功”。 第一章:机器学习回顾与深度学习的起源 从传统机器学习到神经网络: 对线性回归、支持向量机(SVM)、决策树等经典模型的快速回顾,重点分析它们的局限性,从而引出特征工程的瓶颈。 神经元的数学模型: 详细剖析感知机模型,引入激活函数(Sigmoid, Tanh, ReLU及其变体)的必要性与作用。探讨非线性假设空间的重要性。 深度学习的驱动力: 分析大数据、高性能计算(GPU)和优化算法的进步如何共同推动了深度学习的兴起。 第二章:优化算法与反向传播机制 损失函数的设计哲学: 深入探讨均方误差(MSE)、交叉熵(Cross-Entropy)在分类和回归任务中的适用场景与数学推导。 梯度下降的进化: 详细介绍标准梯度下降(SGD)、带动量(Momentum)、自适应学习率方法(AdaGrad, RMSProp, Adam, NAdam)的原理、收敛速度比较及其在不同模型中的表现差异。 反向传播(Backpropagation)的精妙: 采用链式法则的视角,详细拆解误差如何从输出层逐层向输入层回传,并提供清晰的数学推导,确保读者能够手写实现此核心算法。 第三章:正则化、泛化与模型稳定性 过拟合的度量与控制: 深入探讨偏差-方差权衡(Bias-Variance Trade-off)。 正则化技术的全景图: 详细解析L1/L2正则化、Dropout(及其在不同层级的应用差异)、数据增强(Data Augmentation)作为正则化手段的原理。 批归一化(Batch Normalization): 阐述BN层如何解决内部协变量偏移(Internal Covariate Shift)问题,及其对训练速度和模型稳定性的巨大影响。 --- 第二部:核心架构与经典模型(理解主流范式) 本部分是本书的骨干,系统梳理并剖析了支撑现代AI应用的两大支柱——卷积网络与循环网络。 第四章:卷积神经网络(CNN)的结构与设计 卷积操作的数学本质: 深入解释卷积核(Filter)、填充(Padding)和步幅(Stride)对特征提取的影响。 经典架构的演进: 对LeNet、AlexNet、VGG的结构进行透视分析,重点关注深度加深带来的挑战与解决方案。 残差连接的突破(ResNet): 详尽讲解残差块(Residual Block)如何允许网络堆叠数百层而不发生性能退化,这是深度网络设计的一个里程碑。 Inception与深度可分离卷积: 分析GoogleNet如何通过“Inception模块”在保持网络稀疏性的同时增加宽度和效率;探讨MobileNet中深度可分离卷积的效率优势。 第五章:循环神经网络(RNN)与序列建模 序列数据的挑战: 分析标准RNN在处理长距离依赖时面临的梯度消失/爆炸问题。 长短期记忆网络(LSTM)详解: 细致解析输入门、遗忘门、输出门的工作机制及其如何协同作用于细胞状态(Cell State)的更新,实现对长期信息的选择性记忆。 门控循环单元(GRU): 对比LSTM的简化版本GRU,分析其在计算效率和表达能力之间的权衡。 双向RNN与深度堆叠: 讨论如何利用双向结构捕获上下文信息,以及堆叠RNN层在序列表示学习中的作用。 --- 第三部:前沿模型与新兴领域(迈向尖端研究) 本部分将读者的视野从基础模型扩展到当前最热门、最具影响力的Transformer架构及其衍生应用。 第六章:注意力机制与Transformer架构 注意力机制的诞生与重要性: 从Seq2Seq模型的瓶颈出发,引入“注意力”概念,解释它如何允许模型动态关注输入序列中最相关的部分。 自注意力(Self-Attention)的完全解析: 详细推导Scaled Dot-Product Attention的Q(Query)、K(Key)、V(Value)矩阵运算过程。 Transformer的核心构建块: 深入剖析Multi-Head Attention的并行化优势,以及位置编码(Positional Encoding)如何为无序的自注意力机制引入序列信息。 编码器-解码器结构: 对比原始Transformer在机器翻译中的应用,以及仅包含编码器(如BERT)和仅包含解码器(如GPT)的架构差异。 第七章:生成模型:从变分自编码器到生成对抗网络 变分自编码器(VAE): 从概率角度理解VAE,解析重参数化技巧(Reparameterization Trick)在实现端到端训练中的关键作用。 生成对抗网络(GAN)的博弈论基础: 深入阐述生成器(Generator)和判别器(Discriminator)之间的纳什均衡点。 GAN的进阶: 探讨WGAN(Wasserstein GAN)如何通过新的距离度量来解决训练不稳定的问题,以及DCGAN在图像生成中的应用。 扩散模型(Diffusion Models)简介: 概述当前最先进的生成技术,如DDPM,及其在高质量图像和音频合成中的潜力。 第八章:模型部署、可解释性与伦理考量 模型压缩与加速: 介绍模型剪枝(Pruning)、量化(Quantization)和知识蒸馏(Knowledge Distillation)等技术,以实现模型在边缘设备上的高效部署。 深度学习的可解释性(XAI): 讨论LIME、SHAP值等工具如何帮助我们理解模型为何做出特定决策,这对高风险领域的应用至关重要。 AI伦理与公平性: 分析模型中潜在的偏见来源(数据、算法),并探讨减轻算法偏见和确保模型公平性的技术路径。 --- 附录:实战环境与工具链 本书在理论讲解的同时,辅以大量的Python代码示例,重点围绕PyTorch生态系统展开。附录将提供环境配置指南,重点介绍: 1. PyTorch张量操作与自动微分机制。 2. 使用`torchvision`和`torchaudio`库处理标准数据集。 3. 模型保存、加载与分布式训练的初步实践。 总结: 《深度学习:理论、模型与前沿应用》力求在深度和广度之间取得完美的平衡。它不仅追溯了深度学习的核心理论,更前瞻性地介绍了Transformer、生成模型等现代AI技术。本书的结构设计确保读者能够从坚实的数学基础出发,逐步掌握复杂网络的构建与优化,最终能够独立分析和解决前沿的AI挑战。

作者简介

目录信息

读后感

☆☆☆☆☆

☆☆☆☆☆

☆☆☆☆☆

☆☆☆☆☆

☆☆☆☆☆

用户评价

☆☆☆☆☆

这本书的语言风格是那种非常朴实、直击要害的理工科写作范式。没有华丽的辞藻,完全以技术表达为核心,每一句话似乎都承载着明确的信息量,力求在最短的篇幅内传递最精确的知识点。我记得当初为了理解某个复杂的异步操作处理流程,我反复阅读了书中关于错误捕获和异常处理机制的那几页。作者用极其简洁的伪代码和流程图,将一个原本容易让人迷失的调用栈清晰地展示出来。这种对清晰度和准确性的极致追求,使得本书成为了当时技术小组内部共同参考的“标准指南”。即使在某些章节,作者坦承某些技术点是当时的最佳实践,但也明确指出了其潜在的局限性,这种坦诚的态度非常值得称赞。它鼓励读者批判性地看待所学知识,而不是盲目接受,这种培养独立思考的阅读体验,让这本书的价值超越了其所教授的具体技术本身。

☆☆☆☆☆

这本书的讲解风格,与其说是教科书,不如说更像是一位经验丰富的老工程师在手把手带徒弟。它最大的特点在于对“实战”的偏执追求。我记得书中有大量的“上机指导”环节,这些环节绝不是简单地复制粘贴代码,而是会详细剖析每行代码背后的逻辑含义,以及在不同应用场景下的优化思路。比如,书中对表单提交的安全处理,在那个网页安全意识还未完全普及的年代,就已经给出了非常前瞻性的指导,强调了输入验证和防止SQL注入的重要性。这种注重细节和实操性的编写方式,极大地培养了我的严谨编码习惯。我尤其欣赏作者在讲解复杂逻辑时,总能用非常形象的比喻来解释抽象的概念,使得那些原本晦涩难懂的服务器端脚本运行机制,变得清晰可见。读完特定章节后,你立刻就能打开IDE,按照书中的步骤搭建出一个功能完备的小系统,这种即时反馈的学习体验,是很多现代教材所缺乏的,它真正做到了“学以致用”,让读者从一开始就建立起强烈的成就感。

☆☆☆☆☆

时过境迁,虽然现在很多技术栈已经被更新换代,但重温这本书,依然能感受到它深厚的底蕴和作者对技术栈的深刻理解。这本书在讲解过程中,并不局限于单纯的语法堆砌,它花了相当大的篇幅去探讨Web应用的生命周期管理和性能优化策略。我记得有一章专门讨论了如何利用Session和Application对象来维护用户状态,那段文字将两者在作用域和生命周期上的差异对比得淋漓尽致。更值得称道的是,它引入了一些关于代码重构和模块化设计的初步概念,这在当时的项目中是非常先进的思路。作者没有满足于让程序“跑起来”,而是力求让程序“跑得好”。阅读过程中,你会发现许多看似简单的问题,在书中都能找到多维度的分析角度,比如从服务器负载、内存占用等多个维度去权衡不同的实现方案。这种全面且深入的剖析,对于打下坚实的计算机基础是极其有益的,它教会的不仅仅是一种特定的语言,更是一种解决问题的系统性思维框架。

☆☆☆☆☆

这本书的装帧和内容结构,似乎是专门为自学和课堂辅导双重需求而设计的。每一章的末尾,总会附带着一系列的“上机实践题”和“思考与探索”环节。实践题往往是要求你根据前文所学知识点,独立完成一个小功能的开发,比如实现一个简单的留言板或者一个用户登录验证系统;而“思考与探索”则更偏向理论深挖,引导读者去探究底层原理,比如为什么某个函数在特定的服务器配置下会表现出不同的效率。这种结构设计,有效地将知识的输入、输出和延伸学习形成了一个完整的闭环。我当时正是通过这些配套的练习题,真正将书本上的知识“消化”掉了。这本书的价值不在于它包含了多少代码,而在于它提供了一套完整的“内功心法”,让读者在掌握具体招式后,依然有能力去应对未知的变化和挑战。可以说,它培养的不仅仅是“代码工人”,更是有潜力的“系统构建者”。

☆☆☆☆☆

这本书的封面设计得很有年代感,那种略显老旧的排版和色彩搭配,让人一下子回到了那个互联网技术飞速发展的初期。我拿到这本书时,首先吸引我的是它详尽的目录,几乎涵盖了当时所有主流的动态网页开发技术栈。我记得那会儿刚开始接触编程,对“动态”这个概念感到既好奇又有点迷茫,这本书就像一本通往新世界的大门。它没有过多花哨的理论灌输,而是非常务实地从最基础的IIS配置讲起,一步步教你如何搭建起一个能够处理用户请求的Web服务器环境。特别是书中对Active Server Pages(ASP)的讲解,深入浅出,即便是对后端逻辑一窍不通的新手,也能通过书中的代码示例,搭建出自己的第一个带后台交互的页面。我记得最清楚的是关于数据库连接的部分,那种手把手教你写ADO对象模型的教程,让原本枯燥的SQL查询变得生动起来,仿佛你能亲眼看到数据如何在服务器和客户端之间流动。这本书对于那个时代的编程学习者来说,无疑是一份极其宝贵的财富,它搭建起了一套完整的、可操作的知识体系,让人能够快速上手实践,而不是仅仅停留在纸上谈兵的理论阶段。
☆☆☆☆☆

☆☆☆☆☆

☆☆☆☆☆

☆☆☆☆☆

☆☆☆☆☆