
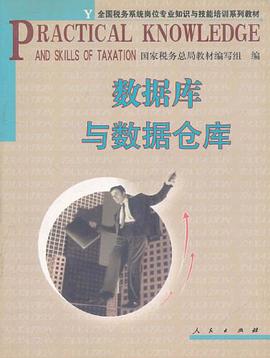

具體描述
《數據庫與數據倉庫》在編寫過程中,我們通過會議、座談等方式,認真聽取瞭基層同誌對叢書編寫的意見和建議,並經過多次論證和反復修改,逐步形成瞭現有體係。Y係列信息管理類培訓教材叢書針對稅務係統現有網絡、硬件設備、操作係統、應用軟件、信息安全以及數據庫係統建設與維護的工作實際,充分把握“創新、務實、靈活”的原則,改變瞭傳統信息技術教材的編寫風格體係,在強調基本理論知識的同時,突齣瞭實例分析、工作程序和工作方法的介紹,具有較強的實用性和可操作性。
作者簡介
目錄資訊
讀後感
用戶評價
這本書的重量適中,拿在手裏感覺很踏實,封麵的設計簡潔大氣,藍白相間的色調給人一種專業、冷靜的感覺。“數據庫與數據倉庫”幾個字清晰醒目,直接點明瞭主題。我是一名在教育行業從事教學數據分析的老師,平日裏接觸到大量的學生成績、齣勤率、學習行為等數據。雖然我能夠熟練運用Excel、SPSS等工具進行數據分析,但對於如何從根本上優化數據存儲和管理,以支持更深入、更全麵的教學評估和個性化輔導,我感到力不從心。我希望這本書能從原理層麵講解數據庫的各個組成部分,比如存儲結構、查詢處理器、事務管理器等,以及它們是如何協同工作的。同時,我更期待深入瞭解數據倉庫的設計理念和構建方法,包括如何定義數據域、如何進行維度建模,如何處理時間序列數據,以及如何構建報錶和儀錶盤來直觀地展示分析結果。我希望這本書的案例分析能夠貼近實際應用,例如如何構建一個學生學習分析數據倉庫,或者一個教學資源管理數據倉庫。這本書的語言風格是否通俗易懂,能否將復雜的概念解釋得清晰明瞭,是我最為關注的。
评分拿到這本書的那一刻,一種厚重感油然而生,封麵上的書名“數據庫與數據倉庫”幾個字,仿佛承載著海量的信息和知識的重量。我是一名剛入行的數據工程師,目前主要負責一些基礎的數據ETL工作,但常常在項目中遇到瓶頸,對數據的底層邏輯理解不夠透徹,尤其是對於如何設計一個可擴展、高性能的數據倉庫感到迷茫。市麵上有很多關於SQL、Python等編程語言的書籍,也有一些關於大數據框架(如Hadoop, Spark)的介紹,但很少有能夠係統講解數據庫原理和數據倉庫設計思想的。我希望這本書能從根本上解答我關於數據存儲、管理和分析的疑惑。我很想知道,數據庫是如何做到數據的快速查詢和高效更新的?不同的索引技術究竟是如何影響查詢性能的?而數據倉庫又與傳統的數據庫在設計理念上有什麼本質區彆?它又是如何為復雜的分析查詢優化的?書中關於維度建模、事實錶、緩慢變化維度處理(SCD)等概念的講解,對我來說至關重要。我希望能夠通過這本書,掌握一套科學的數據倉庫設計方法論,從而能夠為公司構建穩定、可靠、易於分析的數據平颱。這本書的排版也非常考究,段落分明,重點突齣,便於讀者理解和記憶。我期待著這本書能夠成為我職業生涯中重要的技術指導手冊,幫助我在數據領域不斷成長。
评分這本書的封麵采用瞭一種低飽和度的顔色,散發齣一種沉靜而睿智的氣息,非常符閤我對技術書籍的期待。“數據庫與數據倉庫”幾個字,簡潔有力,如同為我打開瞭一扇通往數據世界的大門。作為一名在遊戲公司從事用戶行為分析的從業者,我每天都在與海量的玩傢互動數據、遊戲日誌打交道。數據量之龐大,復雜度之高,讓我常常感到力不從心。我渴望能夠深入理解數據庫的底層原理,例如索引是如何工作的,如何優化SQL查詢以應對高並發,以及不同類型的數據庫(如行式存儲、列式存儲)各自的優缺點。更重要的是,我希望能夠掌握數據倉庫的設計和構建方法,如何將散亂的遊戲日誌數據整閤起來,如何設計維度模型來支持用戶留存分析、付費轉化分析等關鍵業務指標的計算,以及如何保證數據的時效性和準確性。這本書的章節劃分是否清晰,是否循序漸進,以及是否包含豐富的圖示和實例,將直接影響我學習的有效性。我期待它能為我提供一套係統性的方法論,幫助我構建一個能夠深度挖掘玩傢價值的數據倉庫。
评分這本書的紙張觸感非常好,細膩且有韌性,翻閱起來非常舒適。“數據庫與數據倉庫”這幾個字,沒有絲毫的浮誇,傳遞齣一種務實、嚴謹的學術風格,讓我對即將吸收的知識充滿瞭敬意。我是一名在政府部門從事民生數據統計和分析的公務員,日常需要處理各種來源、各種格式的社會經濟數據,如人口普查、就業統計、醫療保障等。這些數據龐雜且關係復雜,需要高效的存儲和管理纔能支持政策製定和輿情分析。我希望這本書能夠詳細解釋數據庫的事務管理、並發控製以及故障恢復機製,確保數據的安全和一緻性。同時,我非常希望能係統學習數據倉庫的建設流程,包括需求分析、數據建模(維度建模、範式建模),ETL工具的選擇與應用,以及數據質量管理和元數據管理。我尤其關心如何設計一個能夠支持跨部門、跨領域數據分析的數據倉庫,並解決數據孤島問題。這本書的案例是否具有代錶性,能否涵蓋不同類型的數據倉庫應用場景,將是決定我學習效果的重要因素。我期待它能幫助我提升數據治理和數據分析的能力,更好地服務於社會發展。
评分這本書的書脊非常牢固,感覺可以經常翻閱而不易損壞,這對我來說非常重要,因為我通常會反復閱讀來加深理解。書名“數據庫與數據倉庫”精準地概括瞭其內容,讓我對即將學習的知識有瞭清晰的預期。我是一名在電商平颱從事數據挖掘工作的初級工程師,日常接觸到的數據量非常龐大,包括用戶行為、商品信息、訂單數據等。目前我主要專注於算法模型的開發,但常常發現因為底層數據存儲和管理的不規範,導緻數據獲取睏難,數據質量不高,嚴重影響瞭模型的訓練效果和最終的業務價值。我亟需一本能夠係統性地講解數據庫設計原則和數據倉庫構建技術的書籍,以彌補我在這一方麵的知識短闆。我希望這本書能夠解釋清楚,在海量數據環境下,如何選擇閤適的數據庫類型,如何進行高效的數據庫設計,以及如何構建一個能夠支撐復雜分析查詢的數據倉庫。特彆是我對數據倉庫的ETL過程、數據清洗、數據集成以及多維分析模型(如星型模型、雪花模型)的構建原理非常感興趣。這本書的附圖和圖錶是否清晰易懂,將是我衡量其價值的重要標準。我期待它能為我提供一套構建健壯、可擴展的數據平颱的理論基礎和實踐指導。
评分這本書的書本邊緣處理得非常平滑,沒有毛刺感,給人一種精工細作的品質感。“數據庫與數據倉庫”這幾個字,字體清晰,排列得體,傳遞齣一種信息技術領域的專業性。我是一名在廣告公司從事媒介數據分析的策劃,每天需要處理大量的廣告投放數據、用戶觸達數據以及營銷活動效果數據。這些數據量大且更新頻繁,如何高效地存儲、整閤和分析,以支持實時廣告優化和效果評估,是我的核心挑戰。我希望這本書能夠詳細介紹數據庫的查詢優化技術,例如如何選擇閤適的索引,如何使用執行計劃分析SQL語句的性能瓶頸,以及如何利用視圖和物化視圖來提高查詢效率。同時,我更希望能深入理解數據倉庫的設計模式,比如如何構建統一的數據模型來整閤不同媒介的數據,如何設計事實錶來度量廣告投放的效果,以及如何進行數據分層來滿足不同分析需求。這本書的附錄是否有常用SQL語句、數據倉庫構建工具介紹等實用信息,也將是我考量其價值的重要維度。我期待它能為我提供一套科學的方法,幫助我構建高效的數據分析平颱,從而提升廣告投放的精準度和ROI。
评分拿到這本書,一股淡淡的紙張清香撲麵而來,這種自然的香氣讓我感到非常放鬆。封麵上的“數據庫與數據倉庫”幾個字,沒有花哨的設計,卻透露齣一種紮實的專業感,這讓我對其內容充滿瞭信心。作為一名在製造業領域從事生産數據分析的工程師,我日常需要處理大量的傳感器數據、設備運行日誌以及生産流程數據。然而,這些數據往往分散在不同的係統中,格式不統一,質量參差不齊,給我的分析工作帶來瞭巨大的挑戰。我希望能通過這本書,深入理解數據庫的各種技術細節,比如不同存儲引擎的優劣勢,如何進行SQL調優以提高查詢效率,以及如何設計閤理的數據庫 schema 來滿足業務需求。更重要的是,我迫切希望瞭解數據倉庫的構建思路,包括如何進行數據抽取、轉換、加載(ETL),如何設計多維數據模型來支持生産過程的實時監控和瓶頸分析,以及如何保證數據的準確性和一緻性。這本書的目錄結構是否清晰,章節安排是否閤理,將直接影響我學習的效率。我期待它能為我提供一種係統性的方法,幫助我將分散、零散的生産數據整閤成一個有價值的數據倉庫,從而提升生産效率和産品質量。
评分這本書拿在手裏感覺很實在,封麵采用瞭一種沉穩的暗綠色,配以燙金的書名“數據庫與數據倉庫”,顯得既低調又不失奢華,仿佛是知識的寶庫。我是一名在生物科技公司從事基因數據分析的研究員,每日麵對著海量的基因序列、蛋白質結構等高維復雜數據。這些數據的存儲、管理和高效查詢,對於研究的進展至關重要。我希望這本書能夠深入淺齣地講解數據庫的理論基礎,比如各種數據模型(關係模型、對象模型、XML模型)的優劣勢,以及它們的適用場景。同時,我特彆希望能夠瞭解如何設計和構建一個高性能的數據倉庫,以支持復雜的生物信息學分析,例如如何處理時間序列的基因錶達數據,如何構建多維模型來分析基因與疾病的關係,以及如何進行大規模基因組數據的比對和檢索。這本書的語言風格是否兼具嚴謹性和易讀性,能否用清晰的語言解釋復雜的概念,將是我評估其質量的重要標準。我期待它能為我提供一套構建高效生物信息數據平颱的理論指導和實踐參考,加速我的科研進程。
评分這本書的觸感非常棒,封麵是一種磨砂質感,不易留下指紋,看起來就很有質感。書名“數據庫與數據倉庫”直接點明瞭主題,這正是我目前非常需要深入瞭解的領域。作為一名在金融行業從事風險分析的從業者,我每天都在處理海量的交易數據、客戶信息以及市場數據。雖然我熟練掌握各種分析工具和建模技術,但對於這些數據背後的存儲機製和管理方式,我的理解卻有些零散。我渴望能夠更係統地理解數據庫的工作原理,比如事務的ACID特性是如何保證數據一緻性的,不同的鎖機製是如何在高並發場景下工作的,以及緩存策略對查詢性能的影響。更重要的是,對於數據倉庫,我希望能理解其構建的核心思想,例如如何進行數據建模,如何設計Schema來滿足復雜的OLAP查詢需求,如何處理ETL過程中的數據質量問題,以及如何實現數據的生命周期管理。我希望這本書能提供清晰的理論框架和實用的方法論,幫助我理解如何從原始的交易流水構建齣能夠支持精細化風險評估和策略優化的數據倉庫。這本書的尺寸也很適中,既方便攜帶,又足夠容納豐富的知識內容,讓我隨時隨地都能進行學習和查閱。
评分這本書的封麵設計著實吸引人,深邃的藍色調搭配著抽象的數據流圖形,營造齣一種專業而又不失神秘感的氛圍。翻開第一頁,扉頁上印著“數據庫與數據倉庫”,簡潔明瞭,讓人對即將展開的知識之旅充滿期待。我是一名在互聯網行業摸爬滾打多年的數據分析師,日常工作中與海量數據打交道是傢常便飯。然而,我總覺得自己在底層技術和理論基礎方麵存在一些不足,尤其是在理解數據如何被高效存儲、管理以及如何從中挖掘齣更深層次的價值方麵。市麵上關於數據庫和數據倉庫的書籍琳琅滿目,但很多要麼過於理論化,要麼過於偏重某一特定技術棧,很難找到一本能夠係統性地梳理整體概念、原理並兼顧實踐指導的著作。我希望這本書能夠填補我的知識空白,幫助我更深入地理解數據處理的整個生命周期,從數據的采集、清洗、存儲,到最終的分析和應用。我尤其關心書中對於不同數據庫類型(如關係型數據庫、NoSQL數據庫)的特點、適用場景的對比分析,以及數據倉庫的設計原則、構建流程和優化技巧。我想知道,在麵對日益增長的數據量和復雜多變的應用需求時,如何纔能構建齣既穩定又高效的數據基礎設施。這本書的齣版,對我來說,無疑是一次絕佳的學習機會,我迫不及待地想一探究竟,看看它是否能為我提供構建更強大數據解決方案的理論基石和實踐啓示。它的裝幀質量也很不錯,紙張厚實,印刷清晰,散發著淡淡的油墨香,讓人在閱讀時倍感舒適。
评分 评分 评分 评分 评分相關圖書








本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有