
具体描述
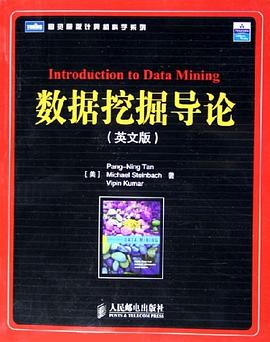
《数据挖掘导论》(英文版)对数据挖掘进行了全面介绍,旨在为读者提供将数据挖掘应用于实际问题所必需的知识。《数据挖掘导论》(英文版)涵盖五个主题:数据、分类、关联分析、聚类和异常检测。除异常检测外,每个主题都有两章:前面一章讲述基本概念、代表性算法和评估技术,而后面一章较深入地讨论高级概念和算法。目的是在使读者透彻地理解数据挖掘基础的同时,还能了解更多重要的高级主题。此外,书中还提供了大量例子、图表和习题。
作者简介
Pang-Ning Tan现为密歇根州立大学计算机与工程系助理教授,主要教授数据挖掘、数据库系统等课程。此前,他曾是明尼苏达大学美国陆军高性能计算研究中心副研究员(2002-2003)。
Michael Steinbach 明尼苏达大学计算机与工程系研究员,在读博士。
Vipin Kumar明尼苏达大学计算机科学与工程系主任,曾任美国陆军高性能计算研究中心主任。他拥有马里兰大学博士学位,是数据挖掘和高性能计算方面的国际权威,IEEE会士。
目录信息
1.1 What Is Data Mining?
1.2 Motivating Challenges
1.3 The Origins of Data Mining
1.4 Data Mining Tasks
1.5 Scope and Organization of the Book
1.6 Bibliographic Notes
1.7 Exercises
2 Data
2.1 Types of Data
2.1.1 Attributes and Measurement
2.1.2 Types of Data Sets
2.2 Data Quality
2.2.1 Measurement and Data Collection Issues
2.2.2 Issues Related to Applications
2.3 Data Preprocessing
2.3.1 Aggregation
2.3.2 Sampling
2.3.3 Dimensionality Reduction
2.3.4 Feature Subset Selection
2.3.5 Feature Creation
2.3.6 Discretization and Binarization
2.3.7 Variable Transformation
2.4 Measures of Similarity and Dissimilarity
2.4.1 Basics
2.4.2 Similarity and Dissimilarity between Simple Attributes
2.4.3 Dissimilarities between Data Objects
2.4.4 Similarities between Data Objects
2.4.5 Examples of Proximity Measures
2.4.6 Issues in Proximity Calculation
2.4.7 Selecting the Right Proximity Measure
2.5 Bibliographic Notes
2.6 Exercises
……………………………………………
· · · · · · (收起)
读后感
它是我关于数据挖掘这一方向的入门书。 书中讲了很多基础的数据挖掘算法,读完以后可以对这些算法的基本思想有个了解。书中的例子也很详尽,还是不错的。 但是研究生期间是指望发论文的,这些算法从学术上来说,只能算基础入门了。至于它们在实际工业应...
该书特点:以实例为重,给出了常用算法的伪代码,和《模式识别》、《模式分类》等专著比起来,该书略去了各个定理的证明部分,并通过大量枚举具体的分类实例,来简要说明算法的流程和意义。 根据个人的体验,觉得这本书作为第一本数据挖掘的入门读物是再恰当不过的了。...
这本书写得逻辑性比较强,全面,而且我觉得涉及的东西也比较底层,让我们了解一些算法的基本型原理是非常重要的。如果,网上的机器学习相关文章看不懂的话,可以从这本书入手。中文版的只看过一点点,感觉完全没逻辑性,完全没感觉。翻译出来完全就变味了,毕竟是语言习惯上的...
这本书介绍的比较全面,某些内容在一般的书中是很少介绍的,内容浅显易懂。本人开始看中文版的,觉的中文版的写的不错,后来又看英文版的,就发现中文版的差太多了,推荐英文版的
用户评价
这本书的引人之处,首先在于它对“思维模式”的强调,而非单纯的技术堆砌。我过去在实际项目中遇到的最大挑战,不是找不到算法,而是不知道该用什么思路去解决那个特定的业务问题。我希望能从这本书中学到的是一种“数据驱动的决策制定流程”,一种系统性的思考框架。比如,在初识阶段,作者是如何界定“数据挖掘”与“机器学习”、“统计学”之间的微妙界限的?这些概念的澄清,对于建立正确的认知基石至关重要。如果它仅仅是把各种算法(如决策树、聚类、关联规则)罗列出来,并给出它们的数学公式,那它和网上随处可见的教程并没有太大区别。我更关注的是,作者如何将这些技术串联起来,形成一个解决实际问题的闭环。例如,在介绍某一类算法时,是否穿插了真实的行业案例,展示了在面对噪声数据、不平衡样本或维度灾难时,数据科学家们是如何进行“取舍”和“工程化”的?这种实战智慧的传授,远比理论推导来得宝贵。如果这本书能像一位资深顾问一样,告诉我“在什么场景下,不要用A算法,而应该考虑B算法的变体”,那它就真正具有了不可替代的价值。
这本书的“广度”和“前瞻性”也是我选择它时会重点考量的维度。数据挖掘领域发展迅猛,新的技术和伦理考量层出不穷。我希望它不仅仅停留在十年前的经典模型上,而是能对当前的热点领域有所覆盖。比如,对于高维数据的处理,是否讨论了降维技术(如PCA、t-SNE)在可视化和模型简化中的应用?更进一步,鉴于当前对数据隐私和算法公平性的日益关注,我非常期待书中能够设置专门的章节,探讨“可解释性AI”(XAI)的基本概念,以及如何在挖掘过程中规避潜在的偏见和歧视。如果能触及到这些前沿和伦理的议题,这本书的格局就会一下子打开,从一本单纯的技术手册升华为一本具有社会责任感的专业著作。仅仅教会如何“挖掘”是不够的,还需要教会我们如何“负责任地挖掘”。如果它能提供一个审慎的视角,引导读者思考技术应用的边界和后果,那么它对于任何希望在该领域有长远发展的人来说,都是一份极其宝贵的财富。
从阅读体验的角度来说,我非常看重教材的“可读性”和“适应性”。我不是科班出身的计算机专业,我的背景更偏向于商业分析和应用,因此,那些充斥着晦涩高等数学符号的章节,往往会成为我学习的巨大障碍。我希望这本书在平衡理论深度与实践易懂性上能做到恰到好处。例如,对于概率论和线性代数这些基础的数学工具,作者能否提供一种“够用就好”的介绍方式,侧重于解释它们在数据挖掘中的作用机制,而不是长篇累牍地证明定理?此外,我对它是否融入了现代化的工具栈也抱有很高的期望。如果书中还在大量依赖过时的软件或编程语言的示例,那么它的实用价值就会大打折扣。我期待看到对Python生态系统(如Pandas, Scikit-learn)中经典函数的介绍,哪怕只是简短的伪代码或概念示例,也能极大地降低我将其转化为实际操作的门槛。总之,一本好的入门读物,应该能够让一个有一定逻辑基础的初学者,在不感到过度挫败的情况下,逐步建立起对这个领域的信心和初步的操作能力。
我对任何技术书籍的最终评价,往往取决于它能否激发我进一步探索的欲望,而不是在读完后让我感觉知识已经“竣工”。这本书的“引导性”和“启发性”至关重要。我期待它在每个核心章节的末尾,都能提供一些高质量的“延伸阅读”或“进一步思考”的问题,而不是简单地总结本章内容。例如,在讲完经典的分类算法后,能否提出一个开放性的问题:“如果你的分类任务需要极高的实时性,你会如何权衡模型的复杂度和预测速度?”这样的设计,能促使读者跳出书本的框架,开始进行批判性思维和自主研究。此外,一本优秀的导论,应该能清晰地描绘出数据挖掘领域的“职业路径图”。它能否告诉读者,学完这本书,下一步应该深入学习哪一个细分领域(如自然语言处理、时间序列分析或深度学习),并推荐相应的进阶资源?如果这本书能充当一个“领航员”,为我的后续学习指明方向,那么它就完成了作为一本导论书籍的最高使命——播下好奇的种子,并提供探索的地图。
这本书的封面设计真是直击人心,那种深邃的蓝色调,配合着抽象的数据流图形,立刻让人感受到一股扑面而来的科技感与知识的厚重。我拿到手的时候,首先就被它精美的装帧吸引了,那种厚实的纸张和清晰的印刷质量,一看就知道是精心制作的出版物。虽然我过去也读过一些关于数据处理和分析的入门书籍,但大多侧重于工具的使用或特定算法的罗列,缺乏一种宏观的、体系化的构建。而这本书,从目录上看,它似乎试图搭建一个完整的知识框架,从数据采集的源头讲起,逐步深入到模型构建、评估与最终的商业应用。特别是它章节之间的逻辑过渡,非常顺畅,仿佛一位经验丰富的老教授,耐心地引导你一步步走入这个迷人的领域。我特别期待它在“数据预处理”和“特征工程”部分能提供一些深入且实用的见解,因为在我看来,数据挖掘的成败往往取决于这一阶段的精细打磨,而市面上很多书籍对这部分往往一笔带过。这本书的厚度也证明了内容的详实,我感觉它不仅仅是一本教科书,更像是一部可以长期放在手边,随时查阅和参考的工具箱。那种对复杂概念用清晰图示和恰当比喻来解释的努力,是衡量一本优秀技术书籍的重要标准,希望这本书能在这方面给我带来惊喜。
没认真看
没认真看
没认真看
没认真看
没认真看