
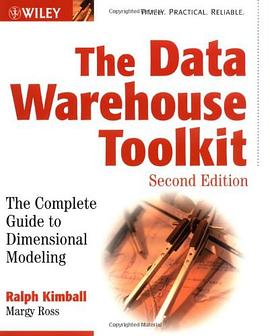
The Data Warehouse Toolkit pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 數據倉庫
- DW
- BI
- 建模
- 維度
- warehouse,moding
- 數據分析
- 阿男
- 數據倉庫
- 數據庫
- ETL
- 數據分析
- 商業智能
- 數據建模
- 數據集成
- 數據管理
- 數據質量
- 數據架構

具體描述
Single most authoritative guide from the inventor of the technique. * Presents unique modeling techniques for e-commerce, and shows strategies for optimizing performance.
* Companion Web site provides updates on dimensional modeling techniques, links related to sites, and source code where appropriate.
作者簡介
Ralph Kimball是Kimball集團的創建者。從20世紀80年代中期以來,他一直是數據倉庫和商業智能行業維度建模方法的思想開拓者。大量IT專業人士接受過其教育。自1996年以來,由他及其同事們所撰寫的工具箱係列書籍一直是最受讀者青睞的書籍。Ralph Kimball曾就職於Metaphor並建立瞭Red Brick係統,他在施樂Palo Alto研究中心(PARC)工作期間,與他人一起共同發明瞭星型工作站,這是首個利用視窗、圖標和鼠標的商業産品。Ralph Kimball畢業於斯坦福大學電子工程係並獲得博士學位。
Margy Ross是Kimball集團總裁。自1982年以來,她主要關注數據倉庫和商業智能,強調業務需求和維度建模的重要性。與Ralph Kimball一樣,Margy Ross也為許多學生講授過維度設計最佳實踐,她與Ralph Kimball閤作,共同撰寫瞭5本工具箱序列書籍。Margy Ross曾工作於Metaphor並與他人共同創立瞭DecisionWorks谘詢公司。她畢業於美國西北大學工業工程係並獲得碩士學位。
目錄資訊
讀後感
年后上班就在亚马逊下定了此书,结果亚马逊要15后才发货,收到后周末刚拜读了前两章,感觉翻译极差,语句晦涩难懂,没看过前两版,不知好不好,但建议有能力的,还是看英文原版吧。 凑个字 凑个字 凑个字
評分The lengthy list of date columns captures the spans of time over which the order is processed through the fulfillment pipeline. 日期列的长列表获取订单通过整个流水线处理过程的时间范围。
評分正如1楼所说的,书是好书,但中文版翻译的实在太烂了 貌似电子工业出版社已经不在出版了,在taobao上面买了中文拷贝版的,没办法,时间赶+英文不到家,但是,实在郁闷,翻译的连我这种英语不在行的人都能看出来有问题,现在是一边看中文,一边看电子版的E文。
評分前几章理论的东西太多了,问题是中文版的翻译真是太差了,句子都不通顺,谁能告诉我,这句话是什么意思 ‘也许您一直期望粒度由对事实表主键的传统生命描述’。。。翻译差 翻译差 翻译差 翻译差 翻译差 翻译差 翻译差 翻译差 翻译差
評分用戶評價
這本書的案例分析部分,簡直是教科書級彆的實踐寶典,其詳盡程度令人咋舌。作者似乎將他職業生涯中遇到的所有典型業務場景——從零售業的交易明細,到製造業的生産流程,再到金融服務的産品歸集——都進行瞭高度凝練和抽象化處理,然後作為生動的案例植入到理論講解之中。我特彆喜歡它對“事實錶粒度選擇”這一關鍵決策點的分析,通過不同粒度選擇對後續查詢性能和數據廣度的影響,展示瞭設計初期決策的深遠後果。這種前瞻性的指導,避免瞭讀者在實際操作中走彎路。而且,作者在描述這些案例時,總是能清晰地指齣不同設計選擇背後的“取捨”關係,平衡瞭理論上的完美與工程實踐中的復雜性,這使得書中的建議顯得尤為真實可信。它教給我的不僅僅是“應該怎麼做”,更是“為什麼這樣做比那樣更好”,這種邏輯鏈條的完整性,極大地提升瞭讀者的決策能力和分析判斷力。
评分這本書的深度和廣度,對於任何希望在數據領域深耕的人來說,都是一次裏程碑式的學習體驗。它絕非那種淺嘗輒止的“入門指南”,而是直指數據倉庫設計哲學的核心。我尤其欣賞作者對於曆史數據處理和緩慢變化維度(SCD)類型的那一套精妙的劃分和解釋,那簡直是一場教科書級彆的梳理。很多項目中睏擾我們許久的數據版本控製和曆史追溯問題,都在書中找到瞭清晰、可執行的解決方案框架。此外,書中對數據質量和元數據管理的重視程度,也體現瞭作者超越技術實現層麵,對整個數據生命周期管理的深刻理解。這不僅僅是教你怎麼搭建一個數據倉庫,更是在教你如何構建一個能夠持續、健康運行多年的數據資産平颱。閱讀過程中,我不得不頻繁地停下來,拿齣筆記本對照自己當前工作中的實際數據模型進行反思和重構,每一次對比,都能發現新的優化空間。這種強烈的互動性和實踐指導性,是很多同類書籍所欠缺的,它促使讀者從“使用工具”的層麵,躍升到“設計哲學”的層麵去思考問題。
评分這本書的裝幀設計真是讓人眼前一亮,那種沉穩的深藍色調,搭配上燙金的書名,散發齣一種專業又不失典雅的氣質。我拿到手的時候,首先被它的分量所震撼,顯然這不是一本輕飄飄的理論讀物,而是承載瞭大量實踐智慧的厚重之作。內頁的紙張質量也無可挑剔,印刷清晰銳利,即便是復雜的圖錶和數據模型也能一覽無餘,閱讀體驗極佳。我特彆欣賞作者在排版上的用心,章節之間的過渡自然流暢,關鍵概念的突齣處理得恰到好處,使得長時間閱讀下來眼睛也不會感到疲勞。從包裝到內涵,這本書都透露齣一種對細節的極緻追求,這在技術類書籍中是難能可貴的。它不僅僅是一本工具書,更像是一件精心打磨的工藝品,讓人在學習知識的同時,也能享受到閱讀的愉悅。我甚至會將它作為案頭必備的參考書,時不時翻閱,光是看著它擺在書架上的樣子,都能讓我對數據架構的世界産生更濃厚的興趣和敬畏之心。這種實體書的質感,是任何電子閱讀器都無法替代的。
评分初讀這本書的感受,就像是走進瞭一個規劃得井井有條、邏輯嚴密的龐大城市規劃藍圖之中。作者的敘述方式極其清晰,他沒有急於拋齣晦澀難懂的專業術語,而是采取瞭一種循序漸進的引導方式,將復雜的概念層層剝開,如同剝洋蔥一般,讓人在不知不覺中就掌握瞭核心思想。尤其是在描述維度建模的那些章節,那種將業務流程轉化為結構化數據的過程,被作者描繪得如同烹飪美食般充滿瞭藝術感和精確性。我個人對書中關於事實錶和維度錶之間關係的論述印象深刻,它沒有停留在理論層麵,而是結閤瞭大量的實例場景進行剖析,使得抽象的建模理念瞬間變得觸手可及,極大地拓寬瞭我對數據組織方式的認知邊界。那種“原來如此”的頓悟感貫穿始終,讓我對過去在數據倉庫設計中遇到的那些似是而非的解決方案,找到瞭強有力的理論支撐和更優化的替代路徑。這本書的語言風格是那種非常務實且富有洞察力的,它仿佛是一位經驗豐富的大師,在你耳邊低語,分享著他摸爬滾打多年纔積纍下來的真知灼見。
评分從我個人的閱讀習慣來看,這本書的價值在於其極高的“可復用性”和“跨行業適應性”。盡管數據倉庫的構建會受到具體業務背景的影響,但這本書所闡述的核心原則和規範卻是跨越行業壁壘的普適真理。我發現,無論是在我早先參與的電信項目,還是目前正在接觸的醫療數據平颱項目中,書中提到的那些關於星型/雪花模型的優化原則、數據分區的策略,乃至ETL流程的健壯性設計思路,都能夠被直接映射和應用。它提供瞭一套穩定的、經過時間考驗的思維框架,讓你在麵對全新的業務挑戰時,不會感到無從下手,而是能夠迅速地套用這套框架,搭建齣邏輯清晰、性能可靠的初步模型。這種“授人以漁”的教學方式,遠比提供一堆固定代碼模闆要寶貴得多。閱讀完畢後,我感覺自己不再是一個單純的數據庫操作員,而是一個真正的數據架構思考者,能夠從業務的宏觀視角審視數據資産的長期價值。這本書的價值,會隨著時間的推移和經驗的積纍,愈發顯現齣來。
评分沒有三版的日子裏,隻能硬擼二版的原版書。
评分DW領域第一經典書籍
评分英語書看起來好吃力啊啊啊,但是這本書的確很nice ***************** 2018-09-11記:棄啦,,,哎,懷戀數據分析的苦逼日子
评分看的塊崩潰勒 (๑´ㅂ`๑)
评分DW領域第一經典書籍
相關圖書






本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有