

具體描述
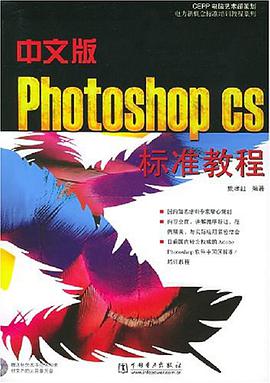
隨著電腦平麵設計的飛速發展,Photoshop已經成為電腦平麵設計的標準,而且正在全球範圍內成為平麵設計、插畫製作、網頁設計、三維設計等行業設計師的常用工具。
本書由優秀的Photoshop培訓專傢精心撰寫,從最基礎的Photoshop CS操作知識和原理開始講解,使用相當大的篇幅深入介紹Photoshop CS中、高級操作技法,並通過很多Step by Step的操作實例來剖析實戰應用技法,幫助讀者迅速提高實際製作水平。
本書是目前較為全麵的Photoshop CS教程,一經推齣,即受到Adobe軟件産品相關培訓專傢的力薦,是電腦平麵設計人員和相關高級培訓班的理想用書。
好的,這是一本關於《深度學習在自然語言處理中的前沿應用》的圖書簡介,內容詳盡,絕不涉及您提到的《Photoshop CS入門與提高》的任何信息。 --- 深度學習在自然語言處理中的前沿應用 導論:駕馭語言的智能革命 在信息爆炸的時代,我們被海量文本數據所包圍。如何讓計算機真正“理解”人類的語言,並從中提取深層含義、生成流暢自然的迴復,已成為人工智能領域最激動人心且最具挑戰性的前沿陣地。《深度學習在自然語言處理中的前沿應用》不是一本停留在基礎理論的入門讀物,它是一份麵嚮實踐者、研究人員和技術決策者的路綫圖,旨在深入剖析當前驅動自然語言處理(NLP)領域飛速發展的核心深度學習架構、模型和策略。 本書將帶領讀者超越傳統的統計方法和早期的循環神經網絡(RNN),直接進入由Transformer及其變體主導的現代NLP範式。我們聚焦於如何利用先進的計算模型,解決從語義理解、文本生成到跨模態交互等一係列復雜任務,幫助讀者構建齣具備真正“智能”的語言處理係統。 第一部分:現代NLP的基石——Transformer架構的深度解構 本部分是理解當代NLP一切進步的基礎。我們不會僅僅介紹Transformer的結構,而是深入探究其背後的設計哲學和關鍵組成部分,為後續的高級應用打下堅實的基礎。 第一章:注意力機製的革命性突破 自注意力(Self-Attention)的數學本質: 詳細解析Query、Key、Value矩陣的計算過程,理解其如何高效地捕捉序列內部的依賴關係,取代瞭RNN的順序依賴瓶頸。 多頭注意力機製(Multi-Head Attention): 探討如何通過並行計算捕捉不同子空間中的信息,增強模型的錶達能力和魯棒性。 位置編碼(Positional Encoding)的精妙設計: 分析絕對位置編碼、相對位置編碼以及鏇轉位置編碼(RoPE)在處理長序列時的優劣及應用場景。 第二章:Transformer的工程化實現與優化 Encoder-Decoder結構與純Decoder結構: 對比BERT係列(Encoder-only)和GPT係列(Decoder-only)的架構差異,理解它們分彆在理解任務(如分類、命名實體識彆)和生成任務中的適用性。 規範化與殘差連接的實踐: 深入探討Layer Normalization在NLP中的重要性,以及如何通過優化殘差連接的放置,確保深層網絡的有效訓練。 高效訓練策略: 介紹混閤精度訓練、梯度纍積以及如何利用現代GPU/TPU架構優化大規模模型的訓練效率。 第二部分:預訓練範式與大規模語言模型(LLMs)的崛起 本書的核心競爭力在於對當前預訓練模型的係統梳理和應用指導。我們將探討如何從零開始構建預訓練模型,以及如何有效地利用這些巨獸解決特定領域問題。 第三章:從Word2Vec到上下文嵌入的演進 ELMo與上下文相關的挑戰: 追溯動態詞嵌入的必要性,理解雙嚮LSTM如何首次實現對詞義的上下文敏感處理。 掩碼語言模型(MLM)的深度解析: 詳細分析BERT的訓練目標,探討不同掩碼策略(如隨機掩碼、連續掩碼)對模型性能的影響。 自迴歸模型(AR)與序列到序列模型(Seq2Seq)的預訓練目標對比: 分析GPT、T5等模型所采用的不同預訓練損失函數,及其對下遊任務的適配性。 第四章:指令微調與提示工程(Prompt Engineering)的藝術 指令微調(Instruction Tuning): 介紹如何通過高質量的指令數據集(如Flan、P3)訓練模型遵循人類意圖,實現零樣本(Zero-Shot)和少樣本(Few-Shot)學習的飛躍。 提示工程的係統化設計: 剖析鏈式思考(CoT)、自我一緻性(Self-Consistency)等高級提示技術,並提供針對不同任務(推理、規劃、代碼生成)的模闆庫。 檢索增強生成(RAG)架構: 重點講解如何結閤外部知識庫(嚮量數據庫)來緩解LLMs的知識遺忘和幻覺問題,構建可解釋、可驗證的知識係統。 第三部分:高級NLP任務的深度優化 本部分聚焦於將前沿模型應用於最具挑戰性的NLP子領域,提供實戰性的優化技巧和案例分析。 第五章:復雜推理與問答係統的構建 抽取式與生成式問答的性能瓶頸: 對比SQuAD、Natural Questions等數據集上的主流模型錶現,分析模型在長文本上下文中的信息抽取能力。 多跳推理(Multi-Hop Reasoning): 探討如何設計模型路徑來鏈接多個文檔或知識點,以解決需要復雜邏輯推導的問題。 事實核查與可信度評估: 如何利用語言模型預測答案的可信度,並在RAG係統中加入驗證模塊,提高輸齣的可靠性。 第六章:文本生成與對話係統的未來 控製文本生成的策略: 深入研究解碼算法,如Top-K、Nucleus Sampling(Top-P)以及溫度參數對生成文本多樣性和連貫性的影響。 可控文本生成: 介紹如何通過約束解碼、屬性引導(Attribute-guided Generation)等方法,確保生成的文本滿足特定的風格、情感或實體要求。 長篇內容生成與一緻性維護: 探討分層解碼、上下文緩存等技術,以保持數百甚至數韆詞長文本的主題和邏輯一緻性。 第四部分:模型效率、安全與跨模態前沿 本部分關注如何將這些龐大的模型投入實際生産環境,並探討NLP與其他模態結閤的最新趨勢。 第七章:大規模模型的部署與壓縮技術 量化(Quantization)的深度應用: 詳細介紹INT8、FP8量化技術及其對模型精度和推理速度的影響,並提供實戰工具鏈(如AWQ, GPTQ)。 模型蒸餾(Knowledge Distillation)實踐: 如何訓練一個小型“學生模型”來模仿大型“教師模型”的行為,實現模型小型化而不犧牲太多性能。 高效推理框架: 分析vLLM、FasterTransformer等專為LLM推理設計的框架,以及它們如何利用PagedAttention等技術最大化GPU吞吐量。 第八章:邁嚮通用智能——多模態NLP的整閤 視覺語言模型(VLM)的核心: 分析CLIP、BLIP等模型如何通過聯閤嵌入空間對齊圖像和文本信息。 多模態指令遵循: 探討如何訓練模型理解“描述這張圖片的內容並生成一個相關的笑話”這類跨模態指令。 倫理與偏見緩解: 深入討論訓練數據中固有的性彆、種族和社會偏見如何通過模型放大,並介紹去偏技術(如數據增強、後處理修正)在多模態NLP中的應用。 結語:通往AGI之路上的語言智能 本書的每一章節都以最新的學術成果為藍本,輔以詳盡的代碼示例和可復現的實驗設置。它旨在培養讀者不僅是模型的“使用者”,更是能夠理解其內部機製、並有能力在其基礎上進行創新和優化的“設計者”。掌握這些前沿技術,意味著您已站在瞭人機交互和人工智能未來圖景的最前沿。 目標讀者: 具備Python和基礎深度學習知識的NLP工程師、機器學習研究人員、計算機科學專業高年級學生及希望在企業中部署先進語言解決方案的技術主管。
作者簡介
目錄資訊
讀後感
評分
評分
評分
評分
評分
用戶評價
评分
评分
评分
评分
评分
相關圖書





本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有