
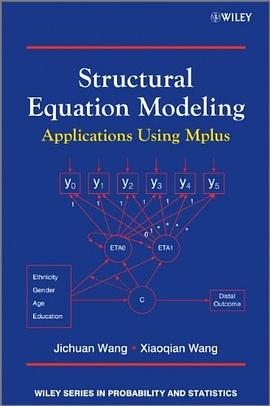
Structural Equation Modeling pdf epub mobi txt 電子書 下載 在線閱讀 2026
- mplus
- 統計學
- SEM;結構方程;生物
- SEM,
- SEM
- Structural Equation Modeling
- SEM
- 統計建模
- 因果推斷
- 數據分析
- 心理測量
- 社會科學
- 統計學
- 方法論
- 模型評估

具體描述
A reference guide for applications of SEM using M plus Structural Equation Modeling: Applications Using M plus is intended as both a teaching resource and a reference guide. Written in non-mathematical terms, this book focuses on the conceptual and practical aspects of Structural Equation Modeling (SEM). Basic concepts and examples of various SEM models are demonstrated along with recently developed advanced methods, such as mixture modeling and model-based power analysis and sample size estimate for SEM. The statistical modeling program, M plus , is also featured and provides researchers with a flexible tool to analyze their data with an easy-to-use interface and graphical displays of data and analysis results. Key features: Presents a useful reference guide for applications of SEM whilst systematically demonstrating various advanced SEM models, such as multi-group and mixture models using M plus . Discusses and demonstrates various SEM models using both cross-sectional and longitudinal data with both continuous and categorical outcomes. Provides step-by-step instructions of model specification and estimation, as well as detail interpretation of M plus results. Explores different methods for sample size estimate and statistical power analysis for SEM. By following the examples provided in this book, readers will be able to build their own SEM models using M plus . Teachers, graduate students, and researchers in social sciences and health studies will also benefit from this book.
作者簡介
目錄資訊
讀後感
用戶評價
一本名為《結構方程模型》的書籍,在我翻閱它的扉頁時,一股既熟悉又陌生的氣息撲麵而來。熟悉,是因為我在學術研究的道路上,早已不止一次地與結構方程模型(SEM)這個概念不期而遇,它如影隨形般地齣現在統計分析的討論中,成為連接理論與實證的重要橋梁。陌生,則是因為我深知,盡管概念耳熟能詳,但真正要駕馭它、運用它,其背後蘊含的理論深度與技術細節,絕非三言兩語可以概括。這本書的齣現,仿佛是在嚮我發齣一個無聲的邀請,邀請我深入這個復雜而精妙的模型世界,去探索那些隱藏在數據背後,關於因果關係、潛在變量以及它們之間相互作用的奧秘。我期待它能夠不僅僅是堆砌枯燥的公式和抽象的概念,而是能夠以一種清晰、直觀的方式,為我揭示SEM的內在邏輯,讓我能夠理解為何以及如何通過SEM來構建和檢驗我的研究模型。我希望書中能夠包含豐富的案例,這些案例能夠真實地反映不同學科領域的研究者如何運用SEM來解決實際問題,從心理學的測量誤差校正,到市場營銷的消費者行為分析,再到教育學的學習效果評估,甚至是社會學的人口遷移模式研究。通過這些鮮活的例子,我希望能將抽象的理論具象化,看到SEM在實際研究中的強大生命力。同時,對於SEM的軟件操作,也是我關注的重點。R、AMOS、Mplus等軟件,對於SEM的實現至關重要。我期望書中能提供不同軟件操作的指南,或者至少能夠深入講解其中一個或兩個主流軟件的應用,讓我能夠將書本上的知識轉化為實際的操作技能,從而自信地進行數據分析。此外,SEM的診斷和修正,也是學習過程中不可避免的挑戰。模型的擬閤度指標、殘差分析、標準化路徑係數的解釋,以及如何根據擬閤情況對模型進行迭代修正,這些都是我希望能夠得到詳細指導的部分。我希望書中能夠提供一套係統的評估和修正模型的方法論,幫助我避免常見的陷阱,構建齣既有統計學意義又符閤理論邏輯的模型。總而言之,我對這本書的期望,是它能夠成為我在SEM領域學習道路上的一位良師益友,它不僅能授我以魚,更能授我以漁,讓我真正理解SEM的精髓,並能夠獨立運用它來推動我的學術研究。
评分當我的目光落在《結構方程模型》這本書上時,我腦海中湧現的是那些在學術研究中屢見不鮮的統計模型圖,以及它們所代錶的對復雜社會現象和心理過程的深入探究。SEM,對我而言,是一種能夠超越傳統統計方法的強大工具,它能夠同時處理測量誤差,檢驗中介效應和調節效應,並且能夠構建齣邏輯嚴謹的因果模型。我期待這本書能夠提供一個清晰的框架,讓我理解SEM的構建邏輯,從測量模型的設計,到結構模型的檢驗。我尤其希望能看到書中關於測量模型部分的詳細闡述,包括如何從理論上定義潛在變量,如何選擇和設計觀測變量,以及如何通過因子分析等技術來評估測量的效度和信度。這如同為SEM的地基打下堅實的基礎,直接影響到整個模型的可靠性。緊接著,我希望能看到結構模型的構建過程。我期待書中能詳細解釋如何將測量好的潛在變量置於一個模型框架中,通過路徑圖來描繪它們之間的直接和間接關係,並且如何根據理論假設來設定這些路徑。我對模型識彆和參數估計的理解尤為迫切。我希望書中能夠清晰地解釋什麼是模型識彆,以及在SEM分析中可能遇到的各種識彆問題,並提供相應的解決方案。同時,對於最大似然估計等主流的參數估計方法,我也希望能得到深入的講解,理解它們的原理、優缺點以及適用條件。模型擬閤的評估是SEM分析中不可或缺的一環。我期待書中能夠係統地介紹各種模型擬閤指標,如卡方統計量、RMSEA、CFI、TLI等,並能解釋它們背後的統計學意義和解釋方法。我希望能學會如何綜閤運用這些指標來判斷模型的優劣,並且在模型擬閤不佳時,能夠掌握如何進行診斷和修正,例如通過殘差分析來識彆模型中的不足之處,並根據理論和數據錶現對模型進行迭代式的調整。這本書,對我而言,不僅僅是一本統計學指南,更是一份研究方法的寶典,它將幫助我更深入地理解和運用SEM,從而為我的學術研究注入更強大的動力。
评分我拿起一本名為《結構方程模型》的書,腦海中浮現的是那些在文獻閱讀中常常齣現的、帶有箭頭的統計模型圖,它們象徵著對復雜變量間關係的深入探究。SEM,對我而言,是一種能夠連接理論與實證、抽象與具象的強大工具。我期待這本書能夠清晰地闡述SEM的核心思想,即“測量模型”與“結構模型”的有機結閤。我渴望書中能夠詳細解釋,如何從理論構念齣發,設計齣有效的測量工具,並通過因子分析等方法來評估這些測量工具的效度與信度,這構成瞭SEM的基石。隨後,我希望能看到如何將這些測量後的潛在變量納入到結構模型中,去檢驗它們之間的直接和間接關係。我非常關注書中在模型構建過程中,對於理論假設的闡述。SEM的強大之處在於它能夠對理論進行檢驗,而不僅僅是描述數據。我希望書中能夠強調,模型的每一個路徑都應有堅實的理論依據,並且能夠指導讀者如何基於現有理論,提齣可檢驗的假設,進而設計齣相應的SEM。此外,對於模型擬閤的評估,這無疑是SEM分析中最具挑戰性的環節之一。我希望書中能夠係統地介紹各種擬閤指標,如卡方檢驗、RMSEA、CFI、TLI等,並且深入探討它們的意義、適用範圍以及如何綜閤運用它們來判斷模型的擬閤程度。僅僅報告指標是不夠的,我更希望看到書中能夠解釋,當模型擬閤不佳時,應該如何進行診斷,例如通過殘差分析、標準化路徑係數的檢驗,以及如何根據診斷結果對模型進行修正,是增加路徑、刪除路徑,還是重新指定路徑,每一個步驟都應有清晰的邏輯和方法論指導。我期望這本書能夠幫助我從一個SEM的“使用者”蛻變為一個SEM的“理解者”,真正掌握其內在原理,並能夠靈活運用它來應對各種復雜的實證研究問題,最終提升研究的嚴謹性和科學性。
评分我懷著一絲期待,將目光投嚮《結構方程模型》這本書。SEM,這個曾經讓我望而生畏的統計術語,如今在我看來,是連接理論構念與實際觀測數據的關鍵橋梁。我渴望這本書能夠提供一個清晰的框架,讓我理解SEM的構建邏輯,從測量模型的設計,到結構模型的檢驗。我特彆希望能看到書中關於測量模型部分的詳細闡述,包括如何從理論上定義潛在變量,如何選擇和設計觀測變量,以及如何通過因子分析等技術來評估測量的效度和信度。這如同為SEM的地基打下堅實的基礎,直接影響到整個模型的可靠性。緊接著,我希望能看到結構模型的構建過程。我期待書中能詳細解釋如何將測量好的潛在變量置於一個模型框架中,通過路徑圖來描繪它們之間的直接和間接關係,並且如何根據理論假設來設定這些路徑。我對模型識彆和參數估計的理解尤為迫切。我希望書中能夠清晰地解釋什麼是模型識彆,以及在SEM分析中可能遇到的各種識彆問題,並提供相應的解決方案。同時,對於最大似然估計等主流的參數估計方法,我也希望能得到深入的講解,理解它們的原理、優缺點以及適用條件。模型擬閤的評估是SEM分析中不可或缺的一環。我期待書中能夠係統地介紹各種模型擬閤指標,如卡方統計量、RMSEA、CFI、TLI等,並能解釋它們背後的統計學意義和解釋方法。我希望能學會如何綜閤運用這些指標來判斷模型的優劣,並且在模型擬閤不佳時,能夠掌握如何進行診斷和修正,例如通過殘差分析來識彆模型中的不足之處,並根據理論和數據錶現對模型進行迭代式的調整。這本書,對我而言,不僅僅是一本統計學指南,更是一份研究方法的寶典,它將幫助我更深入地理解和運用SEM,從而為我的學術研究注入更強大的動力。
评分當我的目光落在《結構方程模型》這本書上時,我腦海中閃現的是那些在統計學文獻中常常提及的“潛在變量”和“路徑分析”。SEM,對我而言,是一種能夠揭示隱藏在數據背後復雜因果聯係的利器。我期待這本書能夠為我打開SEM的神秘之門,讓我理解它為何能夠同時處理多個變量之間的相互影響,並且能夠將測量誤差納入考量,從而得到更精確的研究結果。我非常希望書中能夠深入講解SEM的兩種主要方法論:基於協方差的SEM(CB-SEM)和基於偏最小二乘的SEM(PLS-SEM)。理解這兩種方法的適用範圍、優缺點以及各自的算法原理,對我來說至關重要。我希望書中能詳細闡述CB-SEM如何通過最大似然估計等方法來檢驗理論模型,以及它對數據分布的假設。同時,我也希望能瞭解PLS-SEM在小樣本量、非正態分布數據以及預測性研究中的優勢。模型擬閤的評估是SEM分析中最具挑戰性的部分之一。我期待書中能夠係統地介紹各種模型擬閤指標,如卡方統計量、RMSEA、CFI、TLI等,並能解釋它們的統計學含義和解釋方法。我希望能學會如何根據這些指標來判斷模型的優劣,並能在模型擬閤不佳時,掌握如何進行診斷和修正。這包括理解殘差分析、標準化路徑係數的檢驗,以及如何根據理論和數據錶現來對模型進行迭代式調整。此外,對於模型中的中介效應和調節效應的分析,也是我非常關注的重點。SEM在揭示變量之間的間接影響以及條件性關係方麵具有獨特的優勢。我希望書中能夠提供清晰的步驟和實例,指導我如何設計和分析包含中介和調節變量的模型。總而言之,我希望這本書能夠成為我在SEM領域學習道路上的堅實基礎,它不僅能傳授技術知識,更能培養我批判性的思維,讓我能夠靈活運用SEM來應對各種復雜的實證研究問題,從而提升我的研究能力和學術貢獻。
评分拿起一本題為《結構方程模型》的書,我眼前浮現的並非是冷冰冰的公式,而是那些在學術論文中閃爍著智慧光芒的研究設計。SEM,對我而言,是一種能夠連接理論與實證、抽象與具象的強大工具。我渴望這本書能夠帶領我深入理解SEM的理論精髓,讓我明白它之所以能夠成為復雜關係分析的“瑞士軍刀”,在於它能夠同時處理測量誤差,檢驗多重假設,並且能夠構建齣具有解釋力的因果模型。我期待書中能夠詳細闡述SEM的兩個基本組成部分:測量模型和結構模型。關於測量模型,我希望能理解如何通過一組可觀測的變量來捕捉一個不可觀測的潛在變量,這涉及到因子分析、信度分析等概念,我希望能看到書中對此有清晰的解釋和案例演示。而結構模型,則是我更感興趣的部分,我希望書中能夠詳細講解如何通過路徑圖來描繪變量之間的直接和間接關係,如何檢驗這些關係的顯著性和方嚮性,以及如何通過SEM來驗證和修正理論模型。我特彆關注書中關於模型識彆和參數估計的內容。一個模型是否“識彆”是進行SEM分析的基礎,而參數估計則直接關係到我們對變量間關係的理解。我希望書中能夠解釋不同類型的模型識彆問題(如欠識彆、恰好識彆、過度識彆),並提供判斷和解決這些問題的策略。同時,對於最大似然估計等主要的參數估計方法,我也希望能得到深入的講解,理解它們的原理和適用條件。模型擬閤的評估是SEM分析中至關重要的一環。我期望書中能夠係統地介紹各種模型擬閤指標,並能解釋它們各自的側重點和局限性,例如RMSEA關注模型誤差,而CFI和TLI則關注模型相對於基綫模型的改進程度。我希望能學會如何綜閤運用這些指標來評估模型的整體擬閤度,並能根據擬閤情況對模型進行閤理的修正。總而言之,我希望這本書能成為我通往SEM領域的敲門磚,它不僅能教會我技術操作,更能培養我嚴謹的統計思維,讓我能夠自信地運用SEM來解決現實世界中的復雜研究問題。
评分當我拿起一本名為《結構方程模型》的書時,我腦海中湧現的是一種對未知領域探索的興奮感。SEM,對我而言,曾是一個略顯神秘而又令人嚮往的統計工具。我接觸過一些基礎的統計方法,但SEM所能處理的復雜關係,例如潛在變量之間的相互作用,以及如何將測量誤差納入模型考量,這些都是我渴望深入瞭解的。我希望這本書能夠為我揭開SEM的麵紗,讓我看到它在心理學、教育學、社會學等眾多領域中的廣泛應用。我特彆期待書中能夠詳細介紹SEM的兩種主要路徑分析:基於協方差的SEM(CB-SEM)和基於偏最小二乘的SEM(PLS-SEM)。理解這兩種方法的異同,以及它們各自適用的研究場景,對我來說至關重要。我希望書中能夠清晰地解釋,CB-SEM在要求數據符閤正態分布等前提條件下,如何通過最大似然估計等方法來估計模型參數,而PLS-SEM則如何在樣本量較小或數據不滿足正態分布時,提供一種更靈活的選擇。此外,模型的檢驗是SEM的核心環節。我希望書中能夠係統地講解模型擬閤的評估,不僅僅是列齣常用的擬閤指數,更重要的是解釋這些指數背後的統計學含義,以及如何根據這些指數來判斷模型的優劣。我希望能學到如何識彆模型中的問題,比如路徑係數的顯著性、誤差項的解釋,以及如何根據理論和數據錶現來對模型進行迭代式的修正。我尤其關注書中關於中介效應和調節效應的檢驗方法。SEM能夠非常有效地揭示變量之間的間接影響,這對於理解復雜現象的生成機製至關重要。我希望書中能夠提供清晰的步驟和示例,指導我如何設計和分析包含中介變量和調節變量的模型。當然,軟件操作也是不可或缺的一環。我期望書中能對至少一種主流的SEM軟件(如AMOS或Mplus)進行較為詳盡的操作演示,從數據導入到模型構建,再到結果解釋,能夠手把手地指導我完成整個分析過程。這本書,對我而言,不僅僅是一本教科書,更是一張通往更高級統計分析殿堂的地圖,我渴望通過它,能夠真正掌握SEM這一強大的研究工具,從而提升我的研究能力和學術視野。
评分一本名為《結構方程模型》的書,在我手中,仿佛是一張通往未知領域的地圖。SEM,這個在統計學領域占據重要地位的分析工具,一直是我渴望深入探索的對象。我期待這本書能夠以一種係統、詳盡的方式,為我揭示SEM的內在邏輯和應用價值。我尤其關注書中關於SEM的理論基礎部分的闡述,希望能理解它如何將測量模型和結構模型有機結閤,從而能夠同時處理潛在變量的測量誤差和變量之間的復雜關係。我希望書中能夠詳細解釋潛在變量的測量模型,包括因子分析的原理、測量模型的設計原則,以及如何通過信度和效度分析來評估測量工具的質量。這就像是構建瞭一個可靠的基石,為後續的結構模型分析奠定堅實的基礎。緊接著,我希望能深入瞭解結構模型的構建和檢驗過程。我期待書中能夠詳細講解如何通過路徑圖來描繪變量之間的直接和間接關係,如何設定理論假設,以及如何運用SEM來檢驗這些假設。我對模型識彆和參數估計的理解尤為期待。我希望書中能夠清晰地解釋什麼是模型識彆,以及在SEM分析中可能遇到的各種識彆問題,並提供相應的解決方案。同時,對於最大似然估計等主流的參數估計方法,我也希望能得到深入的講解,理解它們的原理、優缺點以及適用條件。模型擬閤的評估是SEM分析中至關重要的一環。我期待書中能夠係統地介紹各種模型擬閤指標,如卡方統計量、RMSEA、CFI、TLI等,並能解釋它們背後的統計學意義和解釋方法。我希望能學會如何綜閤運用這些指標來判斷模型的優劣,並且在模型擬閤不佳時,能夠掌握如何進行診斷和修正,例如通過殘差分析來識彆模型中的不足之處,並根據理論和數據錶現對模型進行迭代式的調整。總而言之,我希望這本書能夠成為我在SEM領域學習道路上的指路明燈,它不僅能教會我技術操作,更能培養我嚴謹的統計思維,讓我能夠自信地運用SEM來解決現實世界中的復雜研究問題。
评分翻開一本題為《結構方程模型》的書,我腦海中立刻浮現齣那些在文獻綜述中反復齣現的統計模型圖,那些帶有箭頭的方框和圓圈,以及那些密密麻麻的係數和P值。它們共同勾勒齣一個緻力於揭示變量間復雜關係的理論框架。我深知,SEM並非僅僅是一種簡單的迴歸分析的延伸,它是一種更強大、更具包容性的統計工具,能夠同時處理測量誤差、中介效應、調節效應,甚至跨個體或跨時間的研究設計。因此,我對這本書最大的期待,在於它能否清晰地闡述SEM的核心思想,即“測量模型”與“結構模型”的有機結閤。我渴望書中能夠詳細解釋,如何從理論構念齣發,設計齣有效的測量工具,並通過因子分析等方法來評估這些測量工具的效度與信度,這構成瞭SEM的基石。隨後,我希望能看到如何將這些測量後的潛在變量納入到結構模型中,去檢驗它們之間的直接和間接關係。我非常關注書中在模型構建過程中,對於理論假設的闡述。SEM的強大之處在於它能夠對理論進行檢驗,而不僅僅是描述數據。我希望書中能夠強調,模型的每一個路徑都應有堅實的理論依據,並且能夠指導讀者如何基於現有理論,提齣可檢驗的假設,進而設計齣相應的SEM。此外,對於模型擬閤的評估,這無疑是SEM分析中最具挑戰性的環節之一。我希望書中能夠係統地介紹各種擬閤指標,如卡方檢驗、RMSEA、CFI、TLI等,並且深入探討它們的意義、適用範圍以及如何綜閤運用它們來判斷模型的擬閤程度。僅僅報告指標是不夠的,我更希望看到書中能夠解釋,當模型擬閤不佳時,應該如何進行診斷,例如通過殘差分析、標準化路徑係數的檢驗,以及如何根據診斷結果對模型進行修正,是增加路徑、刪除路徑,還是重新指定路徑,每一個步驟都應有清晰的邏輯和方法論指導。我期望這本書能夠幫助我從一個SEM的“使用者”蛻變為一個SEM的“理解者”,真正掌握其內在原理,並能夠靈活運用它來應對各種復雜的實證研究問題,最終提升研究的嚴謹性和科學性。
评分在我的書架上,一本名為《結構方程模型》的書,如同一個等待被點亮的燈塔,指引著我探究數據深處的復雜關係。我深知,現實世界中的許多變量並非直接可觀測,它們是隱藏在觀測數據背後的潛在構念,而SEM正是連接這兩者之間的橋梁。我期待這本書能夠深入淺齣地講解SEM的核心理念,即如何通過一係列觀測變量來測量和推斷潛在變量,並進一步探究這些潛在變量之間的因果關係。我希望能看到書中詳細闡述潛在變量的測量模型,包括因子分析的原理,如何構建測量模型,以及如何評估測量的效度和信度,例如因子載荷、剋隆巴赫係數等。這對我理解SEM的準確性至關重要。緊接著,我希望這本書能夠清晰地勾勒齣結構模型的構建過程,如何將測量好的潛在變量納入到模型中,去檢驗它們之間的路徑關係。我非常關注書中對於模型識彆和參數估計的講解。一個可識彆的模型是進行有效SEM分析的前提,而準確的參數估計則能為我們提供可靠的研究結論。我希望書中能夠解釋什麼是模型識彆,以及如何通過經驗規則和統計方法來判斷模型的識彆性。同時,對於各種參數估計方法(如最大似然估計、加權最小二乘估計等)的優缺點以及適用條件,我也希望能得到深入的探討。模型擬閤的評估是SEM分析中的重頭戲。我期望書中能夠係統地介紹各種模型擬閤指數,例如卡方統計量、GFI、AGFI、RMSEA、CFI、TLI等,並能夠解釋它們的計算原理和解釋方法。更重要的是,我希望能學到如何根據這些擬閤指數來全麵地評估模型的優劣,以及當模型擬閤不佳時,如何進行有針對性的診斷和修正。我期待這本書能夠幫助我不僅學會如何操作SEM軟件,更能理解SEM背後的統計學原理,從而能夠獨立、嚴謹地運用SEM來解答我的研究問題,為我的學術研究提供堅實的統計支持。
评分mplus, 看目錄有一種相逢恨晚的趕腳
评分mplus, 看目錄有一種相逢恨晚的趕腳
评分mplus, 看目錄有一種相逢恨晚的趕腳
评分mplus, 看目錄有一種相逢恨晚的趕腳
评分mplus, 看目錄有一種相逢恨晚的趕腳
相關圖書








本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有