
具体描述
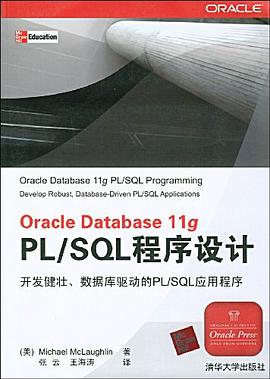
《Oracle Database 11g PL/SQL编程实战》通过动手练习、大量的示例以及实际的项目帮助读者掌握PL/SQL。书中包含大量最佳实践,涵盖了PL/SQL语言所有的最新功能和改进之处。每章末尾配有测验题,可以帮助读者进一步巩固所学内容,书中的示例代码也可以通过即使是经验丰富的Oracle专业人员,也可以从这本实战手册中受益。
作者简介
Michael McLaughlin是杨百翰大学爱达荷分校计算机信息技术系的一名资深教授,他也是一位Oraccle ACE。作为开发人员、DBA和E.Business Suite Applications DBA,Michael已经有20多年使用Oracld系列产品的经验。Mi qchael在离开Oracle公司时是Oracle Applications Divisioni部f]Release Engineeringdx组的Senior Upgrade Manager,他在Oracle从事咨询、支持和开发工作超过8年时间。他是ATOMS事务架构专利(美国专利号#7206805和#7290056)的发明者,这些专利已经转让给Oracle公司。
John M.Harper在过去11年多时间里一直从事数据库相关工作,主要方向是Oracle管理、模式设计、PL/SQL和信息质量。他目前在Jesus Christ ofLatter-day Saints教堂工作,职位是高级信息质量工程师。他享受自己从事的数据仓储、商业智能和数据库工程师工作
目录信息
第1章 Oracle开发概述 3
1.1 历史和背景知识 4
1.2 架构 5
1.2.1 两层模型 8
1.2.2 三层模型 12
1.3 可下载代码 13
1.4 小结 13
1.4.1 最佳实践回顾 13
1.4.2 测验 13
第2章 PL/SQL基础 15
2.1 PL/SQL块 16
2.1.1 原型 17
2.1.2 基本匿名块 18
2.1.3 Hello World匿名块 19
2.1.4 Hello Somebody匿名块 20
2.1.5 Hello Somebody命名块 23
2.1.6 嵌套块 24
2.2 变量:类型、赋值和运算符 25
2.2.1 文本数据类型 27
2.2.2 日期和时间戳类型 28
2.2.3 数值类型 31
2.2.4 复合变量类型 34
2.3 控制结构 37
2.3.1 if语句 37
2.3.2 case语句 38
2.3.3 循环结构 39
2.4 批量操作 47
2.5 可下载代码 48
2.6 小结 48
2.6.1 最佳实践回顾 49
2.6.2 测验 49
第3章 事务作用域 51
3.1 数据库ACID测试 52
3.1.1 原子性 52
3.1.2 一致性 53
3.1.3 隔离性 53
3.1.4 持久性 54
3.2 多版本并发控制 54
3.3 保存点、提交和事务回滚 54
3.3.1 保存点和回滚 54
3.3.2 提交 59
3.4 DML锁定和隔离控制 61
3.5 调用者和定义者权限 67
3.6 可下载代码 68
3.7 小结 69
3.7.1 最佳实践回顾 69
3.7.2 测验 69
第4章 错误管理 71
4.1 错误类型 72
4.1.1 编译时错误 72
4.1.2 语义错误 77
4.2 PL/SQL工具 87
4.3 可下载代码 91
4.4 小结 91
4.4.1 最佳实践回顾 92
4.4.2 测验 92
第Ⅱ部分 PL/SQL 编程 95
第5章 函数 97
5.1 函数架构 98
5.1.1 传值函数 98
5.1.2 传址函数 99
5.1.3 函数模型选择 100
5.1.4 事务作用域 101
5.1.5 调用参数说明 101
5.2 函数开发 103
5.2.1 确定性子句 104
5.2.2 PARALLEL_ENABLE子句 105
5.2.3 管线表子句 105
5.2.4 RESULT_CACHE子句 110
5.2.5 系统引用游标 112
5.2.6 递归函数 114
5.2.7 传址函数 114
5.3 可下载代码 115
5.4 小结 115
5.4.1 最佳实践回顾 116
5.4.2 测验 116
第6章 过程 119
6.1 过程架构 120
6.1.1 传值过程 120
6.1.2 传址函数 121
6.1.3 事务作用域 121
6.1.4 调用参数说明 122
6.2 过程开发 122
6.2.1 传值过程 123
6.2.2 传址过程 130
6.3 可下载代码 131
6.4 小结 132
6.4.1 最佳实践回顾 132
6.4.2 测验 132
第7章 集合 135
7.1 标量集合 137
7.1.1 varray 137
7.1.2 嵌套表 144
7.1.3 关联数组 145
7.2 对象类型集合 146
7.2.1 SQL嵌套表 146
7.2.2 PL/SQL嵌套表 148
7.3 记录类型集合 150
7.4 可下载代码 153
7.5 小结 153
7.5.1 最佳实践回顾 153
7.5.2 测验 153
第8章 包 157
8.1 包架构 158
8.1.1 更大的组织 158
8.1.2 程序持续性和内存驻留 159
8.1.3 更大的程序规模 159
8.2 包规范 159
8.3 无主体包 162
8.4 包主体 163
8.5 %TYPE和%ROWTYPE 166
8.6 模块化编程 168
8.7 重载 171
8.8 增强安全性 173
8.9 定义者和调用者权限 176
8.10 可下载代码 179
8.11 小结 179
8.11.1 最佳实践回顾 179
8.11.2 测验 180
第9章 触发器 183
9.1 触发器架构 184
9.2 触发器引发次序 186
9.3 触发器类型 188
9.3.1 DML触发器 188
9.3.2 DDL触发器 192
9.3.3 系统事件触发器 193
9.4 安全性和Oracle细粒度审计 195
9.5 分布式数据完整性 198
9.6 可下载代码 201
9.7 小结 201
9.7.1 最佳实践回顾 201
9.7.2 测验 202
第10章 对象 205
10.1 基本声明、实现和使用 207
10.1.1 定义并实现对象类型 207
10.1.2 实现Getter和Setter 210
10.1.3 实现静态方法 212
10.2 比较对象 216
10.2.1 MAP函数比较 217
10.2.2 ORDER函数比较 219
10.3 继承和多态 221
10.4 对象集合 224
10.5 可下载代码 227
10.6 小结 227
10.6.1 最佳实践回顾 227
10.6.2 测验 228
第Ⅲ部分 PL/SQL高级编程 231
第11章 动态SQL 233
11.1 本地动态SQL 234
11.1.1 无绑定变量的动态语句 235
11.1.2 带绑定变量的动态语句 237
11.2 DBMS_SQL包 246
11.2.1 无绑定变量的动态语句 246
11.2.2 带绑定变量的动态语句 247
11.2.3 混合并匹配NDS和DBMS_SQL 250
11.3 可下载代码 251
11.4 小结 251
11.4.1 最佳实践回顾 252
11.4.2 测验 252
第12章 外部文件 255
12.1 外部表架构 256
12.1.1 CSV文件 257
12.1.2 位置特定文件 260
12.1.3 TSV文件 261
12.1.4 转换XML为CSV文件 262
12.1.5 使用Java存储库清理文件 264
12.2 导入CLOB 268
12.3 可下载代码 276
12.4 小结 276
12.4.1 最佳实践回顾 277
12.4.2 测验 277
第Ⅳ部分 附录 279
附录A 包装PL/SQL 281
附录B PL/SQL层次性能分析器 287
附录C PL/Scope 299
附录D PL/SQL内置包和类型 303
附录E 测验答案 321
· · · · · · (收起)
读后感
用户评价
老实说,我以前对PL/SQL的理解一直停留在“写点存储过程走个业务逻辑”的层面,总觉得它不过是SQL的一种扩展,没有太多的技术深度可言。直到我开始啃这本书,才猛然醒悟,自己过去的操作无异于“拿菜刀切豆腐”,远未发挥出这门语言的真正潜力。书中对于“游标管理”那一部分的论述,简直是醍醐灌顶。作者没有停留在FOR循环的表面,而是深入剖析了显式游标的生命周期、SQL警告的处理,甚至还涉及到了包级别游标的优化技巧,这些都是教科书上常常一笔带过,但在生产环境中却能决定应用性能的关键点。阅读过程中,我常常需要暂停下来,在自己的测试环境中敲一遍书中的案例,尤其是涉及到动态SQL(EXECUTE IMMEDIATE)和嵌套表的性能对比测试时,那些从理论到实践的完美闭环,极大地增强了我对底层机制的理解。它不是那种干巴巴的堆砌API文档的参考书,而是充满了“为什么这么做”和“这么做的好处在哪里”的深度思考。
坦白讲,市面上关于数据库编程的书籍汗牛充栋,大部分都只是对SQL标准或Oracle官方文档的重新组织,读起来费力不讨好。然而,这本关于11g PL/SQL的实战宝典,给我带来的最大的感受是“效率”和“可靠性”的提升。它没有使用晦涩难懂的哲学思辨,而是用一种近乎教科书式的严谨,结合了项目经理的务实精神,构建了一个完整的知识体系。尤其值得称赞的是,书中对于**数据字典视图(Data Dictionary Views)**的解读,它不仅告诉我们查询哪些视图能获取信息,更重要的是,解释了这些视图背后的数据一致性和更新机制,这对于进行系统审计和深度问题排查至关重要。这本书不只是教你如何“写”PL/SQL,更教你如何“管理”和“优化”你的数据库代码资产,是一本可以反复研读,每次都能发掘出新东西的工具书。
这本书的封面设计着实吸引人,那种深沉的蓝色调配上简洁有力的字体,立刻让人感觉这不是一本泛泛而谈的教材,而是直指核心的实战手册。我是在一个项目紧急需求下抱着试试看的心态购入的,当时团队里对11g版本的PL/SQL特性掌握得不够深入,尤其是在处理复杂事务和性能调优方面显得力不从心。拿到书后,我首先翻阅了目录,发现其结构划分非常清晰,从基础语法回顾到高级的包、存储过程、函数构建,再到后面深入的异常处理和事务控制,逻辑衔接得非常自然。尤其让我惊喜的是,它并没有过多纠缠于Oracle历史版本的兼容性问题,而是紧密围绕11g的特性进行展开,这对于我们这种需要快速落地的项目组来说,无疑是最高效的学习路径。书中的代码示例丰富且实用,每一个知识点都配有直观的代码块,有些例子甚至直接就是我在实际工作中遇到的那种“老大难”问题,作者似乎能预判到读者在实际开发中会踩的坑,并提前给出优美的解决方案。那种感觉就像是身边多了一位经验丰富的资深DBA在随时指导,让人倍感踏实。
我是一位习惯了通过大量练习来巩固知识的工程师,对于理论书籍常常感到枯燥乏味。但这本书的叙事风格却有一种独特的节奏感,它在理论讲解之后,总会紧跟着一系列设计精巧的“挑战性练习”。这些练习并非简单的填空题或代码重写,而是模拟了真实业务场景下的复杂需求。比如,书中关于“管道化数据处理”的章节,它巧妙地结合了队列(QUEUE)的概念和PL/SQL的并行处理能力,教会我们如何构建一个高吞吐量的数据加载框架,而不是依赖传统的行级处理。这种实践导向的教学方法,让我得以跳出IDE的舒适区,真正去思考数据库层面的架构设计。读完这部分内容后,我立刻着手对我们现有系统中的一个缓慢的批处理作业进行了改造,效果立竿见影,性能提升了近四成。这本书的价值,就在于它提供的不是解决方案的“模板”,而是解决问题的“思维模型”。
对于那些准备冲击Oracle认证的同行来说,这本书的价值可能被严重低估了。我注意到,它在处理**高级错误处理机制**和**安全编程实践**方面的深度,完全可以作为专业级认证考试的辅助教材。书中对于`PRAGMA EXCEPTION_INIT`的详细说明,以及如何构建健壮的、能够向上层应用透明化传递错误的错误栈机制,远比官方文档来得清晰易懂。特别是关于`UTL_FILE`和`DBMS_SCHEDULER`的使用安全章节,明确指出了常见的安全漏洞(如路径注入),并提供了最佳实践。这种对细节的极致关注,体现了作者对生产环境复杂性的深刻洞察。我个人最欣赏的是它对“代码可维护性”的强调,鼓励读者使用清晰的命名规范和模块化的设计,这对于团队协作和长期项目维护至关重要,很多新手开发者往往只关注功能实现,而忽略了代码的“寿命”。
还行,介绍了基础,看了基本有了新的认识,介绍的不全,偏基础
还行,介绍了基础,看了基本有了新的认识,介绍的不全,偏基础
还行,介绍了基础,看了基本有了新的认识,介绍的不全,偏基础
还行,介绍了基础,看了基本有了新的认识,介绍的不全,偏基础
还行,介绍了基础,看了基本有了新的认识,介绍的不全,偏基础