
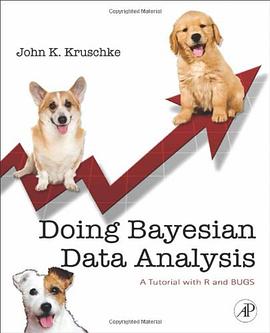
Doing Bayesian Data Analysis pdf epub mobi txt 电子书 下载 2026
- 统计
- R
- bayesian
- 贝叶斯
- Statistics
- 统计学
- 经济学
- 计算机
- 贝叶斯分析
- 数据分析
- 统计建模
- 概率编程
- R语言
- Stan
- PyMC3
- 马尔可夫链蒙特卡洛
- 统计推断
- 数据科学

具体描述
There is an explosion of interest in Bayesian statistics, primarily because recently created computational methods have finally made Bayesian analysis obtainable to a wide audience. Doing Bayesian Data Analysis, A Tutorial Introduction with R and BUGS provides an accessible approach to Bayesian data analysis, as material is explained clearly with concrete examples. The book begins with the basics, including essential concepts of probability and random sampling, and gradually progresses to advanced hierarchical modeling methods for realistic data. The text delivers comprehensive coverage of all scenarios addressed by non-Bayesian textbooks--t-tests, analysis of variance (ANOVA) and comparisons in ANOVA, multiple regression, and chi-square (contingency table analysis). This book is intended for first year graduate students or advanced undergraduates. It provides a bridge between undergraduate training and modern Bayesian methods for data analysis, which is becoming the accepted research standard. Prerequisite is knowledge of algebra and basic calculus. Author website: http://www.indiana.edu/~kruschke/DoingBayesianDataAnalysis/
-Accessible, including the basics of essential concepts of probability and random sampling -Examples with R programming language and BUGS software -Comprehensive coverage of all scenarios addressed by non-bayesian textbooks- t-tests, analysis of variance (ANOVA) and comparisons in ANOVA, multiple regression, and chi-square (contingency table analysis). -Coverage of experiment planning -R and BUGS computer programming code on website -Exercises have explicit purposes and guidelines for accomplishment
作者简介
目录信息
读后感
Chapter 1 - 3 R basics getwd() Change work directory: Session -> Set Work directory List the files in the working directory: dir() ls() source("mycode.r") myfunction <- function() { x<-rsnorm(100) mean(x) } second <- function(x) { x+rnorm(length...
评分力荐给缺乏足够统计基础(如非stats专业 bachelor)的初学者。Dr. Kruschke自己有blog,会经常在上面回答(书中提到的)问题和深入讨论。 使用的软件是R,主要算法集中在Gibbs Sampler方面,对HMC没有太多介绍。 另读完之后想要完全独立做Bayesian,还是要回去吃下Gelman的书。
评分力荐给缺乏足够统计基础(如非stats专业 bachelor)的初学者。Dr. Kruschke自己有blog,会经常在上面回答(书中提到的)问题和深入讨论。 使用的软件是R,主要算法集中在Gibbs Sampler方面,对HMC没有太多介绍。 另读完之后想要完全独立做Bayesian,还是要回去吃下Gelman的书。
评分Chapter 1 - 3 R basics getwd() Change work directory: Session -> Set Work directory List the files in the working directory: dir() ls() source("mycode.r") myfunction <- function() { x<-rsnorm(100) mean(x) } second <- function(x) { x+rnorm(length...
评分Chapter 1 - 3 R basics getwd() Change work directory: Session -> Set Work directory List the files in the working directory: dir() ls() source("mycode.r") myfunction <- function() { x<-rsnorm(100) mean(x) } second <- function(x) { x+rnorm(length...
用户评价
从排版和装帧上看,这本书的设计也体现了对读者的友好。纸张的质感很好,长时间阅读下来眼睛的疲劳感减轻了不少,这对于一本需要投入大量时间的专业书籍来说非常重要。更不用说字体选择和行距的舒适度,它们共同营造出一种沉浸式的阅读体验。虽然内容本身是高强度的,但物理载体的舒适感无疑是锦上添花,它让你更愿意拿起它,而不是将其束之高阁。很多时候,一本好的技术书不仅仅是内容的集合,它还关乎阅读的体验本身。这本书在这方面做得非常到位,它在细节之处流露出的匠心,让人感到自己被重视。这种对阅读体验的关注,使得原本略显枯燥的统计学习过程变得更加愉悦和持久,无疑极大地提高了我的学习效率和坚持度。
评分这本书的实践导向性强得令人印象深刻。很多统计教材要么理论深奥到让人望而却步,要么代码示例陈旧到根本无法运行。但这部作品巧妙地平衡了两者。它没有回避那些晦涩难懂的理论基础,但紧接着就会提供清晰、现代化的编程实践来巩固知识点。我特别欣赏作者在章节末尾设置的“动手环节”,这些任务设计得非常巧妙,它们要求读者将刚刚学到的概念应用到实际数据集上,而且所需工具链的配置也相对友好,基本上能顺利接入主流的统计编程环境。我感觉自己不是在读一本教科书,而是在参与一个长期的、循序渐进的项目,每完成一章,我的项目经验值和信心就得到了切实地提升。对于那些希望快速将理论转化为实际数据分析能力的人来说,这种“边学边做”的节奏感是至关重要的,它有效地避免了“纸上谈兵”的窘境,真正实现了知识到技能的转化。
评分这本书的魅力在于它对“不确定性”这个核心概念的深刻洞察和细致描绘。在许多传统统计学著作中,P值和显著性往往被视为终极真理,但本书却以一种温和而坚定的方式,引导读者跳出二元对立的思维陷阱。它展示了如何将世界观中的主观判断(即先验信息)系统地融入到客观的数据分析流程中,这对于处理小样本或信息稀疏的数据场景尤其关键。我特别喜欢它关于模型选择和模型平均的讨论,它不再推崇“找到最好的那个模型”的教条,而是鼓励我们拥抱“模型的不确定性”。这种哲学层面的转变,使得我在未来的数据解读中,会更加谦逊和负责任。它不光教会了我们如何计算,更教会了我们如何带着批判性和情境意识去解释那些数字背后的故事,这对于任何一个严肃的数据科学家来说,都是无价之宝。
评分我必须承认,这本书的叙事风格相当成熟和严谨,它散发着一种学术的厚重感,但又绝不枯燥。作者在行文间,似乎始终保持着一种对读者智力的尊重,从不轻易简化问题的复杂度,而是引导读者去直面这些复杂性。它的章节组织逻辑性极强,从基础概念的奠基,到复杂模型的搭建,再到最终的后验预测和模型比较,每一步都衔接得天衣无缝,如同精心铺设的轨道。这种结构上的完美,极大地降低了学习曲线的陡峭程度。对于那些追求体系化知识架构的学习者而言,这本书提供了一个近乎完美的蓝图。你不需要东奔西跑去寻找补充材料来填补知识的断层,因为它似乎已经预见到了你可能在哪个环节产生疑问,并提前在后续章节中做了精妙的铺垫和解答。阅读它,就像是在一位经验极其丰富的导师的指导下,系统地构建起自己的知识大厦。
评分这本书的讲解方式真是独树一帜,它没有那种填鸭式的说教,而是像一个经验丰富的老教授在和你进行深入的对话。作者似乎深知我们这些初学者在面对复杂概率论和统计学概念时的困惑,所以他总能找到最恰当的比喻和最直观的例子来搭建理解的桥梁。尤其是在介绍MCMC(马尔可夫链蒙特卡洛)算法时,那种抽丝剥茧的叙述,让我第一次真正感觉到了这个强大工具的内在逻辑,而不是仅仅停留在公式的堆砌上。我记得有一次为了阐述先验分布的重要性,作者用了个关于考古发现的生动故事,一下子就把抽象的贝叶斯哲学思想具象化了。阅读过程带来的启发性远超出了学习技术本身,它更像是一次思维模式的重塑,让我开始以一种更审慎、更具情境化的方式去看待数据和不确定性。如果你是那种需要“为什么”而不是仅仅需要“怎么做”的学习者,这本书绝对能满足你对深度探究的渴望,它教会你的不仅仅是计算,更是思考的框架。那种豁然开朗的感觉,着实让人上瘾。
评分更新:豆瓣书评群魔乱舞。Dr. Kruschke本人的确是Bayesian死忠,但他1、不是极端主义者2、不是左倾主义者,左倾这个词是说政治倾向的,不懂不要乱用。更有甚者说这本书的内容偏过去的传统统计?Bayesian上世纪70年代就有了知道吗?那叫frequentist不叫传统!书的第一章给你讲frequentist是怕你不懂基本概念带你复习,这怕是只看了第一章就胡扯 力荐给缺乏足够统计基础(如非stats专业 bachelor)的初学者。Dr. Kruschke自己有blog,会经常在上面回答(书中提到的)问题和深入讨论。 使用的软件是R,主要算法集中在Gibbs Sampler方面,对HMC没有太多介绍。 另读完之后想要完全独立做Bayesian,还是要回去吃下Gelman的教材
评分更新:豆瓣书评群魔乱舞。Dr. Kruschke本人的确是Bayesian死忠,但他1、不是极端主义者2、不是左倾主义者,左倾这个词是说政治倾向的,不懂不要乱用。更有甚者说这本书的内容偏过去的传统统计?Bayesian上世纪70年代就有了知道吗?那叫frequentist不叫传统!书的第一章给你讲frequentist是怕你不懂基本概念带你复习,这怕是只看了第一章就胡扯 力荐给缺乏足够统计基础(如非stats专业 bachelor)的初学者。Dr. Kruschke自己有blog,会经常在上面回答(书中提到的)问题和深入讨论。 使用的软件是R,主要算法集中在Gibbs Sampler方面,对HMC没有太多介绍。 另读完之后想要完全独立做Bayesian,还是要回去吃下Gelman的教材
评分After a year of persistent reading, I finally finished this grimoire of statistical dark magic. Best statistical book, ever. Reading it was a testimony of my two major sources of motivation: stubbornness and hatred of incompetence.
评分简单生动,并且配上代码
评分看了大半,耐心缺乏,读不下去了
相关图书


本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有