

具体描述
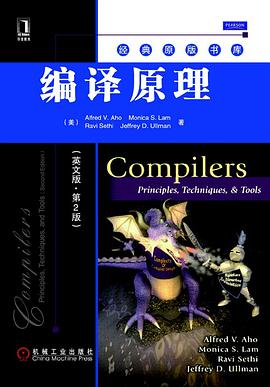
本书是编译领域无可替代的经典著作,被广大计算机专业人士誉为“龙书”。本书上一版自1986年出版以来,被世界各地的著名高等院校和研究机构(包括美国哥伦比亚大学、斯坦福大学、哈佛大学、普林斯顿大学、贝尔实验室)作为本科生和研究生的编译原理课程的教材。该书对我国高等计算机教育领域也产生了重大影响。 第2版对每一章都进行了全面的修订,以反映自上一版出版20多年来软件工程。程序设计语言和计算机体系结构方面的发展对编译技术的影响。本书全面介绍了编译器的设计,并强调编译技术在软件设计和开发中的广泛应用。每章中都包含大量的习题和丰富的参考文献。 本书适合作为高等院校计算机专业本科生和研究生的编译原理与技术课程的教材,也可供广大计算机技术人员参考。
作者简介
Alfred V.Aho,美国歌伦比亚大学教授,美国国家工程院院士,ACM和IEEE会士,曾获得IEEE的冯·诺伊曼奖。著有多部算法、数据结构、编译器、数据库系统及计算机科学基础方面的著作。
Monica S.Lam,斯坦福大学计算机科学系教授,曾任Tensilica的首席科学家,也是Moka5的首任CEO。曾经主持SUIF项目,该项目产生了最流行的研究用编译器之一。
Ravi Sethi,Avaya实验室总裁,曾任贝尔实验室高级副总裁和Lucent Technologies通信软件的CTO。他曾在宾夕法尼亚州立大学,亚利桑那州立大学和普林斯顿大学任教,是ACM会士。
Jefirey D.Ullman斯坦福大学计算机科学系教授和Gradiance CEO。他的研究兴趣包括数据库理论、数据库集成、数据挖掘和利用信息基础设施教学等。他是美国国家工程学院院士、IEEE会士,获得过ACM的Karlstrom杰出教育奖和Knuth奖。
目录信息
1.1 language processors
1.2 the structure of a compiler
1.3 the evolution of programming languages
1.4 the science of building a compiler
1.5 applications of compiler technology
1.6 programming language basics
1.7 summary of chapter 1
1.8 references for chapter 1
2 a simple syntax-directed translator
2.1 introduction
2.2 syntax definition
2.3 syntax-directed translation
2.4 parsing
2.5 a translator for simple expressions
2.6 lexical analysis
2.7 symbol tables
2.8 intermediate code generation
2.9 summary of chapter 2
3 lexical analysis
3.1 the role of the lexical analyzer
3.2 input buffering
3.3 specification of tokens
3.4 recognition of tokens
3.5 the lexical-analyzer generator lex
3.6 finite automata
3.7 from regular expressions to automata
3.8 design of a lexical-analyzer generator
3.9 optimization of dfa-based pattern matchers
3.10 summary of chapter 3
3.11 references for chapter 3
4 syntax analysis
4.1 introduction
4.2 context-free grammars
4.3 writing a grammar
4.4 top-down parsing
4.5 bottom-up parsing
4.6 introduction to lr parsing: simple lr
4.7 more powerful lr parsers
4.8 using ambiguous grammars
4.9 parser generators
4.10 summary of chapter 4
4.11 references for chapter 4
5 syntax-directed translation
5.1 syntax-directed definitions
5.2 evaluation orders for sdd's
5.3 applications of syntax-directed translation
5.4 syntax-directed translation schemes
5.5 hnplementing l-attributed sdd's
5.6 summary of chapter 5
5.7 references for chapter 5
6 intermediate-code generation
6.1 variants of syntax trees
6.2 three-address code
6.3 types and declarations
6.4 translation of expressions
6.5 type checking
6.6 control flow
6.7 backpatching
6.8 switch-statements
6.9 intermediate code for procedures
6.10 summary of chapter 6
6.11 references for chapter 6
7 run-time environments
7.1 storage organization
7.2 stack allocation of space
7.3 access to nonlocal data on the stack
7.4 heap management
7.5 introduction to garbage collection
7.6 introduction to trace-based collection
7.7 short-pause garbage collection
7.8 advanced topics in garbage collection
7.9 summary of chapter 7
7.10 references for chapter 7
8 code generation
8.1 issues m the design of a code generator
8.2 the target language
8.3 addresses in the target code
8.4 basic blocks and flow graphs
8.5 optimization of basic blocks
8.6 a simple code generator
8.7 peephole optimization
8.8 register allocation and assignment
8.9 instruction selection by tree rewriting
8.10 optimal code generation for expressions
8.11 dynamic programming code-generation
8.12 summary of chapter 8
8.13 references for chapter 8
9 machine-independent optimizations
9.1 the principal sources of optimization
9.2 introduction to data-flow analysis
9.3 foundations of data-flow analysis
9.4 constant propagation
9.5 partial-redundancy elimination
9.6 loops in flow graphs
9.7 region-based analysis
9.8 symbolic analysis
9.9 summary of chapter 9
9.10 references for chapter 9
10 instruction-level parallelism
10.1 processor architectures
10.2 code-scheduling constraints
10.3 basic-block scheduling
10.4 global code scheduling
10.5 software pipelining
10.6 summary of chapter 10
10.7 references for chapter 10
11 optimizing for parallelism and locality
11.1 basic concepts
11.2 matrix multiply: an in-depth example
11.3 iteration spaces
11.4 aftlne array indexes
11.5 data reuse
11.6 array data-dependence analysis
11.7 finding synchronization-free parallelism
11.8 synchronization between parallel loops
11.9 pipelining
11.10 locality optimizations
11.11 other uses of affine transforms
11.12 summarv of chapter 11
11.13 references for chapter 11
12 interprocedural analysis
12.1 basic concepts
12.2 why interprocedural analysis?
12.3 a logical representation of data flow
12.4 a simple pointer-analysis algorithm
12.5 context-insensitive interprocedural analysis
12.6 context-sensitive pointer analysis
12.7 datalog implementation by bdd's
12.8 summary of chapter 12
12.9 references for chapter 12
a a complete front end
a.1 the source language
a.2 main
a.3 lexical analyzer
a.4 symbol tables and types
a.5 intermediate code for expressions
a.6 jumping code for boolean expressions
a.7 intermediate code for statements
a.8 parser
a.9 creating the front end
b finding linearly independent solutions
index
· · · · · · (收起)
读后感
Insanely abstruse and convoluted. Reads like something written to deliberately confuse readers. Not to mention you have to flip the book nonstop for formulas/figures dozens of pages earlier.(It doesn't even have a pdf version!!!) Coupled with a prof who tal...
评分编译原理确实是一门很抽象的课程,很容易就看得云里雾里。 我的经验就是当看书看不懂的时候,就把书上面的代码敲下来,或者按照书上的思路自己写一个,在这个过程中,你就会发现不清楚的东西一点一点的清晰了。 另外,第一次看的同学:这本书确实很抽象,枯燥,甚至以后用到...
评分个人觉得中文翻译有些问题,倒不如看原版反而觉得某些概念更为清晰,看完了前七章,觉得对编程语言有了更为深刻的理解,读完这本书大家可以试着写一个有词法分析和语法分析的计算器,算是对知识的一种运用吧!你不一定要去做编译器,但是最好对编译器的运行机制和原理有个了解...
评分大学里面的课本,大多数都是一个稍微浓缩了的编译原理讲解,老师基本上还是要看看这本红龙书才敢讲课的。 如果说这本书有什么优点,那么可以这么说,很多编译原理的书都有很多错误,这些错误是因为他们的算法和这本书的不太一样。有些取了捷径。不是说算法不对,而是没有讲明...
评分个人觉得中文翻译有些问题,倒不如看原版反而觉得某些概念更为清晰,看完了前七章,觉得对编程语言有了更为深刻的理解,读完这本书大家可以试着写一个有词法分析和语法分析的计算器,算是对知识的一种运用吧!你不一定要去做编译器,但是最好对编译器的运行机制和原理有个了解...
用户评价
阅读体验上,我必须赞扬作者在行文风格上的拿捏。它既不像某些教材那样堆砌晦涩难懂的术语,让人望而却步,也不是那种过度口语化、流于表面的科普读物。作者似乎找到了一个绝佳的平衡点——用严谨的数学逻辑作为骨架,却填充了清晰、易于理解的叙述。很多复杂的概念,比如关于状态机的转换或者语法分析树的构建,在初次接触时往往令人困惑,但这本书的阐述方式,总能用一个恰到好处的比喻或者一个经过深思熟虑的实例来加以说明,犹如拨云见雾,豁然开朗。这种深入浅出的能力,对于自学者来说简直是福音。我已经开始习惯在遇到难题时,重新翻回到前几章,享受那种被引导着逐步攻克难关的成就感。
评分这本书的封面设计着实吸引人,那种带着复古气息的深沉色调和巧妙排版的字体,让人在书架上第一眼就被锁定。拿到手里,纸张的质感也相当不错,拿在手里沉甸甸的,透露出一种专业和厚重的气息。我通常更喜欢那些在设计上能体现出内容精髓的书籍,这本显然做到了。它不像市面上很多技术书籍那样追求浮夸的色彩和花哨的排版,而是用一种内敛而精准的方式,暗示了其内容的深度和严肃性。翻开目录,那清晰的结构和严谨的章节划分,就已经让人对接下来的阅读充满了期待。很明显,编著者在内容组织上下了极大的功夫,力求逻辑链条的完整与顺畅。这种对细节的关注,是优秀技术读物的基础,也让我确信这不是一本可以轻易浏览的书,而是需要静心钻研的工具书。
评分坦白说,我购买这本书是带着一定的功利性目的,希望能系统梳理一下计算机底层原理的脉络。这本书在理论深度上的覆盖面令人印象深刻。它不仅仅停留在描述“是什么”的层面,更深入探讨了“为什么会这样设计”的内在驱动力。例如,对于不同类型文法和解析策略的比较分析,不仅仅是罗列优缺点,而是深入到了设计选择背后的计算复杂度和实际工程可行性考量。这种对原理的深挖,使得读者在未来面对新的编程语言或编译器优化问题时,能够从更本质的角度去思考和解决,而不是仅仅停留在API层面的调用。这种理论指导实践的深度,远超我预期的“入门”标准,更像是一部详尽的“内功心法”。
评分这本书带给我的最大改变,在于思维模式的重塑。在阅读之前,我处理复杂系统的视角往往是线性的、自上而下的。然而,通过对这本书中描述的层层抽象和转换过程的学习,我开始意识到,一个看似简单的程序运行背后,蕴含着一个极其精妙和多层次的转化系统。这教会了我如何拆解一个宏大的工程问题,并理解每一层抽象是如何在保持必要信息的同时,丢弃不必要的细节。这种结构化的思维训练,不仅提升了我在技术问题上的分析能力,甚至也潜移默化地影响了我处理日常工作中的复杂项目管理和信息归纳的方式。它不仅仅是关于计算机科学的,更像是一本关于“结构化思维”的实战指南。
评分作为一本长期需要放在手边的参考书,书籍的装帧质量和排版布局是决定其“生命力”的关键因素。这本书的印刷质量稳定可靠,即便是经常翻阅和在上面做笔记,页边距和字体大小也给予了足够的空间,这对于需要反复对照和圈点的技术书籍至关重要。更值得一提的是,书中的插图和图表绘制得非常精美且富有信息量。它们不是随随便便放进去的装饰品,而是对文字描述的有力补充,很多时候,一个精心绘制的流程图胜过千言万语的解释。在查找特定算法实现细节时,那些清晰标注了各个组件和数据流向的示意图,极大地加快了我的定位速度,减少了阅读中的摩擦。
评分Fareware. Done, 2015年11月26日
评分重讀教材。不明白為啥當年我學這門課的時候這麽痛苦,當時讀此教材非常煩躁以至於基本沒仔細讀過。可能是大了兩歲,心智成熟了。挺順暢。講解清楚,抽象化形象,體系層次清晰(雖然就那麽幾個編譯階段不分章節寫也不可能233)作編譯基礎教材再合適不過了,編譯的基礎是後面很多東西的基石。
评分之前作为教材买的,没细看。对这一部分内容不大感冒吧。
评分读过parser的部分。其实现在Lexer和Parser的代码自动生成工具(Flex, Bison, Yacc)已经很强大了,不搞编译的话完全不用深入学习各种parse算法。
评分经典之所以成为经典,不是没有原因。基本编译前端你能遇到的东西,龙书无所不包,书中的娓娓道来实让很多教科书汗颜。
相关图书


本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有