
具体描述
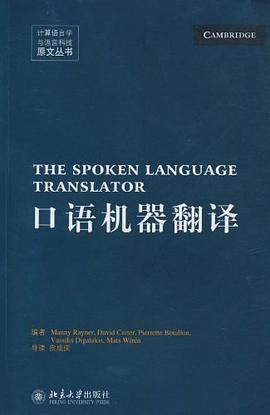
《口语机器翻译》主要内容简介:计算语言学研究滥觞于上世纪五六十年代的机器翻译研究。中文的相关研究也几乎同步开始,1960年起在柏克莱加州大学研究室,王士元、邹嘉彦、C.Y.Dougherty等人已开始研究中英、中俄机器翻译。他们的中文计算语言学研究,可说是与世界最尖端科技同步的。
作者简介
目录信息
Preface
Acknowledgements
Introduction
1.1 What This Book Is About
1.1.1 Why Do Spoken Language Translation?
1.1.2 What Are the Basic Problems?
1.1.3 What Is It Realistic to Attempt Today?
1.1.4 What Have We Achieved?
1.2 Overall System Architecture
1.3 An Illustrative Example
1.4 In Defence of Hand-Coded Grammars
1.5 Hybrid Transfer
1.5.1 The Need for Grammatical Knowledge
1.5.2 The Need for Preferences
1.6 Speech Processing
1.7 Corpora
Part 1 Language Processing and Corpora
Translation Using the Core Language Engine
2.1 Introduction: Multi-Engine Translation
2.2 Word-to-Word Translation
2.3 Quasi Logical Form
2.3.1 Introduction
2.3.2 Structure of QLF
2.3.3 QLF as a Transfer Formalism: Examples
2.3.4 Head-Head Relations in QLF
2.4 Unification Grammar and QLFs
2.4.1 The CLE Unification Grammar Formalism
2.4.2 Unification Grammar Example: French Noun Phrases
2.4.3 Example 2a: Clauses in Swedish
2.4.4 Example 2b: Relative Clauses in Swedish
2.5 Orthographic Analysis and the Lexicon
2.6 Transfer Rules
2.6.1 Pre- and Posttransfer
2.7 The QLF-Based Processing Path
2.7.1 Linguistic Analysis
2.7.2 Transfer and Transfer Preferences
2.7.3 Generation
2.8 Summary
Grammar Specialisation
3.1 Introduction
3.2 Explanation-Based Learning for Grammar
Specialisation
3.2.1 A Definition of Explanation-Based Learning
3.2.2 Explanation-Based Learning on Unification Grammars
3.2.3 Category Specialisation
3.2.4 Elaborate Cutting-Up Criteria
3.3 An LR Parsing Method for Specialised Grammars
3.3.1 Basic LR Parsing
3.3.2 Prefix Merging
3.3.3 Abstraction
3.4 Empirical Results
3.4.1 Experimental Setup
3.4.2 Discussion of Results
3.5 Conclusions
Choosing among Interpretations
4.1 Properties and Discriminants
4.2 Constituent Pruning
4.2.1 Discriminants for Pruning
4.2.2 Deciding Which Edges to Prune
4.2.3 Probability Estimates for Discriminants
4.2.4 Relation to Other Pruning Methods
4.3 Choosing among QLF Analyses
4.3.1 Analysis Choice: An Example
4.3.2 Further Advantages of a Discriminant Scheme .
4.3.3 Numerical Metrics
4.4 Choosing among Transferred QLFs
4.5 Choosing Paths in the Chart
The TreeBanker
5.1 Motivation
5.2 Representational Issues
5.3 Overview of the TreeBanker
5.4 The Supervised Training Process
5.4.1 Properties and Discriminants in Training
5.4.2 Additional Functionality
5.5 Training for Transfer Choice
5.6 Evaluation and Conclusions
Acquisition of Lexical Entries
6. 1 The Lexical Acquisition Tool, LexMake
6.2 Acquiring Word-to-Word Transfer Rules
6.3 Evaluation and Conclusions
Spelling and Morphology
7.1 Introduction
7.2 The Description Language
7.2.1 Morphophonology
7.2.2 Word Formation and Interfacing to Syntax
7.3 Compilation
7.3.1 Compiling Spelling Patterns
7.3.2 Representing Lexical Roots
7.3.3 Applying Obligatory Rules
7.3.4 Interword Rules
7.3.5 Timings
7.4 Some Examples
7.4.1 Multiple-Letter Spelling Changes
7.4.2 Using Features to Control Rule Application
7.4.3 Interword Spelling Changes
7.5 Debugging the Rules
……
Part 2 Linguistic Coverage
Part 3 Speech Processing
· · · · · · (收起)
读后感
用户评价
我必须坦诚地说,在阅读《口语机器翻译》之前,我对这个领域的研究知之甚少,甚至一度认为这不过是简单的词汇替换。然而,这本书以其宏大的视角和深刻的洞察力,彻底改变了我对机器翻译的看法。作者并没有简单地罗列技术名词,而是以一种引人入胜的方式,从人类语言的本质出发,层层递进地揭示了机器翻译的奥秘。我特别欣赏作者在阐述“序列到序列”模型时所展现出的逻辑清晰。从早期的统计机器翻译,到如今的端到端深度学习模型,每一步的变革都伴随着对前代技术局限性的深刻反思。在关于Transformer模型的部分,作者更是以一种非常直观的方式,阐释了“自注意力机制”是如何在不依赖循环结构的情况下,有效地捕捉长距离依赖关系的。这让我对机器处理复杂语言结构的能力有了全新的认识。更令我惊喜的是,这本书并没有将重点放在通用的文本翻译上,而是聚焦于“口语”机器翻译。作者深入分析了口语的非规范性、口音、语速、以及大量的非语言信号(如语气、停顿),并介绍了如何利用多模态技术来提升翻译的鲁棒性和准确性。书中关于“上下文感知”和“实时翻译”的讨论,更是让我看到了口语机器翻译的巨大潜力。我曾尝试着根据书中的指引,去了解一些相关的开源工具,虽然距离精通尚远,但整个过程让我对机器翻译的实际应用有了更直观的感受。这本书不仅是一本技术书籍,更是一本关于未来人机交互的探索指南,它让我对科技改变生活充满了期待。
不得不承认,在读《口语机器翻译》之前,我对机器翻译的认知仅仅停留在“翻译软件”的层面,总觉得它不过是基于大量词汇和语法的简单匹配。然而,这本书彻底颠覆了我的认知。作者以一种非常“技术派”但又极具启发性的方式,向我们揭示了口语机器翻译背后那庞大的、复杂的、而且还在不断演进的生态系统。我被书中关于“注意力机制”的详细讲解所深深吸引。作者并没有止步于公式的呈现,而是通过大量的类比和图示,将这个精妙的机制解释得淋漓尽致。它就像一个聪明的大脑,能够自动地在输入和输出序列之间建立联系,从而实现更精准的翻译。而且,本书对于“语境理解”的强调,让我明白了为什么机器翻译有时候会“答非所问”。作者深入分析了口语中的指代消解、省略、以及多义词等问题,并介绍了如何利用深度学习模型来捕捉这些微妙的语境信息。我尤其喜欢书中关于“上下文感知”的讨论,这正是实现高质量口语翻译的关键。书中的实际案例分析也做得非常到位,作者展示了如何在不同的场景下,比如旅行、学习、工作,应用口语机器翻译技术,并且分析了不同技术方案的优缺点。这让我感觉这本书不仅仅是一本理论著作,更是一本“实战指南”。我甚至尝试着按照书中的指引,去学习一些相关的编程库,虽然进展缓慢,但整个过程让我对机器翻译的实现有了更深刻的认识。这本书让我看到了科技的力量,也让我对未来的智能化交流充满了期待。
当我翻开《口语机器翻译》这本书时,我内心是充满期待又略带疑虑的。我一直认为,口语的即时性和丰富性是机器翻译难以企及的。然而,作者以其深厚的学术功底和独到的见解,成功地打破了我的这种固有观念。书中的开篇,并没有直接进入技术层面,而是从人类语言的演变和交际功能切入,让我对口语的本质有了更深层次的理解。随后,作者开始系统地梳理机器翻译的发展历程,从早期的基于规则的方法,到统计机器翻译,再到如今的深度学习驱动的模型,每一步的演进都伴随着对技术瓶颈的突破。我尤其被书中关于“神经机器翻译”的讲解所吸引。作者详细介绍了RNN、LSTM等模型是如何解决序列数据处理的难题,并对“注意力机制”进行了深入的阐释,让我明白了机器是如何在翻译过程中“关注”输入序列中的关键信息。更让我眼前一亮的是,本书对“口语”这一特定领域的深入挖掘。作者详细分析了口语中的各种非规范性特征,如俚语、缩略语、以及大量省略现象,并介绍了如何利用更复杂的模型和更丰富的数据来应对这些挑战。我印象最深刻的是关于“流式语音翻译”和“上下文感知的口语翻译”的讨论,这让我看到了未来实时、自然的口语交流场景的无限可能。这本书不仅仅是一本技术指南,更是一本充满智慧的探索,它让我看到了机器翻译在拉近人与人之间距离方面的巨大潜力。
作为一个对语言技术一直充满好奇的爱好者,我最近偶然发现了这本《口语机器翻译》,简直像打开了新世界的大门。书的开篇就抛出了一个极具吸引力的问题:机器是如何理解并“说”出另一种语言的?这个问题一下子就抓住了我的眼球。作者并没有一开始就抛出大量复杂的术语,而是从人类语言本身的特点出发,比如歧义性、语境依赖等等,然后引出机器翻译所面临的挑战。我特别欣赏作者在处理历史发展脉络时那种娓娓道来的方式,从早期的基于规则的方法,到后来的基于统计的方法,再到如今深度学习的浪潮,每一步的变革都清晰可见,而且作者总是能点出前一种方法的局限性,以及新方法是如何克服这些局限的。书中关于神经网络模型的部分,尤其让我感到震撼。作者详细介绍了RNN、LSTM、GRU等模型的工作原理,以及它们在序列数据处理上的优势。我还记得其中关于Encoder-Decoder架构的讲解,配以精美的流程图,让我对整个翻译流程有了非常清晰的认识。最让我惊喜的是,这本书并没有停留在理论层面,而是花了很大篇幅去探讨“口语”机器翻译的特殊性。作者深入分析了口语中的非标准表达、俚语、语气词、甚至是一些断断续续的表达,是如何影响翻译效果的,以及研究人员是如何通过各种技术手段来解决这些问题的。比如,书中提到的对抗性训练、数据增强等技术,让我对如何提高口语翻译的鲁棒性有了全新的认识。读完这本书,我对机器翻译的理解不再是停留在“输入一段文字,输出另一段文字”的表面,而是对背后复杂的算法、精妙的模型设计,以及为了解决真实世界问题所做的种种努力有了更深层次的体会。
我向来对那些能够将复杂技术转化为易于理解的概念的书籍情有独钟,而这本《口语机器翻译》恰恰做到了这一点。作者以一种娓娓道来的方式,将这个听起来有些高深莫测的领域,剖析得淋漓尽致。从人类语言的微妙之处,到机器模拟语言的艰难历程,每一个环节都阐述得条理清晰。我特别欣赏作者在解释“序列到序列”模型时所采用的逻辑。他首先回顾了早期的统计方法,指出了其在处理长距离依赖方面的不足,然后引出了神经网络模型的优势,特别是RNN、LSTM等模型是如何通过记忆单元来捕捉上下文信息的。而对于Transformer模型,作者更是花费了大量笔墨,详细解释了其核心的“自注意力机制”,并且用了一个非常贴切的比喻,让我一下子就明白了它为何能成为当前的主流模型。书中对“口语”这一特定领域,更是有着独到的见解。作者深入探讨了口语中的非规范性、非线性、以及大量的非语言信号(如语气、停顿、语速),并介绍了如何利用各种技术手段来解决这些挑战。我印象最深刻的是关于“多模态机器翻译”的讨论,比如如何结合语音信号和文本信息来提升翻译的准确性。这让我看到了口语机器翻译在应对真实世界复杂场景时的巨大潜力。本书的案例研究部分也做得非常扎实,作者选取了多个具有代表性的应用场景,并详细分析了其中的技术实现和挑战。这让我感觉这本书不仅仅是一本理论著作,更是一本指导实践的“百科全书”。
我必须说,这本《口语机器翻译》的出版,对于我这种长期混迹于机器翻译领域的研究人员来说,无疑是一场及时雨。它以一种非常系统和深入的方式,梳理了口语机器翻译的最新进展,并且难能可贵地将理论与实践相结合。我尤其欣赏作者在探讨模型演进时所展现出的批判性思维。他不仅仅是罗列模型,更重要的是分析了每种模型在处理口语数据时所表现出的优劣势。例如,在讨论Transformer模型之前,作者对RNN和CNN在序列建模方面的不足进行了深入的分析,为Transformer的出现奠定了坚实的理论基础。而对于Transformer的核心——Self-Attention机制,作者更是用一种非常直观的方式进行了阐释,让我们能够理解它是如何捕捉长距离依赖的。另外,本书对口语特有的挑战,如口语的非流畅性、语码转换、停顿、语气词等,进行了非常细致的梳理和分析,并且提出了相应的解决方案。我尤其对作者在书中提出的“上下文感知”和“风格迁移”的思路印象深刻,这些都是当前口语机器翻译领域非常前沿的研究方向。本书的案例研究部分也做得非常出色,作者选取了多个具有代表性的场景,比如在线教育、跨文化交流、甚至是语音助手交互,并对这些场景下的翻译技术进行了详细的讲解。这使得这本书不仅仅是一本理论书籍,更是一本实用的参考手册。从研究的角度来看,这本书为我们指明了未来的研究方向,也提供了解决实际问题的思路。读完这本书,我感觉自己的知识体系得到了极大的丰富和更新,对口语机器翻译的理解也达到了一个新的高度。
不得不说,《口语机器翻译》这本书给我带来了前所未有的惊喜。作为一名对人工智能领域充满好奇心的读者,我一直对机器翻译的发展感到惊叹,但同时也对其局限性有所了解。这本书以一种非常系统和深入的方式,带领我走进了口语机器翻译的复杂世界。作者的叙述方式非常引人入胜,他并没有一开始就抛出大量的技术术语,而是从人类学习语言的基本原理出发,逐步引申到机器如何模拟这个过程。我尤其喜欢书中关于“注意力机制”的讲解,作者用非常形象的比喻,让我瞬间就理解了这个机制的精妙之处。它就像一个聪明的学生,在听老师讲课时能够自动地抓住重点,并且将不同的信息点联系起来。更让我感到震撼的是,这本书不仅仅关注了文本翻译,而是将重点放在了“口语”这一更具挑战性的领域。作者深入分析了口语的非流畅性、语码转换、以及大量的口语化表达,并介绍了如何利用多模态技术来提升翻译的鲁棒性和准确性。我印象最深刻的是关于“上下文感知”和“风格迁移”的讨论,这让我看到了未来更加智能、更加个性化的口语翻译的可能性。书中的案例分析也做得非常出色,作者选取了多个具有代表性的场景,比如跨文化交流、在线教育、甚至是语音助手交互,并对这些场景下的翻译技术进行了详细的讲解。这让我感觉这本书不仅仅是一本理论著作,更是一本“实战指南”。总而言之,这是一本极具启发性和深度的著作,它让我对口语机器翻译的未来充满了无限的憧憬。
这部《口语机器翻译》我真的是爱不释手,从拿到这本书的那一刻起,就深深地被它吸引了。我之前对机器翻译这个领域一直保持着高度的好奇,但总觉得理论性太强,有些遥不可及。直到翻开这本书,我才发现,原来如此复杂的概念,在作者的笔下变得如此生动有趣。书中的案例分析非常详实,不是那种枯燥的公式堆砌,而是结合了实际的翻译场景,比如跨国会议、旅游交流、甚至是网络聊天,都一一进行了剖析。我尤其喜欢作者在讲解模型架构时,那种层层递进的思路,从最早的统计机器翻译,到后来的神经网络机器翻译,再到如今的Transformer模型,每一步的演进都解释得非常到位。让我印象深刻的是,作者并没有回避技术上的难点,而是用通俗易懂的语言,辅以大量的图示,将复杂的算法原理化繁为简。比如说,在解释Attention机制的时候,作者用了一个非常形象的比喻,一下子就点通了我之前的困惑。而且,这本书不仅仅是理论的梳理,它还包含了大量的实践指导。作者分享了许多开源工具的使用方法,以及如何评估翻译质量的各种指标。这对我这样一个想要动手实践的人来说,简直是雪中送炭。我尝试着跟着书中的例子,用Python跑了一些简单的模型,虽然效果和专业产品有差距,但整个过程让我对机器翻译的运作有了更直观的感受。这本书的语言风格也很有特点,不是那种死板的学术论文,而是带着一种探索的激情,读起来让人感觉仿佛在和一个经验丰富的老师进行面对面的交流。总而言之,这是一本兼具深度和广度,理论与实践并重的优秀著作,强烈推荐给所有对口语机器翻译感兴趣的朋友。
我最近非常着迷于《口语机器翻译》这本书,它就像一本百科全书,让我对这个领域有了前所未有的全面了解。作者的叙述方式非常吸引人,他并没有上来就讲解晦涩难懂的技术细节,而是先从人类学习语言的过程开始,然后引申到机器如何模仿这个过程。我尤其喜欢他对于“语言模型”的讲解,从N-gram模型到循环神经网络(RNN),再到如今的Transformer,每一种模型的演进都伴随着对前代模型局限性的深刻剖析。在关于Transformer的部分,作者花了大量篇幅来讲解其核心的“自注意力机制”,并且用了一个非常形象的比喻,让我瞬间就理解了这个机制的精妙之处。它就像一个聪明的学生,在听课的时候能够自动地抓住重点,并且将不同的信息点联系起来。而且,这本书不仅仅局限于文本翻译,它更侧重于“口语”机器翻译。作者深入探讨了口语的特点,比如非线性、不完整性、以及大量的口语化表达,并介绍了如何利用各种技术来克服这些挑战。我印象最深刻的是关于“语料库构建”和“数据增强”的部分,这让我明白了高质量的数据对于训练出优秀的机器翻译模型是多么重要。书中的案例分析也非常贴切,作者选取了许多实际的应用场景,比如跨国会议、在线教育、甚至是和外国朋友聊天,并详细分析了如何利用口语机器翻译技术来解决这些场景下的沟通难题。读完这本书,我感觉自己对机器翻译的理解不再是停留在表面,而是对它背后的复杂技术和精妙设计有了更深的认识,并且对它的未来发展充满了信心。
作为一名曾经在口译行业摸爬滚打多年的老兵,我对机器翻译一直持有一种既期待又谨慎的态度。这本《口语机器翻译》的出现,可以说极大地改变了我的一些看法。书中所描绘的口语机器翻译的未来图景,是如此的真实和诱人。我被书中关于“意图识别”和“情感分析”在口语翻译中的应用所吸引。以往的机器翻译更侧重于字面意思的转换,而这本书则强调了理解说话人的真实意图和情感,这对于实现真正意义上的“流畅”和“自然”的口语翻译至关重要。作者在书中举了许多例子,比如在商务谈判中,机器翻译不仅仅要准确传达信息,更要捕捉到双方的语气和态度,以避免不必要的误解。这正是机器翻译一直以来难以逾越的鸿沟。这本书在技术层面,也毫不避讳地深入探讨了最新的研究成果。我特别关注了书中关于“多模态机器翻译”的部分,比如结合语音信号和文本信息来提高翻译的准确性。这对于处理口语翻译的噪声、口音等问题,提供了非常有效的思路。作者甚至还提到了如何利用视觉信息来辅助口语翻译,这让我感到非常震撼,原来机器翻译已经发展到了如此精密的程度。而且,本书的写作风格非常具有亲和力,虽然涉及大量前沿技术,但作者总是能用生动形象的语言来解释,就像是在和一位经验丰富的同行交流一样。书中的一些反思和讨论,更是引发了我对自己过去工作经验的重新审视。总而言之,这本书让我看到了口语机器翻译的巨大潜力和光明前景,也让我对接下来的技术发展充满了期待。