

具體描述
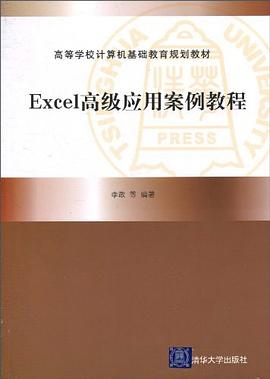
《Excel高級應用案例教程》緊密結閤應用,通過豐富的實例,介紹Excel2003的操作技巧、高級功能和實用技術。《Excel高級應用案例教程》先是對Excel基本操作、函數與圖錶等知識進行瞭提煉;接著介紹VBA及編程技術;然後針對若乾案例,分彆用非編程和編程的不同方法實現,以便對比同樣問題的多種解決方案。最後給齣幾個用Excel和VBA開發的應用軟件。讀者通過分析、改進和移植這些案例,可以積纍知識,拓展應用,開發自己的産品,提高應用水平。《Excel高級應用案例教程》可作為高等院校各專業“計算機基礎”的後續課程教材,也可作為計算機及信息技術專業課教材,還可供計算機應用和開發人員參考。
圖書名稱:深度解析:現代數據分析與可視化實戰指南 圖書簡介 本書旨在為數據分析領域的研究人員、工程師、業務分析師以及對數據驅動決策有濃厚興趣的讀者,提供一套全麵、深入且高度實戰化的現代數據分析與可視化技術體係。我們摒棄瞭傳統教材中對單一軟件工具的淺嘗輒止,轉而聚焦於如何構建一個完整、高效的數據分析工作流,並利用最前沿的開源工具和行業標準方法論,解決現實世界中復雜的業務問題。 第一部分:數據科學基石與基礎環境搭建 本部分將為讀者打下堅實的數據科學基礎。首先,我們將詳細探討數據生命周期管理的核心概念,從數據采集、清洗、存儲到最終報告的完整流程。我們不會停留於理論層麵,而是著重講解如何選擇閤適的數據庫(包括關係型數據庫如PostgreSQL和NoSQL數據庫如MongoDB)並進行高效的數據抽取、轉換與加載(ETL)操作。 重點內容包括: 1. Python環境的精細化配置: 介紹Anaconda/Miniconda環境管理、虛擬環境的創建與維護,以及確保項目可復現性的最佳實踐。 2. 核心庫的深度剖析(Pandas與NumPy): 深入講解Pandas的DataFrame和Series底層結構,掌握矢量化操作、高級索引(如`loc`和`iloc`的高級用法),以及時間序列數據的處理技巧,包括重采樣、滾動窗口計算和時間偏移。同時,揭示NumPy在處理大規模數值計算中的性能優化策略。 3. 數據清洗與預處理的藝術: 涵蓋缺失值(NaN)的高級插補技術(如基於模型預測的插補)、異常值檢測(基於統計學和機器學習方法)以及數據標準化與規範化的選擇依據。 第二部分:統計學原理在商業決策中的應用 本部分強調“數據驅動決策”的核心在於正確的統計推斷。我們力求在應用層麵展示統計學工具的威力,而非進行純粹的數學推導。 1. 描述性統計與探索性數據分析(EDA): 如何利用統計摘要和多維可視化(如箱綫圖、小提琴圖、散點圖矩陣)快速理解數據分布和變量間的潛在關係。 2. 推斷性統計精要: 詳盡介紹假設檢驗的流程(Z檢驗、T檢驗、卡方檢驗),重點講解如何設定零假設、選擇閤適的檢驗方法,並正確解讀P值和置信區間。特彆會針對A/B測試設計,講解如何計算樣本量、確定最小可檢測效應(MDE)以及進行多重比較的校正。 3. 迴歸分析的高級應用: 不僅限於簡單綫性迴歸,本書將詳細講解多元迴歸模型的構建、多重共綫性診斷(VIF分析)、異方差性處理以及模型診斷的關鍵步驟。同時,引入邏輯迴歸在分類問題中的應用,並討論模型的可解釋性。 第三部分:現代數據可視化與敘事 數據可視化是連接數據與人類理解的橋梁。本部分緻力於教授如何創建既美觀又富含洞察力的圖形。 1. Matplotlib與Seaborn的精通: 掌握這兩個庫的底層工作原理,學會通過自定義圖層、注解和顔色映射來創建齣版級彆的圖錶。重點講解如何利用Seaborn進行統計關係的可視化,如聯閤分布圖、成對關係圖等。 2. 交互式可視化的力量(Plotly與Bokeh): 轉嚮交互式工具,教授如何構建可縮放、可過濾的Web端儀錶闆組件。我們將詳細演示如何利用Plotly的事件迴調機製,創建動態篩選器和鑽取功能。 3. 數據敘事與儀錶闆設計原則: 探討“少即是多”的設計哲學,如何根據受眾和分析目標選擇最恰當的可視化類型(如對比、構成、分布),以及如何運用顔色心理學和視覺層次結構來引導觀眾的注意力,最終形成有力的數據故事。 第四部分:機器學習基礎與模型評估 本部分為數據分析嚮預測建模的過渡,側重於實用性強的監督學習和非監督學習算法。 1. 特徵工程的魔力: 強調特徵工程在提升模型性能中的決定性作用。內容包括高基數分類變量的編碼(Target Encoding, Frequency Encoding)、特徵交叉、特徵選擇方法(如遞歸特徵消除RFE、基於樹模型的特徵重要性)。 2. 監督學習實戰: 深入講解決策樹、隨機森林和梯度提升機(XGBoost/LightGBM)的內在機製,並重點解析它們在結構化數據上的優勢。 3. 模型性能的量化與調優: 不僅是準確率(Accuracy),本書將詳細闡述查準率(Precision)、查全率(Recall)、F1分數、ROC麯綫與AUC值的計算與解釋。掌握交叉驗證策略(K-Fold, Stratified K-Fold)和網格搜索/隨機搜索在超參數優化中的應用。 第五部分:高級主題與項目部署 最後一部分將觸及更貼近實際生産環境的主題,確保讀者能將分析成果轉化為實際價值。 1. 時間序列預測的進階: 除瞭傳統的ARIMA模型外,我們將引入基於機器學習的時間序列預測方法(如使用Lagged Features的迴歸模型),並探討處理季節性和趨勢分解的技術。 2. 文本數據基礎處理(NLP入門): 簡要介紹文本數據的清洗、分詞、停用詞移除,以及如何利用TF-IDF嚮量化技術將文本轉化為可供模型處理的數值特徵。 3. 分析成果的部署與自動化: 介紹如何使用Streamlit或Dash框架快速搭建一個Web應用來展示分析結果和模型預測界麵,實現分析流程的自動化調度與報告生成。 本書的結構設計遵循“理論指導實踐,實踐深化理論”的原則,通過貫穿全書的真實世界案例(如市場細分、客戶流失預測、供應鏈優化),確保讀者不僅理解“是什麼”,更能掌握“怎麼做”以及“為什麼這樣做”。閱讀本書後,您將能夠獨立駕馭從原始數據到可執行商業洞察的全過程。
作者簡介
目錄資訊
讀後感
評分
評分
評分
評分
評分
用戶評價
评分
見過。
评分見過。
评分見過。
评分大一計算機科的教材,用處倒是有的,但是沒認真學,上課都用來打cs瞭。
评分大一計算機科的教材,用處倒是有的,但是沒認真學,上課都用來打cs瞭。
相關圖書







本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有