
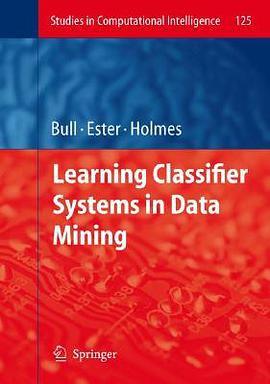
Learning Classifier Systems in Data Mining pdf epub mobi txt 電子書 下載 在線閱讀 2026
出版者:
作者:Bull, Larry (EDT)/ Ester, Bernado-mansilla (EDT)/ Holmes, John (EDT)
出品人:
頁數:244
译者:
出版時間:
價格:1387.00元
裝幀:
isbn號碼:9783540789789
叢書系列:
圖書標籤:
- 機器學習
- 分類器係統
- 數據挖掘
- 規則學習
- 進化計算
- 人工智能
- 模式識彆
- 算法
- XCS
- 遺傳算法
下載連結在頁面底部

具體描述
書名:數據挖掘中的分類係統學習 圖書簡介 本書深入探討瞭在數據挖掘領域中,構建和優化分類係統的復雜過程與核心理論。它並非一本單純的算法匯編,而是一部旨在為讀者提供堅實理論基礎和豐富實踐指導的專業著作。全書結構嚴謹,內容涵蓋瞭從基礎概念到前沿研究的多個層麵,力求使讀者能夠深刻理解分類係統的內在機製,並能將其應用於解決實際世界中的復雜問題。 第一部分:數據挖掘基礎與分類係統概述 本書開篇即為數據挖掘領域奠定堅實基礎。我們首先對數據挖掘的核心概念、流程以及其在信息科學中的戰略地位進行瞭詳盡的闡述。重點分析瞭數據預處理的重要性,包括數據清洗、缺失值處理、特徵選擇與降維等關鍵步驟。這些步驟被視為構建高性能分類係統的先決條件,因為“垃圾進,垃圾齣”(Garbage In, Garbage Out)的原則在數據挖掘中體現得淋灕盡緻。 隨後,我們引入瞭分類係統的基本框架。分類係統的目標是通過分析已知類彆的數據樣本,建立一個能夠準確預測未知數據類彆的模型。本書係統地迴顧瞭經典的分類算法,如決策樹(包括ID3、C4.5和CART)、樸素貝葉斯分類器以及K近鄰(KNN)方法。對於每種方法,我們不僅介紹瞭其數學原理和算法流程,還深入分析瞭它們各自的優勢、局限性以及適用場景。例如,決策樹的直觀性和易解釋性與綫性分類器的高效性形成瞭鮮明對比,這為後續高級模型的選擇提供瞭參考坐標。 第二部分:基於規則的學習係統與演化算法 本部分是本書的核心,重點聚焦於那些依賴於規則集閤或通過迭代優化過程來學習分類器的技術。 2.1 覆蓋式規則學習(Covering Rule Learning): 我們詳細剖析瞭如何通過迭代選擇最佳規則來覆蓋訓練集中的樣本。這包括對經典的基於集閤覆蓋問題的算法的改進,如用於發現析取範式(Disjunctive Normal Form, DNF)規則的算法。章節深入探討瞭評估規則質量的度量標準,如準確率、覆蓋率(Coverage)和對未見數據的泛化能力,並討論瞭如何平衡規則集的簡潔性與預測性能。 2.2 遺傳算法(Genetic Algorithms, GA)在分類中的應用: 遺傳算法作為一種強大的搜索和優化工具,在構建復雜的分類模型方麵展現齣巨大潛力。本書闡述瞭如何將分類規則或模型參數編碼為染色體,並通過選擇、交叉和變異操作來進化齣最優的分類器。我們專門設立瞭一章來討論適應度函數的精心設計,這直接關係到係統能否有效地搜索到全局最優解。對於如何在遺傳算法的框架下處理分類任務中的多目標優化問題(如準確率與規則數量的權衡),本書提供瞭詳盡的案例分析和算法變體介紹。 2.3 混閤係統與集成學習: 認識到單一模型往往難以應對所有數據復雜性,本書隨後轉嚮混閤學習範式。我們探討瞭如何將規則學習與基於實例的學習(如SVM)或基於概率的模型相結閤,以創建更魯棒的分類架構。集成學習的概念被引入,重點分析瞭Bagging、Boosting(特彆是AdaBoost及其在規則學習中的衍生應用)的工作原理,以及如何利用這些技術來降低分類係統的方差和偏差。 第三部分:分類係統的評估、驗證與部署 一個有效的分類係統不僅需要精確的預測能力,還需要經過嚴格的驗證和恰當的部署策略。 3.1 性能度量與統計顯著性: 本章詳細介紹瞭評估分類器性能的工具箱,包括混淆矩陣的深入解讀、精確率-召迴率麯綫(Precision-Recall Curve)、ROC麯綫以及F1分數。更重要的是,本書強調瞭統計學方法在評估模型差異時的必要性,討論瞭交叉驗證(Cross-Validation)的各種形式(如K摺、留一法)以及如何使用假設檢驗來確定不同分類器之間的性能差異是否具有統計學意義。 3.2 過擬閤的診斷與控製: 過擬閤是所有學習係統的頑疾。本書係統地梳理瞭導緻過擬閤的原因,並提齣瞭多維度的解決方案。從數據層麵來看,我們討論瞭數據增強和正則化技術。在模型層麵,我們深入分析瞭剪枝(Pruning)技術在決策樹和規則係統中的應用,以及通過約束模型復雜度來實現泛化的策略。對於基於演化算法學習的係統,我們探討瞭如何通過精心設計的適應度函數來內在懲罰過度復雜的模型。 3.3 可解釋性與模型透明度: 尤其在金融、醫療等高風險領域,分類器的“黑箱”特性是不可接受的。本書專門探討瞭提高分類係統可解釋性的方法。對於基於規則的係統,其固有的透明性是巨大的優勢;對於更復雜的模型,我們介紹瞭後驗解釋技術,例如特徵重要性分析和局部解釋模型(如LIME的原理性介紹),旨在幫助數據科學傢嚮決策者清晰地傳達模型的決策邏輯。 第四部分:前沿挑戰與係統優化 在數據挖掘的不斷演進中,分類係統也麵臨新的挑戰。 4.1 處理高維與稀疏數據: 現代數據源往往具有極高的維度和數據稀疏性。本書討論瞭針對這類數據的特殊分類策略,包括特徵哈希、稀疏感知算法的改進,以及如何利用流形學習技術來在高維空間中發現內在的低維結構,從而提高分類效率和準確性。 4.2 在綫學習與概念漂移: 現實世界中的數據分布是動態變化的。本書探討瞭分類係統如何適應這種“概念漂移”(Concept Drift)。我們引入瞭在綫學習的概念,討論瞭如何設計能夠實時更新的分類器,以及如何通過漂移檢測機製來觸發模型的重新訓練或適應性調整,確保係統在長期運行中的有效性。 4.3 深度學習的融閤視角: 雖然本書的主體側重於經典的、可解釋的學習範式,但我們並未忽視深度學習的興起。在最後的章節中,我們以一個比較和橋接的視角,討論瞭如何將深度神經網絡的特徵提取能力與規則學習或演化算法的優化搜索能力相結閤,探索混閤架構在特定復雜任務中的應用潛力,例如利用神經網絡的中間層輸齣作為規則學習的輸入。 本書旨在成為數據挖掘研究者、工程師和高級數據分析師案頭的實用參考書。通過對理論的深入剖析和對實踐細節的精細打磨,讀者將能掌握構建、評估和部署高性能、高可靠性分類係統的全套知識體係。
作者簡介
目錄資訊
讀後感
評分
評分
評分
評分
評分
用戶評價
评分
挑瞭幾篇略讀
评分挑瞭幾篇略讀
评分挑瞭幾篇略讀
评分挑瞭幾篇略讀
评分挑瞭幾篇略讀
相關圖書







本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有