
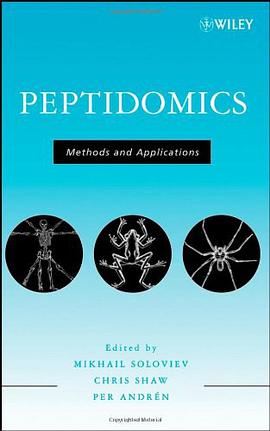

具体描述
The definitive guide to peptidomics- a hands-on lab reference
The first truly comprehensive book about peptidomics for protein and peptide analysis, this reference provides a detailed description of the hows and whys of peptidomics and how the techniques have evolved. With chapters contributed by leading experts, it covers naturally occurring peptides, peptidomics methods and new developments, and the peptidomics approach to biomarker discovery. Explaining both the principles and the applications, Peptidomics: Methods and Applications:
*Features examples of applications in diverse fields, including pharmaceutical science, toxicity biomarkers, and neuroscience
*Details the successful peptidomic analyses of biological material ranging from plants to mammals
*Describes a cross section of analytical techniques, including traditional methodologies, emerging trends, and new techniques for high throughput approaches
An enlightening reference for experienced professionals, this book is sufficiently detailed to serve as a step-by-step guide for beginning researchers and an excellent resource for students taking biotechnology and proteomics courses. It is an invaluable reference for protein chemists and biochemists, professionals and researchers in drug and biopharmaceutical development, analytical and bioanalytical chemists, toxicologists, and others.
作者简介
目录信息
读后感
用户评价
这本书,嗯,说实话,刚拿到手的时候还有点小小的期待,毕竟“Peptidomics”这个名字听起来就挺高大上的,感觉会是一本深入探讨蛋白质组学前沿的力作。我主要关注的是那些关于新型生物标志物的发现和验证的章节。读下来,发现它在理论框架的构建上确实下了不少功夫,对质谱技术的原理阐述得相当透彻,甚至连一些复杂的化学修饰过程都描绘得栩栩如生。不过,理想和现实总是有差距的。我希望能看到更多实际应用案例的深度剖析,比如在某种特定疾病诊断中的成功转化路径,或者在药物研发管线中如何利用肽段信息进行筛选优化。书中描绘的未来图景很美好,但对于一个希望快速将理论付诸实践的研究者来说,缺乏足够详实的“实操指南”和“失败教训总结”,让这本书的实用价值打了点折扣。它更像是一本扎实的教科书,而非一本能够立刻点燃你实验激情的“武功秘籍”。我花了大量时间去理解那些复杂的公式和图表,虽然受益匪浅,但总觉得少了那么一点点让人豁然开朗的“顿悟”时刻。
评分坦白说,这本书的语言风格非常学术化,逻辑严密到几乎不留任何歧义的余地。每一句陈述似乎都经过了反复的推敲和论证,引用文献的精准度也让人印象深刻。我特别喜欢它在介绍一些争议性研究结论时所采取的平衡态度,既不偏袒任何一方,而是客观地展示现有证据的优劣。这体现了作者极高的科学素养。不过,这种极致的严谨性,在某种程度上也牺牲了一定的可读性和流畅性。对于那些需要快速吸收信息、追求效率的读者来说,阅读体验可能会稍显沉重,需要集中极大的注意力才能跟上作者的论证节奏。我希望能有一些更生动的叙事手法来穿插其中,哪怕只是一小段关于某个突破是如何偶然发现的趣闻轶事,都能极大地缓解长时间阅读带来的疲劳感。它更像是一份严谨的法律文书,而非一本轻松的科普读物,适合深度钻研,不太适合碎片化学习。
评分这本书的排版和装帧绝对是业界良心,纸张的质感摸起来就很舒服,长时间阅读下来眼睛也不会太累。我特别欣赏它在方法学介绍上的那种近乎“手把手”的细致程度。例如,关于样本前处理的步骤,作者们似乎把所有可能遇到的陷阱都考虑进去了,从去盐的优化到酶解条件的精确控制,每一个微小的调整都配上了详尽的实验数据支持。这种严谨性,对于我们这些需要重复和验证实验的人来说,简直是福音。然而,有一点让我感到略微遗憾,那就是在讨论数据分析和生物信息学整合的部分,深度稍显不足。现在的研究越来越依赖于大数据和机器学习,而这本书在这方面的探讨似乎停留在比较基础的层面,没有过多涉及前沿算法的应用,比如深度学习在肽段识别中的潜力挖掘。当然,也许是作者的侧重点不同,但对于希望全面掌握整个肽段组学流程的读者来说,这部分内容的充实性是急需加强的。总而言之,这是一本值得放在案头作为工具书的参考资料,但它在连接“湿实验”与“干计算”之间的桥梁上,还有待加强。
评分我对这本书的评价,更多是基于它在学科历史梳理和概念引入方面的出色表现。作者们显然是下了苦功梳理了肽段组学从萌芽到成熟的整个发展脉络,每一个重要里程碑、每一项关键技术的突破,都被清晰地串联起来,形成了一幅宏大的历史画卷。这对于刚进入这个领域的学生或者希望系统性了解背景的科研人员来说,提供了极佳的认知框架。阅读过程中,我感觉自己仿佛置身于一个历史课堂,听着资深教授娓娓道来那些奠定学科基础的经典实验。然而,当我试图寻找一些关于**跨学科整合**的前沿观点时,就感到有些意犹未尽了。例如,肽段组学如何与基因组学、代谢组学进行更深层次的、非线性的信息交互,如何构建多组学网络模型来解释复杂的生理现象,这些更具前瞻性的讨论篇幅相对较少。这本书更像是奠基石,非常坚实,但我想看到的,是矗立在基石之上的那座摩天大楼的蓝图。它教会了我“是什么”,但对于“将要成为什么”的描绘还略显保守。
评分这本书在对**定量技术**的比较分析上做得相当到位,特别是对标记技术和非标记技术的优缺点进行了详尽的对比,表格清晰,对比直观。我非常依赖这部分内容来为我即将开展的课题选择最合适的定量策略。它不仅告诉我们A方法比B方法在灵敏度上略胜一筹,还深入剖析了这种差异背后的生物学或化学原因,这一点非常难得。但是,在涉及到**大规模临床样本处理**时,我发现作者们讨论的样本量和复杂性,似乎还停留在实验室的理想环境。现实中的临床样本往往受到采集时间、保存条件、患者病理状态等诸多不可控因素的影响,这些“脏数据”的处理策略,这本书涉猎不多。我期待能看到更多关于如何应对高变异性样本的经验分享,例如,如何设定更合理的质量控制标准,以及如何使用统计模型来校正批次效应。这本书提供了教科书式的完美流程,但现实研究往往充满“不完美”,在如何将这种完美流程适应到混乱的现实场景中,这本书的指导性略显不足。
评分 评分 评分 评分 评分相关图书








本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有