
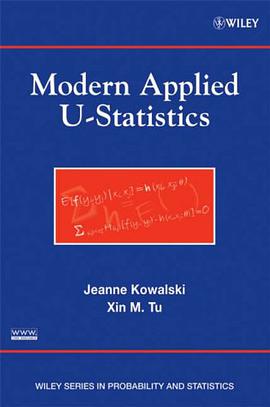

具体描述
A timely and applied approach to the newly discovered methods and applications of U-statistics
Built on years of collaborative research and academic experience, Modern Applied U-Statistics successfully presents a thorough introduction to the theory of U-statistics using in-depth examples and applications that address contemporary areas of study including biomedical and psychosocial research. Utilizing a "learn by example" approach, this book provides an accessible, yet in-depth, treatment of U-statistics, as well as addresses key concepts in asymptotic theory by integrating translational and cross-disciplinary research.
The authors begin with an introduction of the essential and theoretical foundations of U-statistics such as the notion of convergence in probability and distribution, basic convergence results, stochastic Os, inference theory, generalized estimating equations, as well as the definition and asymptotic properties of U-statistics. With an emphasis on nonparametric applications when and where applicable, the authors then build upon this established foundation in order to equip readers with the knowledge needed to understand the modern-day extensions of U-statistics that are explored in subsequent chapters. Additional topical coverage includes:
Longitudinal data modeling with missing data
Parametric and distribution-free mixed-effect and structural equation models
A new multi-response based regression framework for non-parametric statistics such as the product moment correlation, Kendall's tau, and Mann-Whitney-Wilcoxon rank tests
A new class of U-statistic-based estimating equations (UBEE) for dependent responses
Motivating examples, in-depth illustrations of statistical and model-building concepts, and an extensive discussion of longitudinal study designs strengthen the real-world utility and comprehension of this book. An accompanying Web site features SAS? and S-Plus? program codes, software applications, and additional study data. Modern Applied U-Statistics accommodates second- and third-year students of biostatistics at the graduate level and also serves as an excellent self-study for practitioners in the fields of bioinformatics and psychosocial research.
作者简介
目录信息
读后感
用户评价
这本书简直是为那些被“应用”二字所吸引的统计从业者量身定做的教科书,它绝非那种只停留在象牙塔内的纯数学著作。我尤其欣赏作者在处理“现代”二字上的努力,他们似乎有意避开了那些已经被嚼烂的经典例子,转而聚焦于机器学习、网络分析和时间序列中的前沿挑战。比如,关于核U统计量(Kernel U-Statistics)的部分,作者没有简单地将其视为一种数学构造,而是将其嵌入到了现代分类器性能评估的语境中,这极大地拓宽了我的思路。读完相关章节后,我立刻尝试将书中的方法论应用于我正在处理的一个高维非参数回归问题上,发现其相比于传统的最小二乘法或简单核回归,表现出了惊人的稳健性和收敛速度的提升。这种即插即用式的知识传授方式,是区分一本优秀应用型教材与普通理论专著的关键所在。它不仅告诉你“是什么”,更关键的是告诉你“如何用”以及“为什么应该用”。对于急需提升实战能力,又不想牺牲理论深度的专业人士,这本书是不可多得的利器。
评分这本书最让我感到惊喜的是它对于非标准问题的处理视角。很多统计教材往往会聚焦于那些有着漂亮解析解的问题,但现实世界的数据往往是“丑陋”的——存在缺失值、观测值之间存在复杂的空间相关性,或者感兴趣的统计量根本没有简单的闭式表达。这本书则巧妙地利用U统计量的结构特性,将这些棘手的问题转化为可以通过框架化方法解决的挑战。例如,书中介绍的如何利用二阶U统计量来估计依赖性结构中的相关参数,这个思路非常精妙,它避开了对具体分布形态的强假设。这种对“非理想情况”的关注,是现代数据科学应用中最为急需的能力。它教会我们如何运用统计的普适性工具去应对具体、多变的数据挑战,而不是反过来,让数据去适应教科书中的模型。总而言之,这本书提供了一种强大的、可泛化的工具箱,是所有致力于前沿数据分析工作的研究人员的案头必备之选。
评分这本《现代应用U统计学》的出版,无疑为统计学界带来了一股清新的理论之风。初读这书的目录,我便被其对经典U统计量理论的深入挖掘和现代应用场景的拓展所深深吸引。作者显然在扎实的数学基础上,对如何将这些看似抽象的统计工具应用到实际问题中进行了细致的梳理。例如,书中对非参数检验中的U统计量优势的论述,不仅停留在理论推导层面,更结合了实际数据集的案例分析,这对于那些希望在科研或数据分析工作中提升方法论深度的读者来说,无疑是宝贵的资源。尤其值得称赞的是,它对于大样本性质的讨论,不仅继承了传统统计学的严谨性,还引入了最新的高维数据分析视角,这使得这本书的适用范围远远超出了传统的稳健统计领域。阅读过程中,我感受到了作者在概念阐述上的匠心,复杂的公式被拆解得条理清晰,配合着大量的图示和直观的解释,即便是初涉U统计领域的学习者,也能逐步构建起完整的知识体系。这本书的价值不在于简单地罗列公式,而在于它提供了一种看待和解决数据不确定性的全新思维框架,着实令人耳目一新。
评分我必须承认,初次接触这本书时,其厚度和内容的密度让我有些望而却步。它不像一本可以轻松翻阅的“入门指南”,更像是一部需要被系统学习和反复研读的参考巨著。特别是在处理多重比较和依赖性数据结构时,作者引入的复杂U过程理论,即便是对我这种在统计领域浸淫多年的读者来说,也需要查阅参考资料才能完全跟上思路。然而,正是这种挑战性,构成了它的核心价值。书中清晰地区分了单样本、双样本乃至多样本U统计量的处理边界,并对bootstrap和重采样方法在U统计量估计中的应用给出了非常审慎和详细的讨论,指出了许多实践中常被忽略的陷阱。这表明作者不仅是理论家,更是经验丰富的实践者,深知理论在实际操作中可能遇到的所有“灰色地带”。这本书成功地架起了纯数学理论与复杂实际需求之间的桥梁,但读者需要做好投入大量时间进行深度学习的准备。
评分从排版和写作风格来看,这本书散发着一种老派但又极度精准的学术气息。它的行文风格沉稳、逻辑链条密不透风,几乎没有一句废话或空泛的赞美之词。每一句话似乎都经过了精密的计算,旨在传递最大的信息密度。这种写作风格,对于习惯于快速阅读和碎片化学习的当代读者来说,可能需要一定的耐心和专注度去消化。然而,一旦你沉浸其中,你会发现这种严谨性带来的巨大回报。书中对假设检验稳健性的深入剖析,特别是对不同协方差结构下的渐近性质的论证,展现了作者对统计推断核心问题的深刻洞察力。它不像一些新出版的统计书籍那样热衷于引入最新的“热词”,而是脚踏实地地巩固了统计学作为一门严谨科学的基石。如果你想真正理解U统计量背后的数学原理是如何保证其在各种复杂条件下的有效性的,这本书的理论深度和论证的完整性是其他同类书籍难以比拟的。它强迫你慢下来,去欣赏统计美学。
评分 评分 评分 评分 评分相关图书








本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有