
具体描述
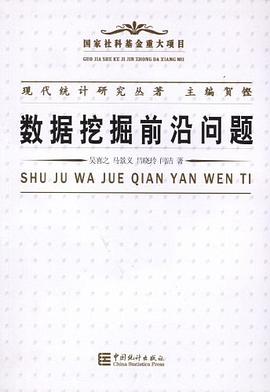
《现代统计研究丛著:数据挖掘前沿问题》所涉及的是代表统计领域发展最快的部分,也是对传统统计提出最重大挑战的部分,这就是在数据挖掘实践中发展的新方法。而《现代统计研究丛著:数据挖掘前沿问题》所着重说明的前沿问题是:数据挖掘方法中最普遍应用的分类和回归中成为近年来发展热点的组合方法。
《现代统计研究丛著》是一套旨在汇集当前统计学领域前沿理论与应用研究的学术著作。本丛书并非简单罗列,而是力图展现统计学方法在解析复杂现实问题中的深度与广度,以及其在各个学科分支中的创新性发展。本套丛书的编辑团队由一批在国际统计学界享有盛誉的学者组成,他们精选了近年来在理论突破、方法创新以及跨学科应用方面具有里程碑意义的最新研究成果,并邀请相关领域的顶尖专家撰写,确保了丛书的学术高度与前瞻性。 丛书的编排并非随意的堆砌,而是遵循了逻辑严谨的体系化原则。它首先会深入探讨现代统计推断的理论基石。这包括但不限于对传统参数统计模型进行深化拓展,例如在贝叶斯统计、最大似然估计、广义线性模型等方面的最新理论进展。重点会放在对模型选择、模型诊断、模型稳健性等关键问题的深入剖析,以及如何在高维数据、复杂依赖结构下进行有效的统计推断。 紧随理论基石之后,丛书将重点关注机器学习与统计学的交叉领域。随着大数据时代的到来,机器学习的崛起深刻地影响了统计学的发展。本丛书将详细介绍如何将机器学习的强大预测能力与统计学的严谨解释性相结合。例如,深度学习模型在统计建模中的应用,如神经网络、卷积神经网络、循环神经网络等如何被用于处理图像、文本、时间序列等复杂数据。同时,也会探讨如何从统计学的角度理解和改进机器学习算法,例如核方法、支持向量机、集成学习(如随机森林、梯度提升树)的统计学原理,以及如何进行模型解释、不确定性量化等。这一部分将重点关注模型的理论性质,如一致性、渐近性质,以及在非参数和半参数框架下的最新成果。 除了预测模型,因果推断将是本丛书的另一大重点。在科学研究和社会决策中,理解变量之间的因果关系至关重要。丛书将系统梳理和介绍现代因果推断的最新理论和方法。这包括但不限于潜在结果框架(Rubin Causal Model)、结构方程模型、图模型在因果发现与推断中的应用。重点将放在如何处理混杂偏倚、选择偏倚,以及在观测数据中进行因果识别的各种策略,如倾向性得分匹配、阻断、工具变量法等。此外,针对动态因果效应、异质性因果效应以及大数据背景下的因果推断,也会有专门的章节进行深入探讨。 高维数据分析是现代统计学面临的另一项重大挑战,也是本丛书不可或缺的组成部分。随着数据维度远远超过样本数量,传统的统计方法往往失效。丛书将系统介绍解决这一问题的各种统计策略。这包括但不限于变量选择(如Lasso, Elastic Net)、降维技术(如主成分分析、因子分析的变种)、正则化方法、稀疏性模型等。重点将放在分析这些方法在高维情况下的理论性质,如收敛速度、渐近性质,以及如何在保证统计效率的同时提高计算效率。同时,也会探讨在不同数据结构(如高维协方差矩阵、高维回归)下的具体分析方法。 非参数与半参数统计作为统计学的重要分支,在本丛书中也将得到充分的体现。这部分将介绍不依赖于具体模型假设的统计方法。例如,核密度估计、局部多项式回归、样条回归、核回归等非参数回归方法,以及如何处理非参数模型中的高维问题。半参数模型因其兼具灵活性和效率,在实际应用中扮演着重要角色,本丛书将详细介绍各种半参数回归模型,如部分线性模型、加性模型,以及如何对这些模型进行估计和推断。 贝叶斯统计的最新发展及其在复杂模型中的应用也是本丛书的重要主题。除了贝叶斯推断的基本原理,丛书将着重介绍马尔可夫链蒙特卡罗(MCMC)方法在复杂模型中的高效实现,如Hamiltonian Monte Carlo (HMC)及其变种。同时,也会探讨贝叶斯非参数模型,如Dirichlet过程混合模型,及其在聚类、密度估计等问题上的应用。此外,贝叶斯模型评估和模型比较的方法,如DIC, WAIC, LOO-CV等,以及如何在机器学习框架下应用贝叶斯思想,如贝叶斯神经网络,也会被深入讨论。 时间序列分析与面板数据分析在经济学、金融学、生态学等领域具有广泛的应用。本丛书将涵盖经典时间序列模型(如ARIMA, GARCH)的最新理论进展,以及非线性时间序列模型、状态空间模型、高频时间序列分析等前沿内容。对于面板数据,将重点介绍动态面板模型、非参数面板模型、面板数据中的因果推断等。 空间统计与地理统计学在环境科学、公共卫生、城市规划等领域发挥着关键作用。本丛书将介绍空间自相关、空间协方差函数、克里金插值、空间回归模型等经典理论,并在此基础上深入探讨在大规模空间数据分析中的挑战与解决方案,如如何处理大规模空间数据的计算效率问题,以及在不规则空间区域上的统计建模。 生物统计学作为统计学的重要应用领域,本丛书将收录相关前沿研究,例如在基因组学、蛋白质组学、流行病学、临床试验设计与分析等方面的最新统计方法。这可能包括高维基因组数据的统计分析、生存分析的最新理论、随机对照试验的设计与分析,以及在大规模生物医学数据中的因果推断。 计算统计学的进步是现代统计学得以发展的驱动力之一。本丛书将探讨高效的算法设计,如优化算法、蒙特卡洛方法、自助法(bootstrap)、置换检验等。同时,也会关注在大数据环境下进行统计计算的挑战,如分布式计算、并行计算在统计分析中的应用,以及如何设计高效的统计软件和工具。 数据科学与统计学的融合是当前研究的热点。本丛书将探讨统计学在数据科学中的核心地位,以及如何将统计学的严谨性融入数据科学的整个流程,从数据采集、预处理、探索性分析,到模型构建、评估与部署。这可能包括对数据挖掘、数据可视化、大数据治理等方面的统计学视角。 最后,本丛书还将关注统计学的伦理问题与可重复性研究。在科学研究日益依赖数据和计算的今天,如何确保研究的公正性、透明性,以及如何提高统计研究的可重复性,成为统计学界必须面对的重要课题。本丛书将探讨相关统计方法和实践。 总而言之,《现代统计研究丛著》旨在为统计学研究者、学生以及相关应用领域的专家提供一个了解统计学前沿动态、学习最新理论与方法、激发研究灵感的平台。它不仅是对现有知识的总结,更是对未来统计学发展方向的探索与展望。
作者简介
吴喜之,本科就读于北京大学数学力学系,美国北卡罗来那大学(Chapel Hill)统计系博士。在多所大学任教,曾经在国际国内专业杂志上发表过五六十篇文章,并且为十本专著和教科书的作者。
目录信息
第1章 数据挖掘概论
1.1 引言
1.2 统计学家和计算机学家从不同角度看数据挖掘
1.3 数据源
1.4 数据挖掘的应用
第2章 传统统计面对的挑战
2.1 统计的黑匣子特性
2.2 统计从数学继承了什么
2.3 传统的数据建模在应用中所遇到的问题
2.4 算法建模
2.5 回到统计的最初宗旨
第3章 常用算法建模概述
3.1 引言
3.2 关联规则分析
3.3 最近邻方法
3.4 人工神经网络
3.5 支持向量机
3.6 VC维数和误差界限
第4章 决策树
4.1 引言
4.2 决策树的构建
4.3 不纯度
4.4 ID3和C4.5算法
4.5 CART算法
4.6 CHAID方法
第5章 模型评价
5.1 引言
5.2 贝叶斯规则
5.3 模型评价——再论CART
5.4 推广误差和期望推广误差
5.5 推广误差和期望推广误差的估计
第6章 Bagging预测方法
6.1 Bagging方法简介
6.2 分类问题的Bagging算法
6.3 回归问题的Bagging算法
6.4 Out—of—Bag(OOB)估计
6.5 讨论
第7章 Boosting预测方法
7.1 AdaBoost算法
7.2 自适应重新抽样
7.3 AdaBoost算法的性质
7.4 可加模型:从统计的角度看AdaBoost
7.5 梯度下降提升算法
7.6 分类问题的不同损失函数及LogitBoost分类算法
7.7 回归问题的不同损失函数及L2—Boosting回归方法
7.8 讨论
第8章 随机森林
8.1 子模型h(x;Θm)
8.2 随机森林用于分类的案例
8.3 分类问题中随机森林算法预测精度
8.4 随机森林算法用于回归问题
8.5 随机森林中的OOB估计
8.6 再析随机森林算法
8.7 自适应随机森林算法
参考文献
· · · · · · (收起)