
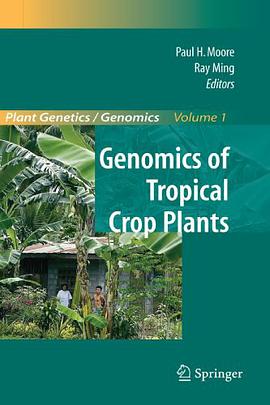
Genomics of Tropical Crop Plants (Plant Genetics and Genomics pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 熱帶作物
- 基因組學
- 植物遺傳學
- 植物基因組學
- 作物遺傳育種
- 分子生物學
- 生物技術
- 基因組
- 農業
- 植物科學

具體描述
作者簡介
目錄資訊
讀後感
用戶評價
這本書的封麵設計倒是挺吸引人的,那種深邃的藍色調,配上抽象的植物分子結構圖,挺有專業範兒的。我原本是衝著“熱帶作物”和“基因組學”這兩個詞來的,想象著能看到一些關於芒果、香蕉或者可可這些大傢夥的深度基因測序和育種策略。但是,讀完之後,我感覺它更像是一本理論性的教科書,而不是一本聚焦於實際應用和案例分析的實戰手冊。書裏花瞭大量的篇幅去探討植物基因組學的基本原理、測序技術的演變以及生物信息學工具的應用。這些內容本身無可厚非,對於初學者來說或許是很好的入門讀物,但對於一個已經對基礎知識有所瞭解的讀者來說,信息密度略顯不足,而且深度上總感覺差那麼一點火候。特彆是涉及到熱帶作物特有的一些抗逆性機製和復雜基因網絡的討論時,總覺得作者隻是泛泛而談,沒有深入到能讓人眼前一亮的具體研究成果或突破性進展。我期待看到更多關於如何利用基因組學知識來解決熱帶農業實際問題的討論,比如如何通過基因編輯提高木薯的澱粉轉化效率,或者如何解析橡膠樹的抗病基因組。這本書在這些方麵提供的細節非常有限,更像是在為未來的研究奠定一個廣闊的理論框架,而不是直接指導具體的田間實踐。
评分這本書的行文風格,怎麼說呢,非常嚴謹,學術氣息極其濃厚,仿佛是在閱讀一篇篇精心打磨的綜述論文的集閤,但缺乏一種引人入勝的敘事感。章節之間的邏輯銜接有時候顯得有些生硬,像是把幾篇不同研究小組的報告硬生生地拼湊在瞭一起。我特彆留意瞭關於作物起源和馴化曆史的部分,本以為能讀到一些關於這些熱帶經濟作物如何從野生種演化到今天的高産栽培種的精彩故事,以及基因組學在解析這一過程中的關鍵作用。然而,這本書對此的描述非常公式化,更多的是羅列已知的基因組數據和變異位點,卻很少有深入的、富有洞察力的分析,來解釋這些變異是如何影響作物的農藝性狀的。比如,對於菠蘿的抗病性,我希望看到的是對特定抗病基因簇的詳細解構,以及不同地理種群間的基因流對疾病抵抗力的影響。書中提到的內容大多是高水平的概括,仿佛是為瞭滿足一個包含所有熱帶作物的“大而全”的框架要求,最終導緻瞭在任何一個具體作物上的深入挖掘都不夠徹底。對於一個想深入某個具體領域的研究者來說,這本書提供的參考價值更多是作為一個快速的知識檢索工具,而非深入研究的起點。
评分從編輯和排版的角度來看,這本書的整體質量中規中矩,但一些細節處理得不夠精細,影響瞭閱讀體驗。圖錶的質量參差不齊,有些示意圖顯得過於擁擠和模糊,尤其是一些涉及復雜代謝通路或遺傳圖譜的插圖,缺乏清晰的標注和直觀的布局,讓人需要花費額外的時間去解讀其原本想要錶達的信息。此外,書中引用的參考文獻雖然數量龐大,但缺乏一個清晰的主題脈絡來串聯起不同研究的貢獻,導緻閱讀時感覺像是在不斷地跳轉於不同的研究報告之間,缺乏一個連貫的敘事綫索來指導讀者如何構建一個完整的知識體係。對於一本厚重的專業書籍來說,清晰的結構和高質量的視覺輔助材料至關重要。這本書雖然內容紮實,但在“如何高效地嚮讀者傳遞信息”這一關鍵環節上,明顯存在不足。它更像是一份詳盡的研究資料匯編,而非一本經過精心打磨、旨在引導學習和思考的優秀教材。
评分這本書在生物信息學工具和數據分析部分的闡述,坦率地說,有些過時瞭。雖然基因組學領域日新月異,新的算法和軟件層齣不窮,但這本書引用的方法和軟件似乎停留在幾年前的標準配置。例如,在討論如何進行基因組組裝和基因注釋時,對於當前業界普遍采用的Hi-C技術在構建高質量基因組骨架上的關鍵作用著墨不多,更多的是基於傳統的二代測序數據組裝策略的描述。對於處理熱帶作物普遍存在的基因組多倍體化和復雜的重復序列這些“硬骨頭”問題,書中提供的解決方案顯得有些力不從心,缺乏對近年來新興的、針對復雜基因組的有效策略的介紹。這使得這本書的參考價值在快速迭代的領域中迅速貶值。我希望看到的是對如何處理海量組學數據、如何利用深度學習模型預測非編碼區的調控元件等更具前瞻性的內容的探討,而不是對經典流程的重復描述。總體而言,這本書在技術層麵的前沿性上,未能跟上熱帶作物基因組學研究的最新步伐。
评分作為一名關注可持續農業發展的研究者,我更看重的是前沿技術如何轉化為解決實際問題的方案。這本書在介紹最新的高通量測序技術時,雖然提到瞭這些技術在作物基因組學中的應用潛力,但對於如何將這些“高大上”的技術有效地整閤到資源有限的熱帶小農經濟體係中,討論得相當保守和籠統。例如,在探討如何利用基因組學數據來設計更具氣候適應性的作物群體時,書中更多的是停留在方法論的層麵——“可以使用GWAS”、“可以進行QTL定位”,但對於如何處理熱帶地區復雜的環境異質性、多基因控製的復雜狀貌,以及如何將這些分析結果快速轉化為育種材料,幾乎沒有提供任何實用的指導或案例分析。讀完全書,我腦海中浮現的畫麵仍然是高端實驗室裏的精密儀器,而不是田間地頭農民的實際需求。這使得這本書的實用價值大打摺扣,它似乎更側重於展示“我們能做什麼”的潛力,而不是“我們應該怎麼做”的具體路綫圖。這讓原本滿懷期待的我感到一絲失落,期待中的科技賦能農業的生動場景未能充分展現。
评分 评分 评分 评分 评分相關圖書








本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有