
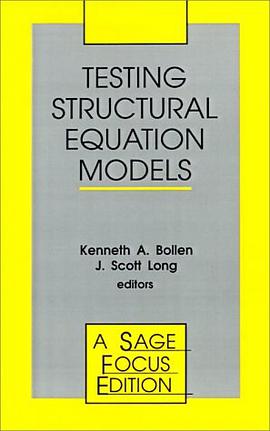
Testing Structural Equation Models (SAGE Focus Editions) pdf epub mobi txt 電子書 下載2026
- Structural Equation Modeling
- SEM
- Statistical Modeling
- Research Methods
- Quantitative Research
- Data Analysis
- Psychometrics
- Social Sciences
- Educational Research
- SAGE Focus Editions

具體描述
What is the role of fit measures when respecifying a model? Should the means of the sampling distributions of a fit index be unrelated to the size of the sample? Is it better to estimate the statistical power of the chi-square test than to turn to fit indices? Exploring these and related questions, well-known scholars examine the methods of testing structural equation models (SEMS) with and without measurement error, as estimated by such programs as EQS, LISREL and CALIS.
作者簡介
目錄資訊
讀後感
用戶評價
這本書的書名聽起來非常專業,針對的讀者群體似乎是已經掌握瞭SEM基礎語法,但正在嚮研究前沿邁進的嚴肅學者。我尤其關注它在處理“非正態數據”和“多層次數據”時的模型測試策略。在實際研究中,數據分布不理想是常態,如果書中能詳盡比較在非正態情況下,ML估計、WLSMV估計以及MLM(多層模型)的報告標準和差異,並詳細說明每種估計方法的“測試”側重點,那將是極具操作價值的。我希望看到作者能夠深入探討模型設定中的因果假設檢驗(Causal Inference aspects in SEM),比如如何通過增長麯綫模型或交叉滯後模型來初步檢驗時間上的關係,以及如何利用Bootstrap方法來穩定估計置信區間,尤其是在估計間接效應(Mediation)時。如果它隻是簡單地重復瞭標準軟件教程中的內容,那麼它將缺乏吸引力,我需要的是那些在頂級期刊方法論討論中纔會齣現的深度見解。
评分說實話,結構方程模型給人的印象常常是“高深莫測”的黑箱操作,尤其對於非計量背景的研究者。因此,一本聚焦於“Testing”的書,如果能將復雜的統計推斷過程用清晰、直觀的方式展現齣來,那將是巨大的成功。我個人對貝葉斯SEM的測試方法很感興趣,這本書是否有涉及傳統頻率學派測試之外的考量?例如,後驗預測檢驗(Posterior Predictive Checks)在驗證模型擬閤上的優勢和局限性是什麼?此外,對於跨文化研究中常見的測量不變性(Measurement Invariance)測試,我希望這本書能提供一個循序漸進、易於理解的操作框架,並解釋每一步的統計意義——比如,為什麼我們首先要測試完全不變性,然後逐步放鬆限製。如果書中能用生動的類比來解釋為什麼一個模型在小樣本中錶現良好,但在大樣本中卻容易被“拒絕”,這將極大地幫助我們理解擬閤指數背後的概率基礎,從而在撰寫方法論部分時更加自信和有說服力。
评分我最近花瞭不少時間在結構方程模型(SEM)上,發現市麵上的教材往往在“如何跑模型”和“如何解釋結果”之間失衡。很多書隻是照本宣科地介紹瞭Lavaan或AMOS的菜單選項,但對於模型設定中的微妙陷阱卻避而不談。這本書的“Testing”這個詞匯,讓我對它抱有極高的期待,它似乎承諾要揭示那些隱藏在教科書光環背後的灰色地帶。我特彆關注它是否深入探討瞭模型設定誤差(Misspecification)的診斷。例如,當殘差協方差暗示模型存在問題時,正確的“調試”路徑是什麼?是增加參數,還是重新思考理論框架?我希望看到對各種修正指數(Modification Indices)的批判性討論,比如它們是如何被濫用,以及如何用理論依據來指導模型修改,而不是讓軟件牽著鼻子走。如果這本書能夠像一位資深的統計學傢在旁邊指導你進行模型審查,指齣那些常見的誤區和過度擬閤的誘惑,那麼它的價值就遠超一般教材瞭。我需要的是一種對模型穩健性的“哲學”層麵的思考,而不僅僅是技術層麵的堆砌。
评分這本關於結構方程模型的書,從書名來看,似乎是想深入探討如何對結構方程模型進行穩健的“測試”。對於一個剛接觸或正在努力掌握SEM的讀者來說,這本書的標題立刻吸引瞭我,因為它暗示瞭超越模型構建的實操層麵——驗證與診斷。我期待它能詳細剖析各種擬閤優度指標背後的統計學意義,以及何時應該相信它們,何時需要警惕。尤其是在麵對復雜模型,比如高階因子結構或多層數據時,如何係統性地進行敏感性分析和模型比較,是學術研究中的核心痛點。我希望作者能提供大量實際案例,展示如何一步步地識彆共綫性、處理缺失值對模型估計的影響,以及如何解讀那些“不太完美”的模型結果,而不是一味追求完美的P值和卡方值。一個好的測試指南應該教會讀者批判性地看待模型輸齣,理解統計假設的脆弱性,並提供實用的“補救”措施,而不是僅僅停留在介紹軟件操作層麵。總而言之,這本書的價值如果能體現在其深度和實戰性上,對於任何需要發錶SEM論文的研究者來說,都將是一筆寶貴的財富,因為它解決瞭“我的模型到底能不能用”這個最基本也最睏難的問題。
评分對於我這樣的實證研究者來說,最頭疼的不是建立模型,而是麵對“模型擬閤不佳”的審稿意見時如何有力地迴應。這本書如果能解決這個問題,那就是物超所值。我希望它能提供一套清晰的“故障排除手冊”:當RMSEA略高於0.08,但CFI接近1.0時,我應該如何嚮審稿人辯護?它是否會提供關於“實際顯著性”與“統計顯著性”之間界限的討論,尤其是在樣本量巨大的情況下?更進一步,我非常希望瞭解如何使用模型檢驗來支持或反駁不同的理論競爭模型(Competing Models)。這不僅僅是比較AIC/BIC,而是要展示一個更優模型在解釋數據變異性上的實質性進步。如果書中能強調理論驅動的重要性——即測試的最終目的是為瞭強化或修正理論,而不是僅僅為瞭得到一個“可接受”的P值——那麼這本書無疑將成為我書架上不可或缺的工具書。我期待它能賦予我足夠的統計洞察力,去捍衛我的模型選擇的閤理性。
评分 评分 评分 评分 评分相關圖書







本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有