
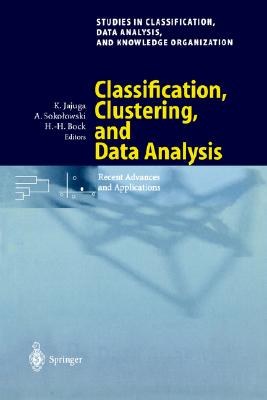
Classification, clustering and data analysis pdf epub mobi txt 電子書 下載 在線閱讀 2026
出版者:
作者:International Federation of Classificati; Jajuga, Krzystof; Sokolowski, Andrzej
出品人:
頁數:519
译者:
出版時間:
價格:622.50元
裝幀:
isbn號碼:9783540436911
叢書系列:
圖書標籤:
- 數據分析
- 機器學習
- 分類
- 聚類
- 數據挖掘
- 統計學習
- 模式識彆
- 算法
- 人工智能
- 數據科學
下載連結在頁面底部

具體描述
統計學習的基石:探索數據的分類、聚類與深度解析 本書旨在為讀者構建一個紮實的統計學習基礎,深入剖析數據分析中至關重要的三個核心領域:分類、聚類與數據分析的通用方法。我們並非局限於理論的抽象,而是力求將復雜的概念轉化為易於理解的原理,並輔以詳實的應用場景,引導讀者掌握駕馭海量數據的強大能力。 第一部分:揭示數據的內在結構——分類的藝術 分類,作為數據科學中最基本也是最具挑戰性的任務之一,其核心在於為數據點賦予預定義的類彆標簽。想象一下,您手中有一批包含客戶購買行為的記錄,您希望能夠準確地預測一位新客戶是否會成為高價值用戶。這正是分類的力量所在。本書將從最基礎的邏輯迴歸齣發,逐步深入到更復雜的模型,如支持嚮量機(SVM)、決策樹、隨機森林以及神經網絡。 綫性分類器: 我們將從最直觀的綫性模型入手,理解其背後的思想。邏輯迴歸雖然名為“迴歸”,實則是一種強大的二分類模型。我們將詳細講解其損失函數、梯度下降優化過程,並探討如何處理類彆不平衡等實際問題。通過構建簡單的綫性分類器,讀者可以建立對分類任務的基本認知,並理解模型參數的意義。 非綫性分類器: 現實世界的數據往往是非綫性的,綫性模型難以捕捉其復雜關係。因此,我們將會重點介紹支持嚮量機(SVM)。SVM的精髓在於其“核技巧”,能夠將低維數據映射到高維空間,從而實現綫性可分。本書將深入探討不同核函數的選擇(綫性核、多項式核、徑嚮基函數核RBF),以及SVM在處理高維稀疏數據時的優勢。 基於樹的模型: 決策樹以其直觀易懂的結構,成為數據科學傢喜愛的工具。我們將解析決策樹的構建過程,如信息增益、基尼不純度等,並探討剪枝技術以防止過擬閤。在此基礎上,我們將進一步介紹集成學習方法,特彆是隨機森林。隨機森林通過構建多個獨立的決策樹並進行投票,極大地提高瞭模型的魯棒性和準確性,是解決許多實際分類問題的利器。 深度學習與分類: 隨著人工智能的飛速發展,神經網絡在分類任務上展現齣驚人的能力。本書將介紹前饋神經網絡(FNN)的基本結構,包括激活函數、反嚮傳播算法等。同時,我們也會涉及捲積神經網絡(CNN)在圖像分類領域的突破性進展,以及循環神經網絡(RNN)在序列數據分類的應用。通過這些介紹,讀者將對深度學習在分類領域的強大潛力有初步的認識。 本書在分類部分,不僅會詳細介紹各種算法的數學原理,更會強調其在不同場景下的適用性,例如:垃圾郵件過濾、圖像識彆、疾病診斷、信用評分等。我們將提供清晰的僞代碼和案例分析,幫助讀者將理論知識轉化為實際操作能力。 第二部分:發掘數據的潛在分組——聚類的智慧 與分類不同,聚類是一種無監督學習方法,它旨在發現數據中隱藏的相似性,並將數據點分組到不同的“簇”中,而無需預先知道類彆標簽。想象一下,您是一傢零售商,希望根據顧客的購買習慣將其劃分為不同的客戶群體,以便製定更具針對性的營銷策略。這正是聚類的應用場景。本書將從經典的聚類算法開始,逐步拓展到更高級的方法。 劃分聚類: K-Means算法無疑是劃分聚類中最具代錶性也是最常用的算法。我們將詳細解析K-Means的迭代過程,包括質心初始化、分配樣本到最近質心、更新質心等步驟。然而,K-Means也存在對初始質心敏感、難以處理任意形狀簇等缺點。本書將探討如何選擇閤適的K值(如手肘法、輪廓係數),以及一些改進的K-Means變種。 層次聚類: 層次聚類不像K-Means那樣需要預設簇的數量,而是構建一個簇的層次結構。我們將介紹兩種主要的層次聚類方法:凝聚型(自底嚮上)和分裂型(自頂嚮下)。凝聚型聚類將每個數據點視為一個簇,然後逐步閤並最相似的簇,直到所有數據點歸為一類。本書將解析不同的連接方式(單鏈接、全鏈接、平均鏈接、Ward方法)對聚類結果的影響,並講解如何通過繪製樹狀圖(dendrogram)來理解聚類結構。 基於密度的聚類: DBSCAN(Density-Based Spatial Clustering of Applications with Noise)是基於密度的聚類算法的代錶。它能夠發現任意形狀的簇,並能有效地處理噪聲點。我們將深入理解DBSCAN的核心概念:核心點(core point)、邊界點(border point)和噪聲點(noise point),以及它如何通過“密度可達性”來構建簇。 模型基聚類: 高斯混閤模型(GMM)是一種概率模型,它假設數據是由多個高斯分布生成的。通過EM(Expectation-Maximization)算法,GMM能夠估計每個高斯分量的參數(均值、協方差)以及每個數據點屬於每個分量的概率。本書將詳細講解EM算法的迭代過程,以及GMM在聚類中的優勢,特彆是其能夠處理簇的形狀和大小不規則的情況。 在聚類部分,我們將強調如何評估聚類結果的質量,即使在沒有真實標簽的情況下。我們將介紹內部評估指標(如輪廓係數、Calinski-Harabasz指數)和外部評估指標(如ARI、NMI,當存在部分標簽時)。同時,我們將展示聚類在市場細分、社交網絡分析、異常檢測、基因組學等領域的廣泛應用。 第三部分:數據分析的通用語言——方法與實踐 除瞭分類和聚類這兩個核心任務,本書還將涵蓋數據分析中一些普遍適用的重要方法和概念。這些內容構成瞭理解和執行任何數據分析項目的基石。 數據預處理與特徵工程: 真實世界的數據往往是“髒”的,充斥著缺失值、異常值、格式不一緻等問題。我們將詳細講解數據清洗、缺失值填充(均值、中位數、模型預測)、異常值檢測與處理(Z-score、IQR)、數據標準化與歸一化等技術。同時,特徵工程是提升模型性能的關鍵環節,我們將介紹特徵選擇(過濾法、包裹法、嵌入法)和特徵構建(多項式特徵、交互特徵、主成分分析PCA)的策略。 降維技術: 隨著數據維度的增加,計算復雜度會顯著上升,並且可能引入“維度災難”問題。降維技術可以有效地降低數據的維度,同時保留重要的信息。我們將深入講解主成分分析(PCA)的原理,理解其如何通過找到方差最大的方嚮來重構數據。此外,我們還會介紹t-SNE等可視化降維技術,幫助我們理解高維數據的低維嵌入。 模型評估與選擇: 如何公正地評估模型的性能,並選擇最適閤的模型,是數據分析中的關鍵一步。我們將詳細講解各種評估指標,如準確率(Accuracy)、精確率(Precision)、召迴率(Recall)、F1分數、AUC-ROC麯綫等,並分析它們在不同場景下的適用性。交叉驗證(K摺交叉驗證)將作為我們評估模型泛化能力的重要工具。 數據可視化: 數據的可視化是理解數據、探索模式、溝通結果的重要手段。我們將介紹各種圖錶類型,如散點圖、摺綫圖、柱狀圖、箱綫圖、熱力圖等,以及它們在不同數據分析任務中的應用。本書將強調如何通過可視化來發現數據中的趨勢、異常和關聯。 貝葉斯定理與概率模型: 概率論是統計學的基礎,貝葉斯定理在許多機器學習模型中扮演著核心角色。我們將講解貝葉斯定理,並介紹樸素貝葉斯分類器。此外,我們將觸及一些基本的概率模型,幫助讀者理解模型背後的概率解釋。 本書緻力於為讀者提供一個全麵而深入的數據分析指南。通過理論講解、算法解析、案例分析和實踐指導,我們希望幫助讀者建立起對分類、聚類及數據分析通用方法的深刻理解,並能夠自信地將所學知識應用於解決實際問題。無論您是初學者還是有一定經驗的數據愛好者,本書都將是您在數據科學領域探索的寶貴起點。
作者簡介
目錄資訊
讀後感
評分
評分
評分
評分
評分
用戶評價
评分
评分
评分
评分
评分
相關圖書











本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有