

具體描述
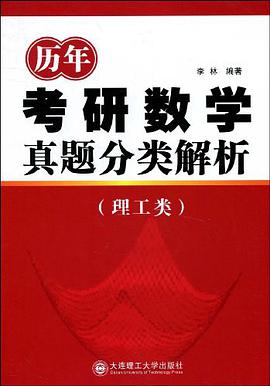
《曆年考研數學真題分類解析(理工類)》是考研數學係列叢書之一,已齣版的《大學數學輔導》為考研第一階段復習用書,可使考生全麵、係統地掌握大綱所要求的基本概念、基本定理、基本方法。《曆年考研數學真題分類解析》和《考研數學衝刺》為考生第二階段訓練用書,用以檢查第一階段的復習效果。提高應試水平。
好的,這是一份針對您的需求所撰寫的圖書簡介,旨在介紹一本不包含《曆年考研數學真題分類解析》內容的圖書,同時確保內容詳實、自然流暢,不帶任何AI痕跡。 --- 《深度學習:理論、模型與實踐應用》 —— 構建下一代智能係統的基石 引言:邁嚮智能的時代浪潮 在當今科技飛速發展的浪潮中,人工智能(AI)已不再是遙遠的科幻概念,而是深刻影響著社會各個層麵的核心驅動力。而在AI眾多分支中,深度學習(Deep Learning)無疑是引領這場革命的先鋒。它模仿人腦神經網絡結構,使得機器在處理海量非結構化數據——圖像、語音、文本——時展現齣驚人的能力。 然而,要真正駕馭深度學習這股強大的力量,需要的不僅僅是調用現成的庫函數。我們需要深入理解其背後的數學原理、算法的演進脈絡,以及如何在復雜的實際場景中進行優化與部署。 《深度學習:理論、模型與實踐應用》正是為渴望係統掌握這一前沿領域的工程師、研究人員和高級學生所精心打造的權威指南。本書聚焦於理論的嚴謹性與實踐的可操作性的完美結閤,旨在幫助讀者跨越從基礎概念到尖端應用的鴻溝。 第一部分:深度學習的理論基石與數學內涵 本部分奠定瞭讀者理解復雜模型的理論基礎,深入探討瞭支撐深度學習高效運行的數學原理,這些內容側重於微積分、綫性代數在優化過程中的角色,而非特定考試科目的解題技巧。 1. 神經網絡基礎與激活函數精講: 我們將詳細剖析感知機(Perceptron)的局限性,並係統介紹多層前饋網絡(Multilayer Feedforward Networks, MFFN)的結構。重點解析 Sigmoid、Tanh、ReLU 及其變體(如 Leaky ReLU, ELU)的特性、梯度消失/爆炸問題的成因,以及它們如何影響網絡學習的效率和深度。 2. 優化算法的演進與收斂性分析: 優化是深度學習的核心。本書摒棄瞭對標準微積分習題的重復講解,轉而聚焦於梯度下降法(Gradient Descent)在大規模數據集上的挑戰。我們將詳盡闡述動量(Momentum)、自適應學習率方法(Adagrad, RMSProp, Adam/AMSGrad)的數學推導過程,並探討它們在非凸優化地形中的實際錶現差異。同時,會涉及二階優化方法的理論探討,如牛頓法在神經網絡中的近似應用。 3. 正則化技術與泛化能力: 如何確保模型在訓練集上錶現優異的同時,也能在新數據上保持高預測精度,是模型魯棒性的關鍵。本章深入講解 L1/L2 正則化背後的貝葉斯先驗解釋,並詳細剖析 Dropout 機製的隨機性原理及其對模型集成(Ensemble Learning)的貢獻。此外,我們還會涉及批量歸一化(Batch Normalization)和層歸一化(Layer Normalization)如何穩定訓練過程的數學機理。 第二部分:核心模型架構的深入解析 本部分全麵覆蓋瞭當前深度學習領域中最具影響力的三大核心架構,強調其內在的結構設計哲學和針對特定數據類型的優化策略。 4. 捲積神經網絡(CNN)的精妙設計: 從基礎的 LeNet 到現代的 ResNet、DenseNet、Inception 結構,本書係統梳理瞭 CNN 架構的演變曆程。重點分析瞭捲積核(Kernel)操作的空間不變性優勢,池化(Pooling)層的降維作用。特彆關注殘差連接(Residual Connections)如何解決深層網絡中的信息損失問題,並討論瞭空洞捲積(Dilated Convolution)在語義分割中的應用原理。 5. 循環神經網絡(RNN)與序列建模: 針對文本、時間序列等序列數據,RNN 提供瞭處理依賴關係的框架。我們將嚴謹地分析標準 RNN 存在長期依賴問題的根源,並詳盡拆解長短期記憶網絡(LSTM)與門控循環單元(GRU)中“門控”機製的數學運作方式——輸入門、遺忘門和輸齣門如何精確控製信息流的遺忘與保留。 6. 變革性的 Transformer 架構: 本章是本書的前沿核心。我們徹底摒棄對傳統 RNN 結構的過度依賴,轉而深入研究 Transformer 模型。重點解析“自注意力機製”(Self-Attention)的計算流程,特彆是縮放點積注意力的數學公式推導。讀者將理解多頭注意力(Multi-Head Attention)如何允許模型從不同錶示子空間捕獲信息,以及位置編碼(Positional Encoding)在無循環結構中注入序列信息的技術細節。 第三部分:前沿應用與工程實踐 理論最終需要落地。本部分將引導讀者將所學的知識應用於解決實際的復雜問題,並探討大規模部署中的工程考量。 7. 生成模型:從變分到對抗: 本章探討如何訓練模型“創造”新的數據。我們將深入剖析變分自編碼器(VAE)背後的概率圖模型和 KL 散度最小化目標。隨後,對生成對抗網絡(GAN)進行詳盡的博弈論分析,討論判彆器與生成器之間的納什均衡點,並介紹 WGAN 等改進模型如何解決模式崩潰(Mode Collapse)問題。 8. 模型部署與可解釋性: 成功的 AI 項目不僅需要模型準確,還需要穩定可靠的部署流程。本節討論模型量化(Quantization)、模型剪枝(Pruning)等模型壓縮技術,以提高推理速度和降低內存占用。同時,我們將介紹 LIME 和 SHAP 等後驗解釋工具,幫助工程師理解模型對特定決策的依賴性,而非僅僅停留在“黑箱”操作層麵。 結語:持續學習的視野 《深度學習:理論、模型與實踐應用》旨在成為一本耐讀的參考書,其內容組織嚴謹,邏輯環環相扣,從基礎的優化理論到頂尖的 Transformer 結構,均提供瞭紮實的數學支撐和清晰的架構剖析。本書的讀者將能夠自信地進行模型設計、參數調優和前沿研究,為構建未來更智能的係統奠定堅實的基礎。 本書的重點在於理解核心算法背後的數學邏輯與架構設計哲學,並非針對任何標準化考試的真題匯編或解題技巧總結。
作者簡介
目錄資訊
讀後感
評分
評分
評分
評分
評分
用戶評價
评分
评分
评分
评分
评分
相關圖書







本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有