
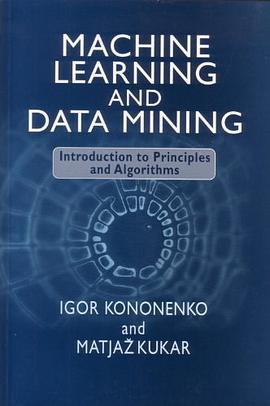
Machine Learning and Data Mining pdf epub mobi txt 电子书 下载 2026
- 机器学习
- 数据挖掘
- 机器学习
- 数据挖掘
- 人工智能
- 模式识别
- 数据分析
- 算法
- 统计学习
- Python
- R语言
- 大数据

具体描述
Data mining is often referred to by real-time users and software solutions providers as knowledge discovery in databases (KDD). Good data mining practice for business intelligence (the art of turning raw software into meaningful information) is demonstrated by the many new techniques and developments in the conversion of fresh scientific discovery into widely accessible software solutions. This book has been written as an introduction to the main issues associated with the basics of machine learning and the algorithms used in data mining. Suitable for advanced undergraduates and their tutors at postgraduate level in a wide area of computer science and technology topics as well as researchers looking to adapt various algorithms for particular data mining tasks. A valuable addition to the libraries and bookshelves of the many companies who are using the principles of data mining (or KDD) to effectively deliver solid business and industry solutions.
作者简介
目录信息
读后感
用户评价
我是在一个工作坊上被推荐阅读这本著作的,当时的环境是大家都在讨论如何构建一个鲁棒的推荐系统。那位分享经验的资深架构师特别强调了书中的数据降维部分,声称它彻底改变了他对高维稀疏数据处理的看法。阅读体验上,这本书最大的特点是其结构异常清晰的模块化设计。每一章都像一个独立的专题报告,逻辑链条完整且自洽。然而,这种清晰度在某些地方也带来了某种程度的局限性。比如,当我试图理解深度学习在自然语言处理(NLP)中的最新进展时,我发现这本书的焦点似乎更集中在传统的机器学习范式上。例如,它详细地对比了各种聚类算法的收敛速度和内存占用情况,这些知识点无疑是扎实的基石,但缺少了对Transformer架构、预训练模型这些当代热点内容的深度挖掘。书中引用的案例和数据集,虽然经典,但总感觉是几年前的“老朋友”,对于那些期待看到最前沿行业案例和SOTA(State-of-the-Art)模型表现的读者来说,可能会感到一丝时代的脱节。它更像是一部精心维护的“经典藏品”,而非紧跟市场脉搏的“最新期刊”。我期待看到更多关于如何利用GPU并行计算优化模型训练过程的讨论,但这方面的内容相对稀疏,留给读者的想象空间太大了。
评分这本书的排版和印刷质量绝对是业界顶尖水平,那种厚实的纸张和清晰的字体,拿在手里就有一种庄重感。我是一名刚毕业的硕士生,希望通过这本书系统地梳理我的知识体系。在学习回归分析和分类问题的辨析时,这本书做得非常出色,它用非常形象的比喻解释了偏差与方差的权衡,让我这个之前总是混淆不清的概念豁然开朗。然而,当我进入到无监督学习的部分时,我发现作者在讲解如DBSCAN这类空间聚类算法时,似乎过于依赖于图示的辅助,而文字描述上显得有些过于跳跃。我不得不频繁地翻阅附带的在线资源链接,才能完全掌握算法的边界条件处理细节。更让我感到困惑的是,书中对于“模型可解释性”(Explainable AI, XAI)的探讨非常简略,仅用了一小节来提及SHAP值和LIME方法,但没有深入剖析它们在不同模型间的适用性和局限性。在这个监管日益严格的时代,模型透明度已成为一项核心诉求,这本书对此的轻描淡写,使得其在指导实践应用时显得不够全面。它更侧重于“如何让模型工作”,而非“如何让模型被信任”。
评分作为一名资深的软件架构师,我经常需要向非技术背景的高层汇报项目可行性。我原以为这本书会提供一些关于如何将复杂模型封装成易于部署的API服务方面的见解,或者至少在“模型运维”(MLOps)的流程搭建上有足够的篇幅。事实是,这本书的讨论边界清晰地划定在了算法模型的构建和评估阶段。例如,在评估指标那一章,它详尽地列举了AUC、F1-Score、Precision/Recall的相互关系,并且给出了计算复杂度分析,这对于学术研究是极好的参考。但对于实际部署中常见的漂移检测(Drift Detection)、A/B测试框架下的模型对比等工程实践问题,全书基本没有涉猎。我花了大量时间在书中寻找关于大规模数据流处理如何融入机器学习管道的章节,但最终失望而归。这本书像一位专注于实验室研究的科学家,对走出实验室的“运输”和“应用”环节似乎兴趣不大。它在理论的深水区游刃有余,却对应用落地的泥泞小道有所回避,这对于需要全栈解决方案的读者来说,是一个明显的短板。
评分这本书的封面设计得非常引人注目,深邃的蓝色调配上银色的线条勾勒出的复杂网络结构,让人一眼就能感受到其内容的前沿性和技术深度。我最初是冲着作者在人工智能领域积累的声誉来的,毕竟他在学术界和工业界的双重背景,让人对这本书的理论严谨性和实践指导性抱有极高的期待。然而,在翻阅了前几章之后,我发现这本书的叙述方式似乎更偏向于一个高阶的理论综述,而非一本可以手把手教会入门者的教材。它花了大量篇幅去探讨一些非常底层的数学原理和统计学基础,虽然这些内容对于理解核心算法至关重要,但对于初学者来说,门槛可能过高。书中对经典算法如支持向量机(SVM)和决策树的阐述非常透彻,每一个公式的推导都力求详尽无遗,这无疑是为那些希望深入钻研技术细节的研究人员准备的饕餮盛宴。但遗憾的是,对于那些更侧重于快速应用和模型调优的工程师群体来说,这本书提供的“快速启动指南”较少,很多实际工程中会遇到的数据预处理和特征工程的“脏活累活”被一带而过,这使得我们在尝试将理论转化为实际产品时,总感觉缺少了那么一环关键的桥梁。整体而言,这是一部需要静下心来,泡上一壶好茶,才能慢慢品味的学术著作,而不是一本可以随时放在手边快速查阅的工具书。
评分我对这本书的阅读体验可以说是“爱恨交织”。它的理论深度是毋庸置疑的,特别是对概率图模型(Probabilistic Graphical Models)那一章的论述,几乎达到了教科书级别的严谨性。作者对贝叶斯网络的推理过程的剖析,让我对概率论在机器学习中的应用有了更深刻的理解,这绝对是值得称赞的亮点。然而,这本书的“个性”也十分鲜明,它似乎对某些领域抱有强烈的个人偏好。例如,在强化学习(Reinforcement Learning, RL)部分,内容相对薄弱,对Q-Learning和Policy Gradient的基础描述相对仓促,而对于近期大火的Actor-Critic方法及其变体,则几乎没有提及,这让期待了解前沿决策智能的读者感到意犹未尽。此外,书中缺乏对特定编程语言(如Python/R)代码实现的直接嵌入,虽然作者可能认为代码实现会干扰纯粹的理论探讨,但对于希望立即动手验证公式的读者来说,这无疑增加了他们自行编写和调试代码的工作量。这本书的价值在于提供了一个坚实的理论框架,但如果你希望它能成为你实现自动化机器学习(AutoML)蓝图的全部指南,那你可能需要再添置几本更侧重实践和代码的参考书了。
评分General...扫盲专用
评分10/11章不错
评分10/11章不错
评分General...扫盲专用
评分General...扫盲专用
相关图书






本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有