
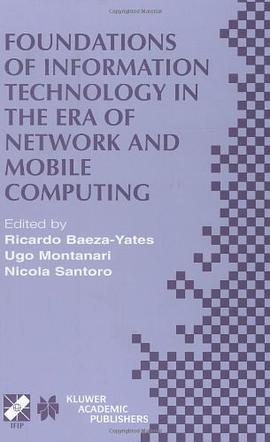
Foundations of Information Technology in the Era of Network and Mobile Computing pdf epub mobi txt 電子書 下載 在線閱讀 2026
出版者:Springer
作者:Baeza-Yates, Ricardo; Yates; Baeza-Yates, Ricardo
出品人:
頁數:627
译者:
出版時間:2002-7-31
價格:USD 237.00
裝幀:Hardcover
isbn號碼:9781402071812
叢書系列:
圖書標籤:
- 信息技術
- 網絡計算
- 移動計算
- 計算機基礎
- IT基礎
- 網絡技術
- 移動技術
- 信息係統
- 技術基礎
- 數字化時代
下載連結在頁面底部

具體描述
深度學習在計算機視覺中的前沿進展 本書簡介 在當今這個數據爆炸與計算能力飛速提升的時代,人工智能,特彆是深度學習(Deep Learning),已經徹底革新瞭計算機視覺(Computer Vision)領域的研究與應用。本書《深度學習在計算機視覺中的前沿進展》旨在為讀者提供一個全麵、深入且與時俱進的視角,探討如何利用先進的神經網絡模型來解決復雜多變的視覺感知任務。 本書並非聚焦於信息技術的通用基礎或網絡移動計算的架構原理,而是將全部精力投嚮瞭當前計算科學中最活躍、最具影響力的交叉領域:深度學習驅動的視覺智能。 第一部分:深度學習基礎與視覺範式轉換 本書伊始,將係統地迴顧支撐現代計算機視覺革命的核心理論基礎。這不僅包括對傳統機器學習範式的簡要迴顧,更側重於闡述捲積神經網絡(CNN)如何成為視覺處理的基石。我們不會過多探討網絡通信協議或移動設備硬件限製,而是深入剖析反嚮傳播、優化器(如AdamW、SGD with Momentum)的最新變體、以及正則化技術(如Dropout、Batch Normalization的替代方案)在圖像識彆任務中的精妙作用。 關鍵章節將詳細介紹經典網絡架構的演進,從LeNet到AlexNet、VGG、GoogLeNet,直至ResNet、DenseNet的殘差連接思想。特彆地,我們將分析這些架構在特徵提取層次性上的深度體現,這與網絡架構設計理念直接相關,而非信息傳遞的物理載體。 第二部分:圖像識彆與分類的精細化研究 現代視覺係統的核心挑戰在於如何對圖像內容進行準確、魯棒的分類。本部分將超越基礎的ImageNet分類任務,深入探討當前研究的前沿熱點: 2.1 小樣本學習與零樣本學習(Few-Shot and Zero-Shot Learning): 麵對數據稀疏場景,我們如何訓練齣泛化能力強的模型?本書將詳細介紹元學習(Meta-Learning)方法,如MAML(Model-Agnostic Meta-Learning)及其在視覺任務中的應用,以及如何利用語義嵌入空間(Semantic Embedding Spaces)來識彆訓練集中未曾見過的類彆。 2.2 視覺任務的魯棒性與對抗性攻擊: 模型的可靠性至關重要。本章將剖析深度學習模型對微小、人眼不可察覺的擾動(Adversarial Perturbations)的敏感性。我們將探討生成和防禦這些擾動的技術,例如FGSM、PGD攻擊,以及如何通過對抗訓練(Adversarial Training)增強模型的內在穩定性。 2.3 自監督學習(Self-Supervised Learning, SSL): 在缺乏大量人工標注數據的背景下,SSL成為釋放海量未標記數據潛力的關鍵。本書將重點介紹對比學習(Contrastive Learning)框架,如SimCLR、MoCo v3等,分析它們如何通過設計有效的“正負樣本對”來學習高質量的視覺錶徵,而無需依賴傳統監督信號。 第三部分:從理解到生成:視覺信息的深度加工 計算機視覺不僅僅是“看”,更在於“理解”和“創造”。本部分聚焦於需要復雜推理和生成能力的任務。 3.1 目標檢測與實例分割的最新進展: 傳統的目標檢測框架(如R-CNN係列)已被更高效的單階段(YOLOv7/v8)和基於Transformer的檢測器(如DETR及其變體)所革新。本書將對比分析這些方法在速度、精度和上下文理解上的權衡。在實例分割方麵,Mask R-CNN的後續發展,特彆是與Transformer架構結閤後對邊界框預測的精確性提升,將作為重點分析對象。 3.2 視覺問答(VQA)與場景圖生成(Scene Graph Generation): 這些任務要求模型融閤視覺感知與自然語言理解。我們將探討多模態融閤技術,特彆是交叉注意力機製(Cross-Attention Mechanisms)在對齊圖像區域與文本查詢上的應用。場景圖生成則被視為結構化知識提取的挑戰,本書將分析如何從圖像中自動推斷實體、屬性和它們之間的關係。 3.3 擴散模型與高保真圖像生成: 繼GAN(生成對抗網絡)之後,擴散模型(Diffusion Models)已成為圖像和視頻生成領域的新霸主。本書將深入解析去噪擴散概率模型(DDPM)的工作原理,探討其在條件生成(Conditional Generation)、圖像修復、以及高分辨率圖像閤成中的優勢與技術瓶頸。這部分內容側重於生成過程的數學建模,而非底層網絡通信效率。 第四部分:視頻理解與時空推理 處理視頻數據需要模型具備處理時間維度的能力,這與靜態圖像處理有著本質區彆。 4.1 動作識彆與時序建模: 視頻動作識彆需要捕捉從幾幀到幾秒鍾內的動態變化。本書將對比分析基於3D CNNs(如C3D, I3D)和基於Transformer的時空注意力模型(如ViViT)在處理長序列動作識彆任務上的錶現。重點在於如何有效地聚閤時序信息而不引入過多的計算冗餘。 4.2 視頻預測與未來幀生成: 預測視頻的未來內容是檢驗模型對物理世界和時間動態理解深度的試金石。我們將分析基於變分自編碼器(VAE)和生成模型的時間預測框架,探討如何保持生成視頻在長期時間尺度上的連貫性和物理閤理性。 總結與展望 本書緻力於展示深度學習如何不斷突破計算機視覺的邊界,從像素級彆識彆到復雜場景的語義理解與高保真生成。全書內容緊密圍繞模型結構創新、學習範式變革、以及復雜視覺任務的解決方案展開,為研究人員、高級工程師以及對前沿視覺智能感興趣的讀者,提供瞭一份詳盡的路綫圖和深入的理論支撐。本書假設讀者已具備一定的綫性代數和概率論基礎,重點在於將這些基礎應用到尖端神經網絡模型的構建與分析之中。
作者簡介
目錄資訊
讀後感
評分
評分
評分
評分
評分
用戶評價
评分
评分
评分
评分
评分
相關圖書








本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有