
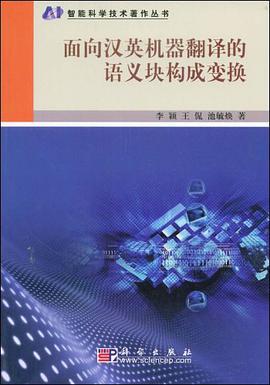

具体描述
《面向汉英机器翻译的语义块构成变换》针对当前机器翻译准确率存在的两大难点(自然语言理解处理和过渡处理),在HNC理论框架下阐释了机器翻译引擎原理,第一次对其中的关键之处:语义块构成变换进行了全面、系统、深入的阐述,给出了具体的饵决方案,制定了统摄具体规则的一系列原则。《面向汉英机器翻译的语义块构成变换》内容可应用于语言信息处理、机器翻译及语言分析。
《面向汉英机器翻译的语义块构成变换》适合于机器翻译、自然语言理解与处理、人工智能等智能信息处理专业领域的研究者、开发者和学习者参考阅读。
作者简介
目录信息
读后感
用户评价
这本书的阅读体验,说实话,是具有挑战性的,但也是令人振奋的。我是在一个相对繁忙的项目间隙接触到它的,最初几页确实有些“劝退”。那些大量的符号表示和严谨的逻辑推导,如果没有一定的背景知识支撑,很容易让人迷失方向。特别是关于“依存关系结构到功能角色映射”那一章节,作者似乎默认读者已经完全熟悉了某些前沿的符号逻辑体系。我花了将近一个周末的时间,才勉强跟上他的论证节奏。但一旦跨过了这个门槛,你会发现作者构建的那个“语义块”框架,简直像一个精密的瑞士钟表。它不是那种粗暴地将句子切开再重组的方法,而更像是对信息流进行了一种高度压缩和重构。我尤其喜欢作者在探讨如何处理那些“隐性信息”时的论述,比如上下文中的指代消解或者情感色彩的微妙传递,这些恰恰是当前许多大型预训练模型仍然处理不好的部分。这本书提供了一种可以被明确定义和操作的中间表示层,这对于追求可解释性和可控性的研究者来说,无疑是久旱逢甘霖。它让人意识到,深度学习的“黑箱”固然强大,但对底层语义结构的深入理解和建模,才是确保翻译质量稳步提升的基石。
评分这本书的装帧和印刷质量堪称一流,纸张的质地很好,长时间阅读眼睛也不会感到太累,这对于一本技术性如此强的著作来说,无疑是一种贴心的设计。从内容上看,作者的行文风格非常具有学者的严谨性,每一个论断都有坚实的理论或实验数据作为后盾,没有丝毫夸张或迎合市场的意思。我之所以会一直读下去,是因为它触及了我工作中一个长期困扰我的实际问题:如何有效地整合外部知识库到翻译流程中。书中专门有一章详细讨论了如何将“实体关系图谱”中的信息,通过语义块的边界识别,无缝嵌入到翻译的中间表示层。这比当前许多尝试将知识图谱与Transformer架构生硬结合的方法要优雅得多。作者的思路是先“理解知识的结构”,再“映射到语言结构”,而不是反过来。这是一种自上而下的构建思路,显得非常宏大且富有远见。虽然在某些关于高性能计算实现上的讨论略显不足,但就理论框架的完备性和逻辑的自洽性而言,这本书达到了极高的水准。
评分这本书的封面设计得非常朴实,没有过多的花哨元素,这反而让它在众多出版物中显得尤为沉稳。我之所以会选择它,完全是出于对特定技术方向的好奇心。我原本以为它会是一本纯理论的探讨,更多的是关于形式语言学或者句法树的枯燥分析,但翻开第一章,我立刻被作者那种从实际应用场景出发的叙事方式所吸引。他并没有直接跳入复杂的数学模型,而是先用几个非常直观的例子,勾勒出了传统基于规则和短语结构的方法在处理跨语言信息传递时的那些“痛点”。比如,在英汉互译中,主谓宾的语序颠倒,以及不同语言中对“信息焦点”的不同处理方式。作者的笔触非常细腻,他似乎懂得如何将晦涩的计算机科学概念,用一种接近于哲学思辨的方式来阐述,让人在阅读时,总有一种“原来还可以这样看问题”的豁然开朗感。尽管我对计算语言学有一定基础,但书中关于“语义单元的边界确定”那部分,依然让我不得不停下来反复咀嚼。它不是那种读完就能立刻写出代码的工具书,更像是一份深入骨髓的思维导图,指引着研究者去重新审视机器翻译的核心难题——如何真正捕获“意义”,而不是仅仅对齐词汇。我欣赏这种脚踏实地的理论构建,它没有沉溺于时髦的模型迭代,而是回归了语言的本质。
评分我必须承认,这本书的学术密度非常高,几乎是每一页都充满了需要查阅或深思的内容。它不是那种适合在通勤路上消遣的读物。我是在一个安静的午后,泡了一壶浓茶,准备了足够的空白笔记本,才敢于真正“攻读”它。作者在引言中就明确指出,他试图解决的是现有基于序列到序列模型的“局部最优陷阱”问题。他通过建立一个介于纯句法分析和最终目标语生成之间的“信息枢纽”,来规避长距离依赖的错误累积。我最感兴趣的是其中关于“跨语言信息冗余消除”的部分。在从源语言向目标语言转换的过程中,往往会因为语言结构差异,导致不必要的重复表达或信息的丢失。这本书提供了一种基于信息熵和主题一致性的切割标准,这使得翻译过程更像是“信息提纯”而非简单的“文本替换”。虽然书中对某些核心算法的描述非常概括,留下了大量的推导细节给读者自己去补足,但这反而激发了我的研究热情——它不是给出了一个终极答案,而是提供了一个极其扎实的工具箱和一套看待问题的全新视角。
评分我最近几年一直在关注不同机器翻译范式的演变,从早期的基于实例到统计机器翻译,再到如今的神经机器翻译,每一种范式都有其时代的局限性。这本书的出现,仿佛是为当前这种高度依赖大规模语料的“黑箱”翻译方式提供了一个深刻的反思。作者的论述结构非常清晰,他并没有全盘否定当前的深度学习方法,而是巧妙地将其视为实现“语义块聚合”和“结构重组”的强力工具。他所描绘的这种基于语义块的翻译模型,似乎提供了一条绕过上下文窗口限制,实现更稳定、更长距离语义保持的路径。我特别欣赏作者在讨论“跨文化语境的语义对齐”时所展现出的语言学洞察力。这不仅仅是技术层面的比拼,更是对人类交流本质的深刻理解。阅读这本书,就像是跟随一位经验丰富的向导,深入了一片充满挑战但也极具宝藏的知识密林。它对那些不满足于现有系统性能瓶颈,渴望从底层原理上进行突破的研究人员,无疑是一部必读的里程碑式的著作。
评分 评分 评分 评分 评分相关图书







本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有