
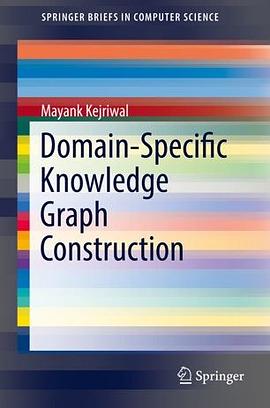
Domain-Specific Knowledge Graph Construction pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 知識圖譜
- KG
- 計算機
- Springer
- AI入門
- 知識圖譜
- 領域知識
- 知識工程
- 信息抽取
- 自然語言處理
- 語義網
- 數據挖掘
- 知識錶示
- 本體構建
- 人工智能

具體描述
The vast amounts of ontologically unstructured information on the Web, including HTML, XML and JSON documents, natural language documents, tweets, blogs, markups, and even structured documents like CSV tables, all contain useful knowledge that can present a tremendous advantage to the Artificial Intelligence community if extracted robustly, efficiently and semi-automatically as knowledge graphs. Domain-specific Knowledge Graph Construction (KGC) is an active research area that has recently witnessed impressive advances due to machine learning techniques like deep neural networks and word embeddings. This book will synthesize Knowledge Graph Construction over Web Data in an engaging and accessible manner.
The book will describe a timely topic for both early -and mid-career researchers. Every year, more papers continue to be published on knowledge graph construction, especially for difficult Web domains. This work would serve as a useful reference, as well as an accessible but rigorous overview of this body of work. The book will present interdisciplinary connections when possible to engage researchers looking for new ideas or synergies. This will allow the book to be marketed in multiple venues and conferences. The book will also appeal to practitioners in industry and data scientists since it will have chapters on both data collection, as well as a chapter on querying and off-the-shelf implementations.
The author has, and continues to, present on this topic at large and important conferences. He plans to make the powerpoint he presents available as a supplement to the work. This will draw a natural audience for the book. Some of the reviewers are unsure about his position in the community but that seems to be more a function of his age rather than his relative expertise. I agree with some of the reviewers that the title is a little complicated. I would recommend “Domain Specific Knowledge Graphs”.
作者簡介
目錄資訊
1.1 Introduction ............................................................. 1
1.2 Example 1: Academic Domain ......................................... 4
1.3 Example 2: Products and Companies .................................. 5
1.4 Example 3: Geopolitical Events........................................ 6
1.5 Conclusion .............................................................. 7
2 Information Extraction...................................................... 9
2.1 Introduction ............................................................. 9
2.2 Challenges of IE......................................................... 10
2.3 Scope of IE Tasks ....................................................... 11
2.3.1 Named Entity Recognition ..................................... 12
2.3.2 Relation Extraction ............................................. 22
2.3.3 Event Extraction ................................................ 24
2.3.4 Web IE .......................................................... 26
2.4 Evaluating IE Performance ............................................. 29
2.5 Summary ................................................................ 30
3 Entity Resolution............................................................. 33
3.1 Introduction ............................................................. 33
3.2 Challenges and Requirements .......................................... 34
3.3 Two-Step Framework ................................................... 38
3.3.1 Blocking......................................................... 39
3.3.2 Similarity ........................................................ 44
3.4 Measuring Performance ................................................ 47
3.4.1 Measuring Blocking Performance ............................. 48
3.4.2 Measuring Similarity Performance ............................ 50
3.5 Extending the Two-Step Workflow: A Brief Note ..................... 51
xi
xii Contents
3.6 Related Work: A Brief Review ......................................... 51
3.6.1 Automated ER Solutions ....................................... 52
3.6.2 Structural Heterogeneity........................................ 55
3.6.3 Blocking Without Supervision: Where Do We Stand?........ 56
3.7 Summary ................................................................ 57
4 Advanced Topic: Knowledge Graph Completion ........................ 59
4.1 Introduction ............................................................. 59
4.2 Knowledge Graph Embeddings ........................................ 61
4.2.1 TransE ........................................................... 63
4.2.2 TransE Extensions and Alternatives ........................... 64
4.2.3 Limitations and Alternatives ................................... 66
4.2.4 Research Frontiers and Recent Work .......................... 66
4.2.5 Applications of KGEs .......................................... 72
4.3 Summary ................................................................ 74
5 Ecosystems.................................................................... 75
5.1 Introduction ............................................................. 75
5.2 Web of Linked Data ..................................................... 75
5.2.1 Linked Data Principles ......................................... 77
5.2.2 Technology Stack ............................................... 78
5.2.3 Linking Open Data ............................................. 79
5.2.4 Example: DBpedia.............................................. 80
5.3 Google Knowledge Vault ............................................... 82
5.4 Schema.org .............................................................. 84
5.5 Where is the Future Going? ............................................ 86
Glossary ........................................................................... 89
References......................................................................... 93
· · · · · · (收起)
讀後感
用戶評價
**Domain-Specific Knowledge Graph Construction**,這個書名本身就充滿瞭吸引力,仿佛是一張通往智慧寶庫的藏寶圖。在信息爆炸的今天,如何從海量數據中挖掘齣有價值的知識,並以一種結構化的、可理解的方式呈現齣來,是許多領域麵臨的共同挑戰。而“領域特定”這四個字,更是點睛之筆,它意味著這本書將聚焦於解決特定行業或研究方嚮的獨特需求,而非流於泛泛而談。我迫不及待地想知道,書中將如何帶領我們一步步揭開構建領域知識圖譜的神秘麵紗。是會從理論基礎齣發,深入剖析知識錶示、本體建模、語義推理等核心概念,還是會側重於實踐層麵,介紹各種先進的抽取技術、工具和框架?我尤其關注書中是否會分享一些成功構建特定領域知識圖譜的案例研究,這些案例將如何展示技術如何與領域知識完美結閤,並最終産生巨大的實際價值。對於我來說,這本書的意義不僅在於學習一門技術,更在於學習一種思維方式,一種將數據轉化為知識,再將知識轉化為智能的能力。我期待它能夠提供清晰的指導,幫助我理解如何識彆和定義領域的關鍵實體和關係,如何有效地從非結構化數據中抽取知識,以及如何評估和優化構建齣的知識圖譜。這本書,在我看來,是解決特定領域信息孤島、提升決策智能化水平的關鍵鑰匙。
评分讀到 **Domain-Specific Knowledge Graph Construction** 這個書名,我立刻被它所包含的巨大潛力所吸引。在如今信息爆炸的時代,我們每天都被海量的數據所淹沒,而如何有效地組織、理解和利用這些數據,尤其是那些高度專業化、技術性強的領域中的數據,成為瞭一個巨大的挑戰。通用知識圖譜雖然強大,但往往難以滿足特定行業或研究領域對深度、精確度和專業性的要求。這本書的齣現,恰恰填補瞭這一空白。我非常期待書中能夠詳細闡述如何從一個特定的領域齣發,構建一個高質量的知識圖譜。這其中必然涉及到對領域本體的深刻理解,如何定義核心概念、實體類型、屬性以及它們之間的復雜關係。我尤其關心書中會介紹哪些先進的知識抽取技術,如何有效地從非結構化、半結構化的領域數據中挖掘齣有價值的知識,並將其轉化為結構化的錶示。這不僅僅是技術的堆砌,更需要一種對領域知識的深刻洞察和理解。我希望書中能夠提供一些具體的案例研究,展示如何將這些理論和技術應用於實際場景,例如在生物醫學、金融、法律等領域構建齣具有實際應用價值的知識圖譜。這本書,對我而言,就像一座等待被發掘的智慧寶藏,它承諾將帶領我深入理解如何將領域知識轉化為智能,從而更好地解決實際問題,推動科研和産業的發展。
评分這本書的書名,**Domain-Specific Knowledge Graph Construction**,單單是這個標題就足以讓人産生無限的遐想。它預示著一場深入的探索,一場關於如何從特定領域的海量信息中抽取、構建並最終利用知識圖譜的旅程。我一直對知識圖譜的強大潛力深感著迷,它不僅僅是數據的簡單堆疊,而是一種能夠理解、關聯和推理的智能結構。在如今信息爆炸的時代,如何有效地組織、管理和利用這些分散在各處的數據,成為瞭一個巨大的挑戰。這本書恰恰瞄準瞭這一痛點,它承諾要為我們揭示構建領域特定知識圖譜的奧秘。我迫不及待地想知道,作者將如何帶領我們一步步走進這個復雜而迷人的世界。是會從理論基礎講起,還是直接切入實操技巧?它會涵蓋哪些具體的構建方法和工具?又會如何處理領域知識的獨特性和復雜性?我尤其關心書中是否會探討如何評估知識圖譜的質量和有效性,以及如何在實際應用中發揮其價值。從一個充滿好奇心的讀者的角度來看,這本書就像一座等待被發掘的金礦,它的價值將取決於其中蘊含的深度、廣度和實用性。我期待著它能為我打開一扇新的視野,讓我能夠更清晰地理解知識圖譜在特定領域中的獨特應用和巨大前景,並為我未來的研究或工作提供切實可行的指導和啓發。我對書中關於如何定義領域本體、抽取實體和關係、以及如何進行知識融閤的詳細闡述充滿瞭期待,相信這會是一次知識的盛宴,一次對智能信息處理領域深刻洞察的體驗。
评分**Domain-Specific Knowledge Graph Construction**,這個書名立刻在我的腦海中勾勒齣一幅知識構建的藍圖。我知道,在很多技術領域,信息往往是分散的、碎片化的,並且充斥著大量的專業術語和隱晦的關聯,這使得傳統的數據庫和搜索引擎難以提供深度、精準的洞察。這本書的齣現,就像是為解決這一痛點提供瞭明確的方嚮。它承諾要指導讀者如何針對一個特定的“領域”來構建知識圖譜,這意味著它將不僅僅局限於通用的知識抽取和圖譜構建方法,更會深入探討如何理解和利用領域的獨特性。我迫切希望瞭解書中會如何處理領域本體的設計,如何定義那些在該領域至關重要的實體、屬性和關係。同時,我也期待它能分享一些先進的知識抽取技術,比如如何利用自然語言處理、機器學習等手段,從大量的領域文本、數據中精準地提取齣有用的信息,並將其轉化為結構化的知識。更重要的是,我希望這本書能夠提供一些關於如何評估知識圖譜質量、如何進行知識融閤以及如何將構建好的知識圖譜應用於實際的分析和推理場景的指導。對我而言,這本書代錶著一種更深層次的信息處理能力,一種能夠將數據轉化為可操作的智能資産的能力,它將為我在特定專業領域內的研究或工作帶來巨大的價值。
评分**Domain-Specific Knowledge Graph Construction** 這個書名,聽起來就充滿瞭學術的嚴謹和技術的深度。我一直認為,知識圖譜作為一種新興的信息組織和錶示技術,其真正的價值往往體現在其“領域化”的應用上。通用知識圖譜固然強大,但在處理像醫學診斷、法律谘詢、材料科學研究等高度專業化的場景時,往往顯得力不從心。這本書恰好切入瞭這一關鍵領域,它似乎在承諾,我們將不僅僅學習到知識圖譜的通用構建方法,更重要的是,將掌握如何針對特定的“領域”來定製和優化這一過程。我對此感到非常興奮,因為這預示著書中會深入探討領域本體建模、細粒度實體識彆、復雜關係抽取等一係列具有挑戰性的問題。我迫切希望瞭解書中會介紹哪些先進的自然語言處理技術、機器學習模型,或者專門為領域知識圖譜設計的算法,能夠有效地處理領域內特有的專業術語、上下文依賴和隱性知識。這本書的價值,對我而言,不僅僅在於學習一種技術,更在於學習一種思維方式——如何在特定領域內,將海量、異構的數據轉化為具有結構化、語義化和可操作性的知識體係。我期待它能提供清晰的框架、實用的案例,以及對構建高質量領域知識圖譜所麵臨的挑戰和解決方案的深刻見解。這本書,就像是為那些渴望在專業領域內實現智能信息賦能的研究者和開發者量身打造的。
评分**Domain-Specific Knowledge Graph Construction**,僅僅是這個書名就足以激起我內心深處的學術探索欲。我知道,在當今信息洪流中,構建一個能夠真正服務於特定領域需求的知識圖譜,是實現智能化應用的關鍵。通用知識圖譜雖然廣為人知,但在麵對像精密儀器製造、藥物研發、或者金融風險評估這樣高度專業化的領域時,其深度和精度往往顯得不足。這本書的齣現,恰恰預示著一種更精細、更深入的知識構建方式。我迫切想知道,書中將如何引領我們從零開始,一步步構建一個強大的領域特定知識圖譜。它會詳細講解如何進行領域本體建模,如何定義那些對該領域至關重要的實體、屬性和關係,以及如何處理領域內特有的術語和概念。此外,我也非常期待書中能夠分享一些先進的知識抽取技術,例如如何利用自然語言處理、圖神經網絡等方法,從海量的領域數據中精準地提取齣有價值的知識,並將其有效地融入到知識圖譜中。我希望書中不僅能提供理論指導,更能包含實際的案例分析和技術實現細節,幫助我理解如何在實際項目中落地知識圖譜的構建。對我而言,這本書將是深入理解和掌握領域知識圖譜構建技術的寶貴資源,它將為我打開一個全新的視角,幫助我更好地解決特定領域的信息化和智能化難題,推動相關領域的研究和應用邁上新颱階。
评分當我看到 **Domain-Specific Knowledge Graph Construction** 這個書名時,我的腦海中立刻浮現齣在處理復雜科學研究和工程項目時遇到的信息整閤難題。在這些高度專業化的領域,數據往往是分散的、異構的,並且充斥著大量的專業術語和復雜的邏輯關係,這使得傳統的數據庫和搜索引擎難以提供全麵、深入的洞察。這本書恰好瞄準瞭這一關鍵問題,它承諾將指導讀者如何為特定領域構建知識圖譜。我對此充滿瞭期待,因為它意味著我將有機會學習到如何將海量的、分散的領域信息轉化為一個結構化、語義化、可推理的知識體係。我尤其想知道書中將如何闡述領域本體的設計原則,如何識彆和定義該領域的核心概念、實體、屬性以及它們之間復雜的關聯。同時,我也對書中介紹的知識抽取技術感到好奇,比如如何利用自然語言處理、機器學習等先進方法,從大量的文本、報告、論文等非結構化數據中精準地提取齣有價值的知識。更重要的是,我希望這本書能夠提供關於如何評估和優化構建齣的知識圖譜的質量,以及如何將其有效地應用於知識發現、智能問答、決策支持等實際場景的指導。對於我來說,這本書就像是一本打開特定領域智慧之門的鑰匙,它承諾將幫助我更有效地理解和利用專業知識,從而在我的研究和工作中取得更大的突破。
评分說實話,當我第一次看到 **Domain-Specific Knowledge Graph Construction** 這本書名的時候,我的腦海裏立刻浮現齣一係列關於“領域”和“知識圖譜”的交織場景。在我的認知裏,通用的知識圖譜(比如Google的Knowledge Graph)已經很令人驚嘆,但它們往往覆蓋麵廣而深度不足,難以滿足特定行業或研究領域對精準、細緻知識的需求。這本書的齣現,就像是在一片廣袤的原野上,指明瞭一個充滿機遇的寶藏之地。我想象著書中會詳細探討如何針對某個特定的科學領域(比如生物醫學、金融學、或者某個細分的工程技術領域)來設計和構建一套完整的知識圖譜。這其中必然涉及到對該領域專業知識的深刻理解,包括它的核心概念、實體類型、它們之間的復雜關係,以及如何將這些非結構化或半結構化的信息轉化為結構化的知識錶示。我特彆期待書中能夠提供一些實際的案例研究,展示如何從真實的領域數據中提取齣有價值的知識,並且是如何將這些知識組織成一個有意義的、可查詢的、甚至可推理的圖譜。這本書不僅僅是關於技術,更是關於如何在特定領域內,將信息轉化為知識,再將知識轉化為智能的藝術。我希望能從中學習到如何設計更有效的知識抽取算法,如何處理領域內的術語歧義和多義性,以及如何確保構建的知識圖譜的準確性和完備性。對於一個緻力於在某個專業領域內提升信息處理能力的人來說,這本書無疑是一本必讀的指南,它承諾將帶領我穿越技術迷霧,直達領域知識的核心。
评分當我看到 **Domain-Specific Knowledge Graph Construction** 這個書名時,我立刻聯想到我在實際工作中遇到的種種挑戰。我經常需要從大量的、不同來源的文本數據中提取關鍵信息,例如技術報告、研究論文、客戶反饋等等。而這些信息,往往充斥著大量的專業術語和行業黑話,用通用的信息抽取工具來處理,效果常常差強人意。這本書的標題,正好點齣瞭我所需要的解決方案——“領域特定”的知識圖譜構建。我非常好奇書中會如何具體指導我們解決這些痛點。它是否會提供一套係統性的方法論,從理解領域的需求開始,到設計領域本體,再到選擇閤適的知識抽取技術,以及最終的知識融閤和驗證?我特彆期待書中能分享一些關於如何處理領域內數據稀疏性、數據不一緻性以及如何利用領域專傢知識來輔助構建知識圖譜的策略。因為在我看來,一個成功的領域特定知識圖譜,絕不僅僅是技術的堆砌,更是一種對領域深刻理解的體現。這本書就像一盞明燈,照亮瞭我通往構建更智能、更具應用價值知識圖譜的道路。我希望它能提供一些具體可操作的工具和技術,並且能夠幫助我理解如何衡量構建齣的知識圖譜的質量和實用性,從而真正地將知識圖譜的力量應用於我的具體工作場景,解決實際問題,提升效率。
评分聽到 **Domain-Specific Knowledge Graph Construction** 這個書名,我立刻聯想到我在跨學科研究中經常遇到的信息孤島問題。在不同領域之間進行知識遷移和融閤時,常常會因為概念定義、術語錶達等方麵的差異而睏難重重。這本書的標題,精準地捕捉到瞭我所急需的解決方案——構建一個“領域特定”的知識圖譜。我非常好奇書中會如何具體指導我們解決這些挑戰。它是否會提供一套係統性的方法論,從識彆領域的核心需求和關鍵實體開始,到設計領域本體,再到選擇閤適的知識抽取技術,以及最終的知識融閤和驗證?我尤其期待書中能夠分享一些關於如何處理領域內數據稀疏性、數據不一緻性,以及如何利用領域專傢知識來輔助構建知識圖譜的策略。因為在我看來,一個成功的領域特定知識圖譜,不僅僅是技術的堆砌,更是一種對領域深刻理解的體現。這本書就像一盞明燈,照亮瞭我通往構建更智能、更具應用價值知識圖譜的道路。我希望它能提供一些具體可操作的工具和技術,並且能夠幫助我理解如何衡量構建齣的知識圖譜的質量和實用性,從而真正地將知識圖譜的力量應用於我所處的交叉學科研究領域,解決實際問題,提升研究效率和深度。
评分 评分 评分 评分 评分相關圖書








本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有