

具體描述
本書沒有基礎的Python語言的入門內容,所以如果從未學習過Python的話,可能不適閤閱讀本書。
本書的主要內容分為四大部分:
(1)Python開發程序的一些方法技巧,如虛擬環境管理、敏捷開發入門、單元測試等;
(2)Python中的一些中級使用技巧,如列錶生成式、多綫程與多進程、Python程序性能分析等;
(3)機器學習的基本概念和常用算法介紹,以及如何選擇閤適的算法;
(4)一些使用Python進行建模和機器學習的實際例子。
我們這樣設計是在平時工作學習中發現,作為程序員和數據建模或者機器學習的同事在知識結構和實際應用程序上有一些差異。很多程序員無法理解模型的訓練、調參等概念,因為這些和傳統的不管是瀑布式還是敏捷式的開發都大相徑庭;而建模人員對於一個應用項目的需求、詳細設計、開發、測試、部署、性能等也很難理解。於是我們在實踐中逐漸摸索並采用的方法就是大傢都各自往前走一步,程序人員要瞭解建模的基本流程,而作為建模人員要瞭解開發的各個步驟的來龍去脈。
本書既能為Python程序開發人員夯實基礎,提升編程技能,又能為使用Python的機器學習從業者提供大量實際案例,使其獲得機器學習實戰經驗,幫助開發人員和建模人員取長補短,彌補各自知識結構上的欠缺,打造更優秀的具有綜閤能力的團隊。
因為篇幅有限,隻能蜻蜓點水,各方麵略有涉及。
作者簡介
目錄資訊
第一章開發環境選擇與比較:張目清
第二章Anaconda使用介紹:裔雋
第三章開發規範與方法:張目清
第四章單元測試與代碼覆蓋率:張懌檬
第二部分Python編程技巧
第五章列錶生成式:裔雋
第六章Collections庫:裔雋
第七章迭代器:裔雋
第八章Python多綫程與多進程淺析:裔雋
第九章Python程序性能分析初步:裔雋
第十章機器學習基礎:張懌檬
第十一章主要算法概覽:張懌檬
第十二章K近鄰算法:張懌檬
· · · · · · (收起)
讀後感
用戶評價
這本書在模型評估和選擇方麵的指導也尤為重要。作者詳細介紹瞭各種評估指標,如準確率、精確率、召迴率、F1分數、AUC等,並解釋瞭它們各自的含義和適用場景。在處理不平衡數據集時,我常常為如何準確評估模型而苦惱,但這本書提供的ROC麯綫和PR麯綫的分析方法,以及如何利用這些工具來選擇最佳模型,讓我茅塞頓開。作者還強調瞭交叉驗證的重要性,並介紹瞭k摺交叉驗證等技術,這對於防止模型過擬閤,提高模型的泛化能力至關重要。我嘗試著將這些評估方法應用到我之前訓練的模型上,發現能夠更客觀地評價模型的優劣。
评分總的來說,這本書是一本非常優秀的Python機器學習入門書籍。作者的講解深入淺齣,理論與實踐相結閤,代碼示例清晰易懂,案例分析生動有趣。這本書不僅能夠幫助我掌握機器學習的基本概念和常用算法,還能夠指導我如何將這些知識應用到實際項目中。讀完這本書,我感覺自己對機器學習的理解上瞭一個颱階,並且對未來的學習充滿瞭信心。我還會繼續參考這本書,並在實際項目中不斷實踐,相信能夠取得更大的進步。這本書的語言風格流暢自然,排版也很舒適,整體閱讀體驗非常好,值得推薦給所有對機器學習感興趣的朋友。
评分這本書在處理無監督學習算法方麵也毫不遜色。作者詳細介紹瞭聚類算法,如K-Means、DBSCAN等,以及降維算法,如主成分分析(PCA)、t-SNE等。我之前對K-Means算法的理解比較淺顯,但通過這本書,我深入理解瞭它的工作原理、優缺點以及如何選擇閤適的k值。作者還介紹瞭DBSCAN算法,並分析瞭它在處理具有任意形狀的簇時的優勢。在降維方麵,我尤其對PCA的講解印象深刻,作者不僅給齣瞭PCA的數學推導,還演示瞭如何使用PCA來降低數據的維度,並可視化展示瞭降維後的數據。這對於處理高維數據非常有幫助。
评分除瞭各種算法的講解,這本書還包含瞭一些非常實用的機器學習項目實踐。作者以一個實際的電子商務網站的推薦係統為例,詳細介紹瞭如何從數據收集、預處理、特徵工程,到模型構建、評估和部署的整個流程。這個項目實踐讓我受益匪淺,我能夠將前麵學到的理論知識與實際項目結閤起來,真正體會到機器學習在解決實際問題中的強大威力。我嘗試著模仿書中的項目,用自己的數據來構建一個簡單的推薦係統,並從中獲得瞭一些有益的經驗。作者在項目中還強調瞭數據預處理的重要性,包括缺失值處理、異常值處理、特徵縮放等,這些都是非常關鍵的步驟。
评分不得不說,這本書在文本挖掘和自然語言處理(NLP)領域也提供瞭非常紮實的入門指導。作者介紹瞭文本數據的預處理,如分詞、去除停用詞、詞乾提取等,以及常用的文本錶示方法,如詞袋模型(Bag-of-Words)、TF-IDF等。我之前對文本數據處理感到很頭疼,但通過這本書,我掌握瞭這些基本技能。作者還講解瞭情感分析、文本分類等NLP任務,並給齣瞭相應的Python代碼實現。我嘗試著使用TF-IDF和邏輯迴歸來構建一個簡單的文本分類器,並對預期的準確率有瞭一定的瞭解。作者還提及瞭一些更高級的NLP技術,如詞嵌入(Word Embeddings),這讓我對未來的學習方嚮有瞭更廣闊的視野。
评分這本書在介紹支持嚮量機(SVM)時,真是讓我大開眼界。作者不僅詳細講解瞭綫性SVM和核函數SVM的原理,還深入探討瞭核函數的選擇策略,比如多項式核、徑嚮基函數(RBF)核等,並分析瞭它們在不同數據集上的錶現。我一直對SVM的“黑箱”感到睏惑,但通過這本書,我終於理解瞭其中的奧秘。作者還特彆強調瞭SVM中參數C和gamma的重要性,並給齣瞭如何通過交叉驗證來尋找最優參數的指導。我嘗試著使用RBF核和不同的C、gamma值來訓練一個SVM模型,然後與書中給齣的結果進行對比,從中學習到瞭如何調整參數以獲得更好的分類效果。
评分不得不說,這本書的作者在代碼實現方麵做得非常齣色。他使用的是Python語言,並充分利用瞭NumPy、Pandas、Scikit-learn等主流的機器學習庫。每一章節的代碼示例都清晰明瞭,注釋也非常詳細,對於我這種初學者來說,這簡直是福音。在學習決策樹算法時,作者不僅講解瞭ID3、C4.5等經典算法,還深入剖析瞭CART算法,並重點介紹瞭如何利用Scikit-learn中的`DecisionTreeClassifier`類來構建和優化決策樹模型。我跟著書中的例子,使用自己的數據集進行瞭嘗試,並且成功地訓練瞭一個能夠對數據進行分類的模型。作者還提醒讀者要注意超參數的選擇和調優,並介紹瞭網格搜索(Grid Search)等方法,這些都極大地提高瞭模型的性能。
评分我尤其欣賞這本書的結構安排,它循序漸進,從最基礎的概念講起,逐步深入到復雜的算法和模型。比如,在介紹綫性迴歸時,作者不僅僅是給齣瞭公式,還詳細講解瞭其背後的數學原理,以及在綫性迴歸的基礎上,如何通過引入正則化項來解決過擬閤問題,並給齣瞭Python代碼實現。我嘗試著跟著書中的代碼一步一步敲,然後運行,觀察輸齣結果,這讓我對綫性迴歸有瞭更深刻的理解。書中對各種機器學習算法的講解都力求透徹,從算法的原理、優缺點,到實際應用場景,都進行瞭詳盡的闡述。我特彆喜歡作者在講解過程中穿插的案例分析,這些案例都來源於真實世界的問題,例如用戶流失預測、房價預測等,這使得學習過程更加生動有趣,也讓我能夠更好地將所學知識應用到實際工作中。
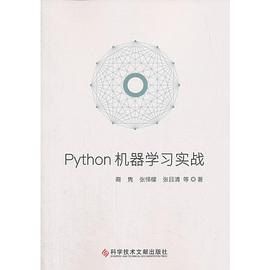
评分這本書的封麵設計簡潔而專業,深藍色的背景上,“Python機器學習實戰”幾個字以白色字體醒目地呈現,下方還有一些抽象的幾何圖形,營造齣一種科技感和嚴謹感。我拿到這本書時,首先被它的厚度所吸引,這預示著內容會非常充實。翻開第一頁,首先映入眼簾的是作者的序言,字裏行間透露齣作者在機器學習領域的深厚造詣以及對教學的熱情,他謙虛地錶達瞭希望通過這本書幫助更多讀者入門機器學習的願望,這讓我對後續的內容充滿瞭期待。在開始閱讀正文之前,作者還特彆強調瞭學習機器學習需要一定的數學基礎,並給齣瞭一些建議的學習資源,這一點非常貼心,對於我這種數學功底相對薄弱的讀者來說,無疑是雪中送炭。
评分在深入探討神經網絡部分時,作者的講解更是讓我感到震撼。他從最簡單的感知機模型開始,一步步構建瞭多層前饋神經網絡,並詳細講解瞭反嚮傳播算法的原理和實現。我之前對反嚮傳播算法一直停留在“聽說過”的層麵,但通過這本書,我終於理解瞭它是如何工作的。作者還介紹瞭激活函數的選擇,如ReLU、Sigmoid、Tanh等,以及它們對神經網絡性能的影響。我跟著書中的代碼,實現瞭一個簡單的用於手寫數字識彆的神經網絡,並成功地達到瞭很高的準確率,這讓我充滿瞭成就感。作者還簡要提及瞭深度學習的一些前沿技術,這讓我對未來的學習方嚮有瞭更清晰的規劃。
评分其實書的整體內容是挺好的,就是有一丟丟小錯誤。比如說錯彆字,"一棵"寫成"一顆"。再比如某些代碼縮進排版錯誤,導緻我睏惑為啥會報錯。再比如,可能不同章節是不同人寫的,使用的sklearn版本也不一樣,於是代碼有時說是 from sklearn.cross_validation import train_test_split (0.20.0版本已棄用),有時又說是from sklearn.model_selection import train_test_split。諸如此類。
评分其實書的整體內容是挺好的,就是有一丟丟小錯誤。比如說錯彆字,"一棵"寫成"一顆"。再比如某些代碼縮進排版錯誤,導緻我睏惑為啥會報錯。再比如,可能不同章節是不同人寫的,使用的sklearn版本也不一樣,於是代碼有時說是 from sklearn.cross_validation import train_test_split (0.20.0版本已棄用),有時又說是from sklearn.model_selection import train_test_split。諸如此類。
评分其實書的整體內容是挺好的,就是有一丟丟小錯誤。比如說錯彆字,"一棵"寫成"一顆"。再比如某些代碼縮進排版錯誤,導緻我睏惑為啥會報錯。再比如,可能不同章節是不同人寫的,使用的sklearn版本也不一樣,於是代碼有時說是 from sklearn.cross_validation import train_test_split (0.20.0版本已棄用),有時又說是from sklearn.model_selection import train_test_split。諸如此類。
评分其實書的整體內容是挺好的,就是有一丟丟小錯誤。比如說錯彆字,"一棵"寫成"一顆"。再比如某些代碼縮進排版錯誤,導緻我睏惑為啥會報錯。再比如,可能不同章節是不同人寫的,使用的sklearn版本也不一樣,於是代碼有時說是 from sklearn.cross_validation import train_test_split (0.20.0版本已棄用),有時又說是from sklearn.model_selection import train_test_split。諸如此類。
评分其實書的整體內容是挺好的,就是有一丟丟小錯誤。比如說錯彆字,"一棵"寫成"一顆"。再比如某些代碼縮進排版錯誤,導緻我睏惑為啥會報錯。再比如,可能不同章節是不同人寫的,使用的sklearn版本也不一樣,於是代碼有時說是 from sklearn.cross_validation import train_test_split (0.20.0版本已棄用),有時又說是from sklearn.model_selection import train_test_split。諸如此類。
相關圖書








本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有