
具体描述
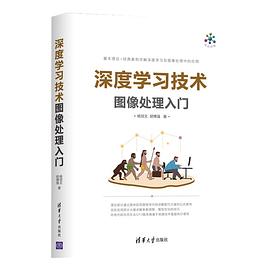
本书从机器学习、图像处理的基本概念入手,逐步阐述深度学习图像处理技术的基本原理以及简单的实现。继而以几个实战案例来介绍如何使用深度学习方法,在数据分析竞赛中取得较高的排名。#后,通过一个实战案例,介绍如何将模型放入 iOS 程序,制作相应的人工智能手机App。
本书适用于对深度学习有兴趣、希望入门这一领域的理工科大学生、研究生,以及希望了解该领域基本原理的软件开发人员。此外,本书所有案例均提供了云环境上的代码,便于读者复现结果,并进行深入学习。
作者简介
目录信息
1.1 为什么要使用指定的开发环境1
1.2 硬件准备2
1.2.1 在亚马#租用云GPU服务器2
1.2.2 在腾讯云租用GPU服务器4
1.2.3 在云服务器中开启搭载开发环境的Docker服务8
1.3 软件准备9
1.3.1 在Ubuntu 16.04下配置环境9
1.3.2 在CentOS 7下配置环境12
1.4 参考文献及网页链接12
第2章 温故知新——机器学习基础知识13
2.1 人工智能、机器学习与深度学习13
2.2 训练一个传统的机器学习模型15
2.2.1 第#步,观察数据16
2.2.2 第#步,预览数据17
2.3 数据挖掘与训练模型29
2.3.1 第#步,准备数据29
2.3.2 第#步,挖掘数据特征31
2.3.3 第三步,使用模型37
2.3.4 第四步,代码实战44
2.4 参考文献及网页链接49
第3章 数形结合——图像处理基础知识50
3.1 读取图像文件进行基本操作51
3.1.1 使用python-opencv读取图片51
3.1.2 借助python-opencv进行不同编码格式的转换52
3.1.3 借助python-opencv改变图片尺寸53
3.2 用简单的矩阵操作处理图像53
3.2.1 对图像进行复制与粘贴53
3.2.2 把图像当成矩阵进行处理——二维码转换成矩阵54
3.3 使用OpenCV“抠图”——基于颜色通道以及形态特征59
3.4 基于传统特征的传统图像分类方法64
3.4.1 将图片简化为少数区域并计算每个区域轮廓特征的方向66
3.4.2 将HOG变换运用在所有正负样本中68
3.4.3 训练模型70
3.4.4 将训练好的分类器运用在新的图片中71
3.5 参考文献及网页链接73
第4章 继往开来——使用深度神经网络框架74
4.1 从逻辑回归说起74
4.2 深度学习框架76
4.3 基于反向传播算法的自动求导77
4.4 简单的深度神经网络框架实现80
4.4.1 数据结构部分81
4.4.2 计算图部分83
4.4.3 使用方法85
4.4.4 训练模型86
4.5 参考文献及网页链接89
第5章 排列组合——深度神经网络框架的模型元件90
5.1 常用层92
5.1.1 Dense92
5.1.2 Activation92
5.1.3 Dropout93
5.1.4 Flatten94
5.2 卷积层94
5.2.1 Conv2D94
5.2.2 Cropping2D101
5.2.3 ZeroPadding2D101
5.3 池化层102
5.3.1 MaxPooling2D102
5.3.2 AveragePooling2D102
5.3.3 GlobalAveragePooling2D103
5.4 正则化层与过拟合104
5.5 反卷积层105
5.6 循环层109
5.6.1 SimpleRNN109
5.6.2 LSTM109
5.6.3 GRU110
5.7 参考文献及网页链接110
第6章 少量多次——深度神经网络框架的输入处理112
6.1 批量生成训练数据113
6.2 数据增强115
6.3 参考文献及网页链接117
第7章 愚公移山——深度神经网络框架的模型训练118
7.1 随机梯度下降119
7.2 动量法120
7.3 自适应学习率算法121
7.4 实验案例124
7.5 参考文献及网页链接128
第8章 小试牛刀——使用深度神经网络进行CIFAR-10数据分类129
8.1 上游部分——基于生成器的批量生成输入模块131
8.2 核心部分——用各种零件搭建深度神经网络131
8.3 下游部分——使用凸优化模块训练模型132
8.4 参考文献及网页链接133
第9章 见多识广——使用迁移学习提升准确率134
9.1 猫狗大战1.0——使用卷积神经网络直接进行训练135
9.1.1 导入数据135
9.1.2 可视化137
9.1.3 分割训练集和验证集138
9.1.4 搭建模型140
9.1.5 模型训练141
9.1.6 总结142
9.2 猫狗大战2.0——使用ImageNet数据集预训练模型142
9.2.1 迁移学习142
9.2.2 数据预处理143
9.2.3 搭建模型143
9.2.4 模型可视化144
9.2.5 训练模型145
9.2.6 提交到kaggle评估146
9.3 猫狗大战3.0——使用多种预训练模型组合提升表现146
9.3.1 载入数据集147
9.3.2 使用正确的预处理函数147
9.3.3 搭建特征提取模型并导出特征147
9.3.4 搭建并训练全连接分类器模型148
9.3.5 在测试集上预测149
9.4 融合模型150
9.4.1 获取特征150
9.4.2 数据持久化151
9.4.3 构建模型151
9.4.4 在测试集上预测152
9.5 总结153
9.6 参考文献及网页链接154
第10章 看图识字——使用深度神经网络进行文字识别155
10.1 使用卷积神经网络进行端到端学习155
10.1.1 编写数据生成器157
10.1.2 使用生成器157
10.1.3 构建深度卷积神经网络158
10.1.4 模型可视化158
10.1.5 训练模型160
10.1.6 计算模型总体准确率161
10.1.7 测试模型161
10.1.8 模型总结162
10.2 使用循环神经网络改进模型162
10.2.1 CTC Loss163
10.2.2 模型结构164
10.2.3 模型可视化165
10.2.4 数据生成器167
10.2.5 评估模型168
10.2.6 评估回调169
10.2.7 训练模型169
10.2.8 测试模型171
10.2.9 再次评估模型171
10.2.10 总结173
10.3 识别四则混合运算验证码(初赛)173
10.3.1 问题描述174
10.3.2 数据集探索174
10.3.3 模型结构176
10.3.4 结果可视化181
10.3.5 总结182
10.4 识别四则混合运算验证码(决赛)183
10.4.1 问题描述183
10.4.2 数据集探索184
10.4.3 数据预处理186
10.4.4 模型结构192
10.4.5 生成器195
10.4.6 模型的训练197
10.4.7 预测结果198
10.4.8 模型结果融合199
10.4.9 其他尝试200
10.4.10 小结202
10.5 参考文献及网页链接203
· · · · · · (收起)
读后感
用户评价
我不得不说,这本书的阅读体验是充满挑战性的,但也是极其有回报的。它没有过多地渲染技术带来的“神奇效果”,反而将大量的篇幅用于剖析那些在工程实践中常常被忽略的“边界条件”和“假设前提”。例如,书中对于高维空间中距离测量的敏感性分析,以及如何通过精巧的正则化手段来对抗维度灾难的讨论,展现了作者在理论建模上的深厚功力。我特别欣赏作者在处理优化算法时的那种“去神秘化”的态度,不再把梯度下降法奉为圭臬,而是细致地比较了不同动量策略、学习率调度机制在特定函数结构下的收敛特性和稳定性表现。这种注重细节的叙述,使得读者在面对实际应用中的收敛缓慢或震荡问题时,能有一个更清晰的诊断思路。书中对“泛化能力”的探讨,更是上升到了哲学层面,探讨了模型在多大程度上能真正代表“世界真相”,而不是仅仅记住训练样本的噪声。对于希望从“调参工程师”跃升为“系统架构师”的读者来说,这本书提供的思维框架是无价之宝,它教会你如何审视工具本身,而不是盲目追逐最新的算法名词。
与其说这是一本技术指南,不如说它是一份关于现代信息处理范式的严肃宣言。这本书的笔触冷峻而精确,几乎没有一处冗余的文字,所有的论证都直接指向核心。我尤其欣赏作者在处理“不确定性量化”时的那种毫不妥协的态度。书中并未给出那些简单化的概率区间估计,而是深入探讨了贝叶斯框架下,先验信息对后验分布塑造的敏感性,并详细分析了不同假设检验方法在面对数据稀疏性时的表现差异。这种对“我们不知道什么”的诚实揭示,远比一味地宣传模型的预测精度更有价值。在关于模型可解释性的章节中,作者更是挑战了当前业界主流的“局部解释”思路,提出了基于信息瓶颈原则的全局结构洞察方法,这种高度抽象的视角,迫使我们重新思考“理解”一个复杂系统到底意味着什么。总而言之,这本书需要读者以一种对待高等数学或理论物理的态度去对待,它提供的不是即插即用的解决方案,而是可以用来解构任何新兴计算问题的思维武器。
初翻此书时,我原本预期会看到大量关于最新神经网络架构的介绍,但事实是,作者选择了更具穿透力的角度切入。该书更侧重于对信息处理本质的探讨,用一种近乎古典的、基于信息论的视角来审视现代计算。其中关于“压缩感知”与“稀疏表示”的章节,与后续探讨的现代特征提取机制形成了完美的呼应,揭示了底层数学原理是如何跨越不同技术范式的。作者在论述中表现出一种罕见的克制力,避免了使用那些浮夸的形容词,而是用精确的数学语言来定义和限定每一个概念的适用范围。这种严谨性使得这本书的保质期非常长,因为它关注的是不会轻易过时的基本原理。最让我印象深刻的是,作者在讨论模型的复杂度和模型容量时,引入了 Kolmogorov 复杂度的一些概念,这使得我们对“最小有效模型”的理解不再是经验性的,而是有了理论上的锚点。对于那些真正想理解数据是如何被编码、解码和转化的读者,这本书提供了最坚实的哲学和数学基础,它要求读者去“计算思维”,而不是仅仅“使用软件”。
这本关于现代计算范式的著作,无疑是一部需要耐心和投入才能完全领略其深度的作品。开篇的叙述方式,如同引导读者进入一个宏大而复杂的迷宫,作者并未急于抛出那些被过度包装的“黑科技”名词,而是从信息论和概率统计的基石开始,缓慢而坚定地构建起整个理论的逻辑框架。特别是关于信息熵在数据压缩和特征提取中的作用的论述,其严谨性和数学推导的清晰度,让我这个非科班出身的读者也能感受到其中蕴含的强大力量。书中对“模型”这一核心概念的界定,远超出了简单的函数拟合,它深入探讨了模型作为一种对世界本质规律的抽象表达的可能性与局限性,这一点非常值得称道。全书的行文风格偏向于学术专著,大量的公式推导和严密的论证过程,要求读者必须具备扎实的数学基础,否则很容易在中间章节迷失方向。不过,一旦跨越了前期的理论铺垫,后续章节对复杂系统建模的探讨,尤其是引入非线性动力学视角来解析某些优化过程时,那种豁然开朗的感觉,是阅读其他市面上同类书籍难以体会的。它更像是一部数学工具箱的说明书,而不是一本快速上手的操作指南,强调的是对底层原理的深刻理解。
这本书的结构设计颇为精妙,它似乎有意地将读者从最直观的、基于图结构的直觉中拉开,转而深入到更底层的代数和分析层面。全书的逻辑推进如同剥洋葱,一层层地揭示了复杂系统的内在机理。我特别关注了书中关于“时间序列建模”那一部分,作者没有局限于当下流行的循环结构,而是深入探讨了马尔可夫过程的精确表达及其在有限状态机中的映射关系。对于如何在高维、非平稳的环境中保持预测模型的长期一致性,作者提供了一套基于信息流守恒的分析框架,这与我之前阅读的许多侧重于特定应用场景的教材截然不同。这种方法论上的高度统一性,使得读者能够举一反三,将书中介绍的原理迁移到完全陌生的领域。此外,书中对计算复杂度的讨论也异常深入,它不仅分析了训练时间,更关注了推理阶段的资源消耗与理论可行性的平衡点。这本书更像是为那些渴望构建全新计算范式的人准备的蓝图,而不是给那些只想快速部署现有工具的人准备的速查手册,阅读过程充满了智力上的摩擦和探索的乐趣。
粗翻,还行,适合初学者。
粗翻,还行,适合初学者。
粗翻,还行,适合初学者。
粗翻,还行,适合初学者。
粗翻,还行,适合初学者。