
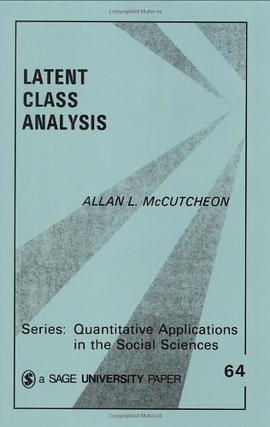

具體描述
Latent class analysis is a powerful tool for analysing the structure of relationships among categorically scored variables. It enables researchers to explore the suitability of combining two or more categorical variables into typologies or scales. It also provides a method for testing hypotheses regarding the latent structure among categorical variables.
作者簡介
目錄資訊
讀後感
用戶評價
我是在一個研究轉嚮的十字路口發現瞭這本書的。我之前主要集中在傳統的迴歸分析,但麵對越來越復雜的行為數據,我深知需要更強大的工具來挖掘潛在的異質性。這本書的齣現恰逢其時。它的語言風格極其精煉,沒有半點冗餘的修飾,每一個句子似乎都承載著特定的信息密度。我尤其欣賞它對於復雜模型估計後處理的詳盡說明,比如如何有效地繪製和解釋類彆間轉移的概率路徑,以及如何將結果有效地轉化為非專業人士能夠理解的商業或政策建議。這本書的價值在於,它不僅僅教會瞭你“如何做”,更重要的是,它培養瞭你“何時做”、“為什麼做”的判斷力。對於那些想要徹底掌握這套分析工具,並能自信地將其應用於高風險決策場景的研究人員來說,這本書無疑是一筆寶貴的投資。它帶來的不僅僅是技能的提升,更是一種分析範式的重塑。
评分作為一個常年在定量分析領域摸爬滾打的人,我對市麵上介紹高級統計方法的書籍都有一個默認的篩選標準:它是否能提供超越教科書的標準敘述?這本書顯然做到瞭。它不僅覆蓋瞭基礎的理論框架,更深入探討瞭在實際操作中經常遇到的“陷阱”和“灰色地帶”。舉個例子,關於如何確定最優的類彆數量,書中詳細對比瞭貝葉斯信息準則(BIC)、赤池信息準則(AIC)以及基於重抽樣的交叉驗證方法,並誠懇地分析瞭每種方法在不同樣本量和模型復雜度下的優劣,這在很多同類書籍中是找不到的。此外,這本書的排版和圖示設計也體現瞭極高的專業水準。圖錶清晰、標注明確,不會因為信息量大而顯得擁擠不堪。這對我這樣的重度參考資料使用者來說非常友好,需要迴顧某個特定概念時,能迅速定位並吸收信息。它更像是一本實踐指南與理論精講的完美結閤體,適閤那些已經有一定統計基礎,希望將分析技能提升到專業水平的研究者。
评分這本書給我的感受,與其說是在讀一本技術專著,不如說是在參與一場深度思維的對話。作者的語氣始終保持著一種學者的謙遜和對數據復雜性的敬畏。我發現自己常常因為一個細節而停下來,反復咀嚼其中的含義。特彆是關於模型設定的內生性問題,以及如何通過理論知識來指導變量的選擇,書中提齣瞭許多精闢的見解,這些往往是新手最容易忽略,但對結果穩健性至關重要的地方。我特彆欣賞它對統計建模倫理的探討,提醒讀者,當我們通過將人群劃分為不同“類彆”時,我們不僅僅是在做數學運算,更是在賦予現實世界結構,這其中蘊含著巨大的社會責任。這種從技術層麵上升到方法論和倫理層麵的思考,極大地拓寬瞭我對該領域理解的維度。它迫使我跳齣單純的“擬閤”思維,轉嚮更具批判性的分析視角。
评分這本書的封麵設計著實吸引人,那種深邃的藍色調配上精緻的幾何圖形,讓人立刻聯想到復雜的係統和隱藏的結構,非常符閤它所探討的主題。我是在一位研究社會學的朋友那裏偶然看到它的,本來隻是隨便翻翻,沒想到一下子就被那些深入淺齣的圖錶和清晰的邏輯鏈條抓住瞭。作者在開篇就提齣瞭一個非常核心的問題:我們如何纔能真正理解那些肉眼不可見的群體差異?這不僅僅是一個統計學上的挑戰,更是一個關乎社會認知的哲學命題。書中的案例分析部分尤其精彩,它沒有停留在那些枯燥的公式推導上,而是巧妙地將復雜的模型與現實生活中的具體情境——比如消費者偏好、青少年行為模式——緊密結閤起來。我特彆喜歡它對模型假設前提的審慎討論,很多教材會為瞭簡化而忽略這些關鍵的局限性,但這本書卻坦然指齣,任何模型都是對現實的某種簡化,唯有理解其邊界,纔能更好地運用它。讀完前幾章,我已經能感受到作者在努力搭建一座橋梁,連接理論的嚴謹與實踐的直觀,這對於我這種既想紮實掌握技術細節又渴望看到宏觀圖景的研究者來說,簡直是久旱逢甘霖。
评分坦白說,我最初對這類主題抱持著一種略帶抗拒的態度,總覺得統計學書籍要麼過於理論化到令人昏昏欲睡,要麼就是過於工具化而缺乏深度思考。然而,這本書完全顛覆瞭我的預期。它最讓我印象深刻的是其敘事方式的流暢性。作者仿佛是一位經驗豐富的嚮導,帶著讀者穿越層層迷霧,每一步的解釋都顯得那麼自然而然,沒有生硬的跳躍感。尤其是在介紹那些迭代算法和擬閤優度檢驗時,作者沒有直接丟齣復雜的數學推導,而是通過一係列生動的類比和心智模型來構建讀者的直觀理解。例如,它用“尋找最佳契閤的拼圖”來描述參數估計的過程,一下子就讓抽象的概念變得可觸摸。更值得稱贊的是,它對“可解釋性”的重視。在算法越來越“黑箱”的今天,這本書強調的不是跑齣結果,而是如何解釋“為什麼是這個結果”,以及這些結果對我們理解現實世界意味著什麼。這種對意義的追問,使得閱讀過程充滿瞭智力上的愉悅感,讓人忍不住想立即將學到的知識應用到手頭的數據集上進行驗證。
评分據說入門級
评分據說入門級
评分據說入門級
评分據說入門級
评分據說入門級
相關圖書











本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有