
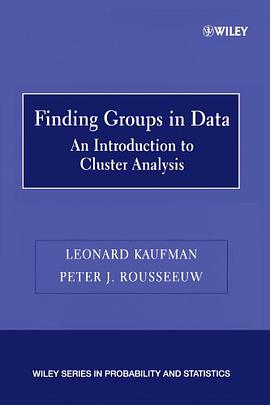

具体描述
The Wiley-Interscience Paperback Series consists of selected books that have been made more accessible to consumers in an effort to increase global appeal and general circulation. With these new unabridged softcover volumes, Wiley hopes to extend the lives of these works by making them available to future generations of statisticians, mathematicians, and scientists. "Cluster analysis is the increasingly important and practical subject of finding groupings in data. The authors set out to write a book for the user who does not necessarily have an extensive background in mathematics. They succeed very well."
Mathematical Reviews "Finding Groups in Data [is] a clear, readable, and interesting presentation of a small number of clustering methods. In addition, the book introduced some interesting innovations of applied value to clustering literature."
Journal of Classification "This is a very good, easy-to-read, and practical book. It has many nice features and is highly recommended for students and practitioners in various fields of study."
Technometrics An introduction to the practical application of cluster analysis, this text presents a selection of methods that together can deal with most applications. These methods are chosen for their robustness, consistency, and general applicability. This book discusses various types of data, including interval-scaled and binary variables as well as similarity data, and explains how these can be transformed prior to clustering.
作者简介
目录信息
读后感
用户评价
这本书的语言风格相当的独特,它不像我读过的那些教科书那样刻板和严肃,反而带有一种老派学者的沉稳和睿智。作者在描述某些高阶统计概念时,偶尔会引用一些哲学思考,这使得阅读过程充满了哲思的乐趣。比如,当探讨“什么是真正的相似性”时,书中引发了我对界定边界和模糊集合的深刻思考,这已经超越了纯粹的技术范畴,上升到了认知论的层面。尽管内容涉及复杂的数据结构,但作者总能找到恰当的比喻来锚定读者的理解。例如,讲解降维技术时,他将数据想象成一个三维雕塑,然后逐步将其投影到二维平面上,同时解释了信息损失的必然性,这种画面感极强,让人过目不忘。
评分我花了一整个周末的时间沉浸在这本书里,其中关于异常值检测的部分让我印象尤为深刻。作者深入探讨了在不同噪声水平的数据集中,如何巧妙地辨识出那些“不合群的个体”,而不仅仅是简单地剔除它们。他不仅介绍了基于距离的方法,还详细分析了基于密度的识别策略,并且非常坦诚地指出了每种方法的局限性,没有给出“万能钥匙”式的结论,这反而让我更加信服。这种严谨且不失人情味的写作态度,让我感受到作者对数据科学的尊重和深刻理解。我甚至开始反思自己过去处理数据时可能存在的偏见和简化处理,这本书无疑提供了一个更精细、更具批判性的视角。
评分这本书的排版和装帧质量也值得一提。字体选择大气清晰,行距和页边距的设计都非常舒适,长时间阅读也不会感到眼睛疲劳。更重要的是,书中那些复杂的图表,比如树状图的层次结构展示,或者多维散点图的映射效果,都被清晰、准确地呈现出来,没有出现任何模糊不清或色彩失真的情况。对于一本侧重于视觉化分析的书籍来说,这一点至关重要。它不仅仅是一本理论著作,更像是一件精心制作的工艺品,每一次翻阅都带来一种愉悦的触感和视觉享受。我强烈推荐给所有那些想要从海量信息中提炼出洞察力的实践者和思考者。
评分初读这本书的章节布局时,我注意到作者似乎非常注重理论与实践的平衡。我特别喜欢它介绍经典聚类算法的那几章,作者没有直接抛出复杂的数学推导,而是先用生动的类比解释了算法的核心思想,比如K-Means的“抢地盘”过程,听起来就像一个有趣的策略游戏。这种教学方式极大地降低了我对技术性内容的畏惧感。更让我惊喜的是,书中穿插了许多真实世界的案例分析,比如如何通过这些方法识别出不同类型的网络用户行为模式,或者在医学影像中区分出不同病灶区域。这些案例的细节描述得非常到位,让我能清晰地看到理论是如何转化为解决实际问题的工具的。读到这里,我感觉自己不再是被动地接收知识,而是在主动地参与一场思维的探索之旅。
评分这本书的封面设计得非常引人注目,那种深邃的蓝色调和抽象的几何图形组合在一起,给人一种既现代又充满神秘感的感觉。我是在书店的“新书推荐”架上偶然看到它的,当时就被它的名字吸引了——“Finding Groups in Data”。虽然我对数据分析并不算科班出身,但作为一个对信息世界充满好奇的业余爱好者,我总觉得数据背后隐藏着某种规律和结构等待被发掘。这本书的引言部分,作者用一种非常平易近人的方式阐述了“分组”这个概念在现实生活中的广泛应用,从市场细分到生物学分类,一下子就让我感觉这个主题离我很近,不再是枯燥的数学公式。作者的叙事节奏把握得非常好,不会让人感到信息轰炸,而是像一个经验丰富的向导,带着读者逐步深入一个全新的领域。
评分 评分 评分 评分 评分相关图书








本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈图书下载中心 版权所有