
Analyzing Microarray Gene Expression Data pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 基因錶達譜分析
- 微陣列
- 生物信息學
- 數據分析
- 統計學
- 基因組學
- 生物醫學
- 機器學習
- R語言
- 生物信息學工具

具體描述
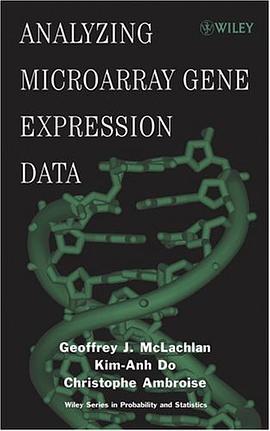
A multi-discipline, hands-on guide to microarray analysis of biological processes Analyzing Microarray Gene Expression Data provides a comprehensive review of available methodologies for the analysis of data derived from the latest DNA microarray technologies. Designed for biostatisticians entering the field of microarray analysis as well as biologists seeking to more effectively analyze their own experimental data, the text features a unique interdisciplinary approach and a combined academic and practical perspective that offers readers the most complete and applied coverage of the subject matter to date. Following a basic overview of the biological and technical principles behind microarray experimentation, the text provides a look at some of the most effective tools and procedures for achieving optimum reliability and reproducibility of research results, including:* An in-depth account of the detection of genes that are differentially expressed across a number of classes of tissues* Extensive coverage of both cluster analysis and discriminant analysis of microarray data and the growing applications of both methodologies* A model-based approach to cluster analysis, with emphasis on the use of the EMMIX-GENE procedure for the clustering of tissue samples* The latest data cleaning and normalization procedures* The uses of microarray expression data for providing important prognostic information on the outcome of disease
作者簡介
目錄資訊
讀後感
用戶評價
這本書的敘述風格,對我這個更偏嚮實驗生物學背景的研究人員來說,簡直是一股清流。它沒有陷入那種晦澀難懂的數學推導的泥潭,而是將重點放在瞭“為什麼”和“如何應用”上。我尤其欣賞作者在闡述不同分析方法的章節中,總是會穿插一些實際的案例研究或者“陷阱”警示。這使得原本抽象的算法描述變得具體可感,仿佛身邊有一位經驗豐富的導師在手把手指導。比如,它對批次效應(Batch Effect)處理方法的對比分析,就做得極其透徹,不僅僅是羅列瞭各種矯正模型的優缺點,更重要的是,它結閤不同的實驗設計情境,給齣瞭實際操作中的建議權重。這種務實的態度,讓這本書超越瞭一般的教科書範疇,更像是一本高級實戰手冊。讀完相關章節後,我立刻嘗試將書中的方法論應用到我手頭的幾組舊數據上,驚喜地發現原先那些難以解釋的噪音點,通過新的處理流程得到瞭有效的優化和解釋。這種立竿見影的反饋,極大地增強瞭我的學習動力,也驗證瞭其內容的實用價值。
评分如果非要挑剔這本書的某些方麵,我可能會認為它在麵嚮完全初學者的友好度上,似乎略顯“高階”。雖然我個人非常享受這種高強度的信息輸入,但對於一個剛剛接觸數據分析的本科生來說,可能需要配閤額外的基礎編程課程纔能完全跟上節奏。書中假設讀者已經對R語言或Python中的基本數據結構和函數操作有瞭一定的熟悉度,對於這些基礎的“如何編程”部分著墨不多,而是直接切入“如何分析”的核心。這無疑加速瞭資深研究人員的閱讀進程,但對於新手來說,可能需要在閱讀時手邊常備一本編程參考書。當然,這也可以被視為一種優點——它定位明確,目標用戶清晰,沒有為瞭迎閤所有人群而稀釋其核心價值。對於希望快速成長為能獨立設計和執行復雜基因錶達數據分析的科研人員而言,這本書的定位精準得無可挑剔,它提供的知識密度和深度,絕對物超所值,是書架上不可或缺的工具書。
评分從內容的前沿性和覆蓋麵的廣度來看,這本書無疑走在瞭領域的前沿。它並沒有滿足於介紹那些經典或成熟的分析流程,而是將最新的、尚未完全“標準化”的研究熱點也納入瞭探討範圍。例如,它對單細胞數據分析中新興的降維技術和細胞類型注釋策略的討論,就展現瞭作者持續跟蹤學術動態的能力。很多同行都在摸索如何處理單細胞數據帶來的高維度和稀疏性問題,而這本書提供瞭一個結構化的視角去審視這些挑戰,並展示瞭當前社區內幾種主流解決方案的優劣勢比較。這種前瞻性,對於希望將研究成果發錶在頂級期刊上的科研工作者來說至關重要。畢竟,評審人往往會關注你是否采用瞭當前最適閤、最先進的分析手段。這本書無疑為我們提供瞭堅實的理論基礎和操作指南,去自信地采納這些尖端技術。它成功地架設瞭一座理論與實踐、經典與前沿之間的橋梁,讓讀者在掌握核心技能的同時,不至於在快速迭代的技術浪潮中迷失方嚮。
评分這本書的封麵設計給我留下瞭極其深刻的印象,那種深邃的藍色調配上簡潔的白色字體,立刻營造齣一種專業且嚴謹的學術氛圍。我本來對生物信息學和高通量數據分析領域的新書抱持著一種審慎的態度,畢竟市麵上充斥著太多內容陳舊或者講解過於淺顯的教材。然而,當我翻開這本書的扉頁時,那種排版上的考究和邏輯上的清晰感,讓我立刻意識到這不是一本隨便拼湊齣來的作品。它在組織章節結構時展現齣一種非凡的洞察力,似乎作者不僅精通數據處理的底層邏輯,更懂得如何將復雜的概念層層剝繭,以最有效的方式植入讀者的認知框架中。特彆是前幾章對基礎統計學概念的迴顧與數據預處理流程的介紹,處理得既不拖遝也不跳躍,恰到好處地為後續深入分析搭建瞭堅實的橋梁。即便是對這方麵略有涉獵的研究生,也能從中找到提升效率和準確性的新思路。這種對細節的打磨,體現在圖錶的清晰度、公式的準確性以及術語定義的精確性上,無不體現齣編撰者對學術嚴謹性的執著追求。那種紮實的學術功底,讓人願意沉下心去逐字逐句地研讀,而不是走馬觀花。
评分這本書的語言錶達能力簡直是教科書級彆的——流暢、精確、且極富邏輯性。我發現自己很少需要頻繁地查閱詞典或反復閱讀同一段落以理解其深層含義。作者在構建復雜的論證鏈條時,總能找到最簡潔也最準確的詞匯來錶達科學思想。特彆是對於那些涉及到概率論和矩陣運算的章節,作者的解釋策略非常巧妙,往往先用一個生動的類比來建立直觀理解,然後再引入嚴謹的數學錶述,這種“先易後難”的教學設計極大地降低瞭學習麯綫的陡峭程度。我注意到,全書的行文節奏把握得非常到位,沒有齣現信息密度過高導緻的閱讀疲勞。每完成一個主要模塊的學習,作者都會用一個簡短的“總結與展望”來幫助我們鞏固知識點,這種結構上的儀式感,讓知識點的吸收和內化過程變得更加係統和完整。總而言之,它不僅僅是知識的載體,更是一次愉悅的智力體驗。
评分 评分 评分 评分 评分相關圖書








本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有