
具体描述
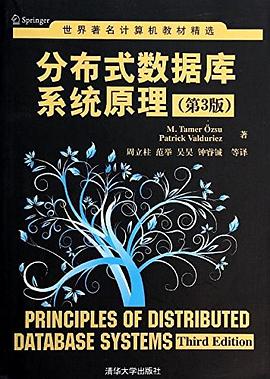
《分布式数据库系统原理(第3版)》主要介绍分布式数据库管理系统的基本概念、基本理论和设计问题,涵盖了分布式数据库系统的设计、实现和管理等方面的诸多专题。《分布式数据库系统原理(第3版)》不仅是高等院校计算机及相关专业本科生或研究生数据库系统课程的理想教材,对相关技术人员来说也是非常有价值的参考书。
作者简介
作者:(德国)厄兹叙(M.Tamer Ozsu) (德国)Patrick Valduriez 译者:周立柱 范举 吴昊 钟睿铖
目录信息
1.1 分布式数据处理
1.2 什么是分布式数据库系统
1.3 数据发送的不同选择
1.4 DDBS的承诺
1.4.1 分布及复制数据的透明管理
1.4.2 分布式事务提供的可靠性
1.4.3 改进的性能
1.4.4 更为容易的系统扩展
1.5 分布所带来的复杂性
1.6 设计问题
1.6.1 分布式数据库设计
1.6.2 分布式目录管理
1.6.3 分布式查询处理
1.6.4 分布式并发控制
1.6.5 分布式死锁管理
1.6.6 分布式数据库的可靠性
1.6.7 复制
1.6.8 问题之间的相互关系
1.6.9 其他方面的问题
1.7 分布式DBMS体系架构
1.7.1 ANSI/SPARC体系架构
1.7.2 集中式DBMS的通用体系架构
1.7.3 分布式DBMS体系架构的模型
1.7.4 自治性
1.7.5 分布
1.7.6 异构性
1.7.7 体系架构的不同选择
1.7.8 客户/服务器系统
1.7.9 P2P系统
1.7.10 多数据库体系架构
1.8 参考文献说明
第2章 背景知识
2.1关系DBMS概述
2.1.1关系数据库概念
2.1.2规范化
2.1.3关系语言
2.2计算机网络概述
2.2.1不同类型的网络
2.2.2通信方式
2.2.3数据通信的基本概念
2.2.4通信协议
2.3参考文献说明
第3章分布式数据库设计
3.1自顶向下的设计过程
3.2分布设计的研究问题
3.2.1为什么要分片
3.2.2不同的分片方法
3.2.3划分程度
3.2.4分片的正确性规则
3.2.5不同的分配方法
3.2.6信息需求
3.3分片
3.3.1水平分片
3.3.2垂直分片
3.3.3混合分片
3.4分配
3.4.1分配问题的定义
3.4.2信息需求
3.4.3分配模型
3.4.4解决办法
3.5数据目录
3.6本章小结
3.7参考文献说明
练习
第4章数据库集成
4.1自底向上的设计方法
4.2模式匹配
4.2.1模式异构性
4.2.2语言匹配方法
4.2.3基于限制的匹配方法
4.2.4基于学习的匹配方法
4.2.5组合匹配方法
4.3模式集成
4.4模式映像
4.4.1映像建立
4.4.2映像维护
4.5数据清洗
4.6本章小结
4.7参考文献说明
练习
第5章数据与访问控制
5.1 视图管理
5.1.1集中式DBMS中的视图
5.1.2分布式DBMS中的视图
5.1.3物化视图的维护
5.2数据安全
5.2.1裁决式访问控制
5.2.2多级访问控制
5.2.3分布式访问控制
5.3语义完整性控制
5.3.1集中式语义完整性控制
5.3.2分布式语义完整性控制
5.4本章小结
5.5参考文献说明
练习
第6章查询处理概述
6.1查询处理问题
6.2查询处理的目标
6.3关系代数运算的复杂度
6.4查询处理程序的刻画
6.4.1语言
6.4.2优化类型
6.4.3优化时机
6.4.4统计
6.4.5决策站点
6.4.6网络拓扑的利用
6.4.7利用复制的片段
6.4.8使用半连结
6.5查询处理的层次
6.5.1查询分解
6.5.2数据本地化
6.5.3全局查询优化
6.5.4分布式查询执行
6.6本章小结
6.7参考文献说明
第7章查询分解与数据本地化
7.1查询分解
7.1.1规范化
7.1.2分析
7.1.3去除冗余
7.1.4重写
7.2分布数据的本地化
7.2.1主水平划分的归约
7.2.2垂直分片的归约
7.2.3诱导分片的归约
7.2.4混合分片的归约
7.3本章小结
7.4参考文献说明
练习
第8章分布式查询的优化
8.1查询优化
8.1.1搜索空间
8.1.2搜索策略
8.1.3分布式代价模型
8.2集中式查询优化
8.2.1动态查询优化
8.2.2静态查询优化
8.2.3混合查询优化
8.3分布查询的连结排序
8.3.1连结排序
8.3.2基于半连结的算法
8.3.3连结与半连结的对比
8.4分布式查询优化
8.4.1动态方法
8.4.2静态方法
8.4.3基于半连结的方法
8.4.4混合方法
8.5本章小结
8.6参考文献说明
练习
……
第9章 多数据库查询处理
第10章 事务管理介绍
第11章 分布式并发控制
第12章 分布式DBMS的可靠性
第13章 数据复制
第14章 并行数据库系统
第15章 分布式对象数据库管理
第16章 P2P数据管理
第17章 万维网数据管理
第18章 前沿研究:流数据和云计算
参考文献
· · · · · · (收起)
读后感
用户评价
这本书的实践指导价值远超我的预期,它不仅仅是一本纯理论的书籍,更像是我们实际工作中遇到问题时的“救星”。我印象最深的是关于数据分片(Sharding)和数据分布策略的章节,里面详细对比了基于范围、哈希和列表的分片方法的优劣,并给出了针对不同数据访问模式的优化建议。尤其是关于“热点数据”问题的处理,书中提出的动态重分布算法和负载均衡策略,是我们在当前项目迭代中急需解决的痛点。作者的文字风格非常务实,没有过多华丽的辞藻,直击问题核心。很多设计决策的取舍都在文字中被清晰地表达出来,比如为什么在某些场景下,牺牲少量的实时一致性换取更高的写入吞吐量是合理的商业选择。这让我意识到分布式系统设计永远是关于权衡的艺术。
《分布式数据库系统原理》这本书的深度和广度让我这个技术爱好者感到惊艳。从一开始的理论基础构建,到后面复杂的系统设计和实现,作者的叙述逻辑清晰,层层递进,仿佛一位经验丰富的老教授在为你娓娓道来。我特别欣赏其中对CAP理论的深入剖析,不仅仅停留在教科书式的定义上,而是结合了大量的实际案例,比如著名的银行交易系统和社交媒体的数据一致性挑战,这些实例极大地帮助我理解了在特定业务场景下如何权衡可用性、一致性和分区容错性。书中对Paxos和Raft协议的讲解尤为精彩,作者没有直接堆砌公式和代码,而是用非常形象的比喻和流程图,将这些复杂的共识算法的运行机制拆解得一清二楚,让我这个之前在这些概念上迷茫了很久的人,豁然开朗。读完这部分内容,我感觉自己对构建高可靠、高性能的数据服务有了更坚实的心智模型。
这本书的排版和结构设计也值得称赞,它成功地将一个复杂且技术性极强的领域,组织成了一部易于消化的作品。每当一个新概念被引入时,作者都会先给出清晰的背景铺垫,然后是核心概念阐述,最后往往会附带一些关键术语的总结或者与相关技术(如NoSQL数据库)的对比分析。这种结构极大地提升了阅读效率。我个人尤其喜欢它在介绍新型分布式事务模型时,那种对历史演进的梳理。从早期的两阶段提交(2PC)的局限性,到后续各种优化方案的提出,整个脉络非常清晰。读者可以清晰地看到技术是如何一步步向前演进的,而不是被突兀地抛入某个最新的框架中。对于希望系统学习分布式领域知识的读者来说,这种循序渐进的方式是最高效的学习路径。
对于那些已经有一些数据库基础,但渴望深入理解底层架构的资深开发者而言,这本书绝对是不可多得的宝藏。它没有回避那些晦涩难懂的底层机制,例如分布式锁的实现细节、分布式快照(Snapshot Isolation)的隔离级别保证,以及如何利用向量时钟来解决因果一致性问题。作者对于这些细节的把握非常精准,引用的参考文献也十分权威。更重要的是,书中对“去中心化”架构的哲学思考,让我对“去中心化”的真正含义有了更深层次的理解——它不仅仅是关于没有主节点,更是关于如何设计健壮的、自愈合的系统。这种对技术背后的“为什么”的探索,是区分优秀技术书籍和普通技术手册的关键所在。
读完这本书,我感到自己的知识体系得到了极大的补强,尤其是在面对大规模数据存储和高并发访问的挑战时,不再是凭感觉去尝试解决方案。书中关于数据一致性协议的章节,对我后续参与系统选型工作产生了决定性的影响。它详尽对比了各类协议在不同网络延迟和节点故障模型下的性能表现和鲁棒性,这远比查阅零散的博客文章要系统和可靠得多。我甚至将书中关于故障检测和恢复机制的章节打印出来,作为我们团队内部进行架构评审时的重要参考资料。这本书成功地搭建了一座理论知识与工程实践之间的坚固桥梁,让抽象的数学模型真正落地为可靠、可扩展的实际系统。
晦涩难懂,章节全面但不细致。需要有数据库的基础才能读下去,例如范式,内联结外联结等,这本书都没有细讲,属于数据库进阶读物。
晦涩难懂,章节全面但不细致。需要有数据库的基础才能读下去,例如范式,内联结外联结等,这本书都没有细讲,属于数据库进阶读物。
晦涩难懂,章节全面但不细致。需要有数据库的基础才能读下去,例如范式,内联结外联结等,这本书都没有细讲,属于数据库进阶读物。
知识水平不够,康不下去(我要是有技术怎么会是这个吊样)
知识水平不够,康不下去(我要是有技术怎么会是这个吊样)