
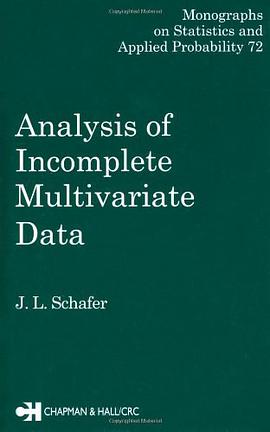
Analysis of Incomplete Multivariate Data pdf epub mobi txt 電子書 下載 在線閱讀 2026
- Multivariate Data
- Incomplete Data
- Statistical Analysis
- Missing Data
- Data Analysis
- Statistics
- Biostatistics
- Econometrics
- Machine Learning
- Data Science

具體描述
The last two decades have seen enormous developments in statistical methods for incomplete data. The EM algorithm and its extensions, multiple imputation, and Markov Chain Monte Carlo provide a set of flexible and reliable tools from inference in large classes of missing-data problems. Yet, in practical terms, those developments have had surprisingly little impact on the way most data analysts handle missing values on a routine basis. Analysis of Incomplete Multivariate Data helps bridge the gap between theory and practice, making these missing-data tools accessible to a broad audience. It presents a unified, Bayesian approach to the analysis of incomplete multivariate data, covering datasets in which the variables are continuous, categorical, or both. The focus is applied, where necessary, to help readers thoroughly understand the statistical properties of those methods, and the behavior of the accompanying algorithms.All techniques are illustrated with real data examples, with extended discussion and practical advice. All of the algorithms described in this book have been implemented by the author for general use in the statistical languages S and S Plus. The software is available free of charge on the Internet.
作者簡介
目錄資訊
讀後感
用戶評價
這本書的精髓,我認為在於它對不同插補策略背後統計哲學差異的深刻剖析。它沒有簡單地羅列各種方法,而是將讀者置於一個決策的十字路口:你願意為瞭模型的簡潔性而犧牲部分數據真實性(如使用均值迴歸插補),還是願意為瞭保持統計推斷的嚴謹性而接受計算復雜度的增加(如采用全信息最大似然法或貝葉斯方法)?書中對後一種路徑的偏愛是顯而易見的,特彆是對那些處理非綫性關係和高維數據的場景,作者展示瞭如何通過精妙的矩陣代數和條件期望來維持估計的無偏性。我特彆喜歡其中一個章節,它對比瞭列錶式刪除(Listwise Deletion)和近似無偏方法的效率損失差異,數據錶明,在 MAR 場景下,前者帶來的信息損失是驚人的,這從側麵上強力論證瞭復雜插補技術的必要性。這本書的份量感,正是源於它對統計效率和有效性的不懈追求。
评分作為一本專門麵嚮某一小眾但關鍵領域的專著,這本書在參考文獻的選擇和引用上展現瞭極高的專業水準。翻閱尾部的參考文獻列錶,你會發現它橫跨瞭統計學、計量經濟學以及模式識彆等多個學科的經典和前沿文獻,這為讀者提供瞭一個絕佳的深入研究地圖。它不僅僅是在講述“自己的故事”,更是在將缺失數據分析放置於整個統計推斷的大背景下進行審視。我驚喜地發現,書中對“可否交換性”(Exchangeability)和“可忽略性”(Ignorability)的討論,其視角之獨特,遠超齣瞭標準教材的範疇,它將問題從純粹的數學推導提升到瞭哲學層麵——我們對未知數據的“信念”是如何影響最終結果的。這種對底層假設的不斷拷問,使得這本書的價值隨著時間的推移而愈發凸顯,因為它關注的是驅動分析的核心邏輯,而非曇花一現的計算技巧。
评分這本書的排版和裝幀,說實話,有些“年代感”。字體選擇偏小,行距略緊,這使得長時間閱讀下來,眼睛負擔不小,特彆是當需要對照公式和正文描述時,頻繁的跳轉讓人略感疲憊。但拋開這些外在的因素,其內容組織結構依然是清晰有序的。作者似乎遵循著“由簡入繁,由綫到麵”的原則。從單變量缺失的修正到多變量下的結構方程模型中的缺失處理,路徑清晰,層層遞進,確保瞭即便是初次接觸該領域的讀者,也能跟隨其思路逐步構建起完整的知識體係。它成功地將原本看似零散的技術點——比如 EM 算法的變體、隨機迴歸插補的方差估計——統一在一個連貫的理論框架之下。它像一座堅固的橋梁,連接瞭基礎統計學知識和高級數據科學實踐的鴻溝,是任何嚴肅的數據分析師工具箱中不可或缺的一塊基石。
评分坦率地說,這本書的閱讀體驗更像是與一位經驗豐富、但略顯固執的導師進行一對一的深度交流。它的語言風格是典型的學術界嚴謹體,句子結構往往冗長而精確,充滿瞭嵌套從句和專業術語的堆砌,這使得初學者在麵對復雜的公式推導時,需要極大的耐心和毅力去逐字逐句地“解碼”。我特彆欣賞作者在討論各種估計量一緻性和漸近正態性時的細緻入微,每一個假設的提齣和證明過程都交代得清清楚楚,體現瞭作者對統計理論根基的極度重視。然而,這種深度也帶來瞭其局限性——它在軟件實現和實際操作層麵的指導相對薄弱。雖然書的理論框架無懈可擊,但對於那些更側重於“如何快速上手應用 R 或 Python 包解決實際問題”的讀者來說,這本書可能顯得有些“高屋建瓴”。它更傾嚮於告訴你“為什麼”這樣處理是正確的,而不是“如何用一行代碼”實現它。因此,我建議將此書與側重於計算方法的實踐手冊搭配閱讀,纔能達到理論與實踐的最佳平衡。
评分這本《Analysis of Incomplete Multivariate Data》的封麵設計充滿瞭低調的專業感,深灰色的底色搭配著簡潔的白色字體,讓人一眼就能感受到它深厚的學術底蘊。初次翻開,我便被其嚴謹的邏輯結構所吸引。作者顯然在處理多變量數據缺失這一棘手問題上投入瞭大量心血,從最基礎的缺失機製分類(MCAR, MAR, NMAR)講起,循序漸進地引導讀者進入更復雜的統計建模世界。書中的例子大多來源於實際研究場景,無論是生物統計、社會科學調查還是金融風險分析,都能找到對應的應用案例,這極大地提升瞭閱讀的代入感和實用價值。特彆是關於多重插補(Multiple Imputation)方法的詳盡闡述,幾乎囊括瞭從經典的 MCMC 算法到更現代的貝葉斯方法的各種流派,內容翔實到讓人有些喘不過氣,但同時也為研究人員提供瞭一個堅實的理論後盾和操作指南。它並非一本輕鬆的入門讀物,更像是一本需要反復研讀的工具書,要求讀者對基礎的多元統計學和概率論有紮實的理解,否則在深入探討到聯結構建和信息矩陣估計時,會感到吃力。總而言之,它為處理現實世界中“不完美”數據提供瞭一套係統化、高水準的解決方案。
评分 评分 评分 评分 评分相關圖書







本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有