
具体描述
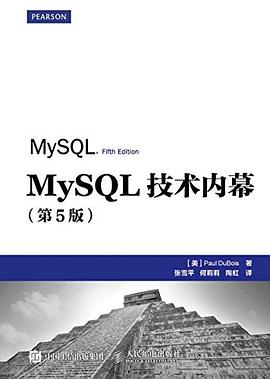
《MySQL技术内幕(第5版)》是MySQL方面名副其实的经典著作,全面介绍MySQL的基础知识以及MySQL有别于其他数据库系统的独特功能,书中特别关注如何高效地使用和管理MySQL。
《MySQL技术内幕(第5版)》由4个部分组成:第一部分集中介绍与数据库使用相关的一些基本概念,第二部分重点关注的是自己如何动手编写和使用MySQL的程序,第三部分主要是面向那些负责数据库管理的读者,第四部分提供了一些参考附录。书中包含大量示例,详尽地演示了MySQL的各项功能特性。此外,本书还为使用C语言、PHP语言和Perl语言开发数据库应用的读者提供了相关内容。
《MySQL技术内幕(第5版)》不仅适合MySQL初学者阅读,也适合想要深入了解MySQL的数据库管理人员和开发人员参考。
作者简介
Paul DuBois Sun 公司MySQL文档团队的技术作者、开源社区和MySQL社区活跃的技术专家,同时也是一名数据库管理员。他曾参与过MySQL在线文档的编写工作。除本 书外,他还著有MySQL and Perl for the Web、MySQL Cookbook、Using csh and tcsh以及Software Portability with imake等书。
目录信息
第1章 MySQL入门 1
1.1 MySQL的用途 1
1.2 示例数据库 3
1.2.1 美史联盟项目 4
1.2.2 成绩考评项目 5
1.2.3 如何运用示例数据库 5
1.3 基本数据库术语 6
1.3.1 结构术语 6
1.3.2 查询语言术语 8
1.3.3 MySQL的体系结构术语 8
1.4 MySQL教程 9
1.4.1 获取示例数据库发行包 10
1.4.2 基本配置要求 10
1.4.3 建立和断开MySQL服务器连接 11
1.4.4 执行SQL语句 13
1.4.5 创建数据库 15
1.4.6 创建表 15
1.4.7 添加新行 29
1.4.8 重置sampdb数据库 32
1.4.9 检索信息 33
1.4.10 删除或更新已有行 56
1.5 mysql交互技巧 58
1.5.1 简化连接过程 58
1.5.2 在调用命令时减少打字输入 60
1.6 何去何从 63
第2章 使用SQL管理数据 64
2.1 服务器的SQL模式 65
2.2 MySQL的标识符语法和命名规则 66
2.3 SQL语句的大小写规则 67
2.4 字符集支持 68
2.4.1 指定字符集 69
2.4.2 确定可用字符集和当前设置 70
2.4.3 Unicode支持 71
2.5 数据库的选择、创建、删除和更改 72
2.5.1 选择数据库 72
2.5.2 创建数据库 72
2.5.3 删除数据库 73
2.5.4 更改数据库 73
2.6 表的创建、删除、索引和更改 73
2.6.1 存储引擎的特性 73
2.6.2 创建表 77
2.6.3 删除表 84
2.6.4 索引表 84
2.6.5 更改表结构 88
2.7 获取数据库元数据 90
2.7.1 使用SHOW语句获取元数据 90
2.7.2 借助INFORMATION_SCHEMA获取元数据 92
2.7.3 从命令行获取元数据 94
2.8 使用连接实现多表检索 95
2.8.1 内连接 96
2.8.2 对被连接表里的列引用进行限定 97
2.8.3 左(外)连接和右(外)连接 97
2.9 使用子查询实现多表检索 100
2.9.1 带关系比较运算符的子查询 101
2.9.2 IN和NOT IN子查询 102
2.9.3 ALL、ANY和SOME子查询 103
2.9.4 EXISTS和NOT EXISTS子查询 103
2.9.5 相关子查询 104
2.9.6 FROM子句里的子查询 104
2.9.7 将子查询改写为连接 104
2.10 使用UNION实现多表检索 106
2.11 多表删除和更新 108
2.12 事务处理 110
2.12.1 利用事务保证语句安全执行 111
2.12.2 使用事务保存点 114
2.12.3 事务隔离 114
2.13 外键和引用完整性 116
2.14 使用FULLTEXT搜索 121
2.14.1 自然语言FULLTEXT搜索 122
2.14.2 布尔模式的全文搜索 124
2.14.3 查询扩展全文搜索 125
2.14.4 配置全文搜索引擎 126
第3章 数据类型 127
3.1 数据值类别 128
3.1.1 数值 128
3.1.2 字符串值 129
3.1.3 时态(日期/时间)值 136
3.1.4 空间值 136
3.1.5 布尔值 136
3.1.6 NULL值 136
3.2 MySQL数据类型 137
3.2.1 数据类型概述 137
3.2.2 表定义里的特殊列类型 138
3.2.3 指定列的默认值 139
3.2.4 数字数据类型 140
3.2.5 字符串数据类型 145
3.2.6 时态(日期/时间)数据类型 156
3.3 MySQL如何处理无效数据值 163
3.4 处理序列 164
3.4.1 通用的AUTO_INCREMENT属性 164
3.4.2 存储引擎特有的AUTO_INCREMENT属性 166
3.4.3 使用AUTO_INCREMENT列需要考虑的问题 168
3.4.4 AUTO_INCREMENT列的使用提示 168
3.4.5 在无AUTO_INCREMENT的情况下生成序列 170
3.5 表达式计算和类型转换 171
3.5.1 编写表达式 172
3.5.2 类型转换 177
3.6 选择数据类型 183
3.6.1 列要存放什么类型的值 184
3.6.2 所有值是否都在某个特定的区间内 186
第4章 视图和存储程序 188
4.1 使用视图 189
4.2 使用存储程序 191
4.2.1 复合语句和语句分隔符 191
4.2.2 存储函数和存储过程 193
4.2.3 触发器 196
4.2.4 事件 197
4.3 视图和存储程序的安全性 199
第5章 查询优化 200
5.1 使用索引 200
5.1.1 索引的优点 201
5.1.2 索引的代价 203
5.1.3 挑选索引 203
5.2 MySQL查询优化程序 206
5.2.1 查询优化程序的工作原理 207
5.2.2 使用EXPLAIN检查优化程序的操作 209
5.3 选择利于高效查询的数据类型 214
5.4 选择利于高效查询的表存储格式 216
5.5 高效加载数据 217
5.6 调度、锁定和并发 219
第6章 MySQL程序设计入门 221
6.1 为何要自己编写MySQL程序 221
6.2 MySQL提供的API 223
6.2.1 C语言API 224
6.2.2 Perl语言DBI API 224
6.2.3 PHP语言API 225
6.3 选择API 226
6.3.1 执行环境 227
6.3.2 性能 227
6.3.3 开发时间 228
6.3.4 可移植性 228
第7章 用C语言编写MySQL程序 230
7.1 编译和链接客户端程序 231
7.2 连接服务器 233
7.3 出错处理和命令选项处理 236
7.3.1 出错检查 236
7.3.2 实时获取连接参数 239
7.3.3 把选项处理整合进客户端程序 248
7.4 处理SQL语句 252
7.4.1 处理那些修改行的语句 253
7.4.2 处理那些返回结果集的语句 254
7.4.3 通用的语句处理器 256
7.4.4 另一种语句处理方法 257
7.4.5 mysql_store_result()与mysql_use_result()的对比 258
7.4.6 使用结果集元数据 260
7.4.7 对特殊字符和二进制数据进行编码 264
7.5 交互式语句执行程序 267
7.6 编写支持SSL的客户端程序 268
7.7 一次执行多条语句 272
7.8 使用服务器端预处理语句 273
7.9 使用预处理CALL支持 282
第8章 用Perl DBI编写MySQL程序 286
8.1 Perl脚本的特点 286
8.2 Perl DBI概述 287
8.2.1 DBI数据类型 287
8.2.2 一个简单的DBI脚本 288
8.2.3 出错处理 291
8.2.4 处理那些修改行的语句 294
8.2.5 处理那些返回结果集的语句 295
8.2.6 在语句串里引用特殊字符 302
8.2.7 占位符与预处理语句 305
8.2.8 把查询结果绑定到脚本变量 307
8.2.9 指定连接参数 307
8.2.10 调试 310
8.2.11 使用结果集元数据 312
8.2.12 执行事务 316
8.3 DBI脚本实践 317
8.3.1 生成美史联盟成员名录 317
8.3.2 发送成员资格更新通知 322
8.3.3 编辑美史联盟成员条目 326
8.3.4 寻找志趣相投的联盟成员 331
8.3.5 把美史联盟成员名录放到网上 332
8.4 使用DBI来开发Web应用程序 334
8.4.1 配置Apache服务器来处理CGI脚本 335
8.4.2 CGI.pm模块简介 336
8.4.3 从Web脚本连接MySQL服务器 342
8.4.4 基于Web的数据库浏览器 343
8.4.5 成绩考评项目:分数浏览器 347
8.4.6 美史联盟:搜索志趣相投的成员 350
第9章 用PHP语言编写MySQL程序 354
9.1 PHP概述 355
9.1.1 一个简单的PHP脚本 357
9.1.2 利用PHP库文件实现代码封装 359
9.1.3 简单的数据检索页面 363
9.1.4 处理语句结果 365
9.1.5 测试查询结果里的NULL值 368
9.1.6 使用预处理语句 369
9.1.7 利用占位符来处理数据引号问题 369
9.1.8 出错处理 371
9.2 PHP脚本实战 372
9.2.1 一个在线录入分数的应用程序 373
9.2.2 创建交互式的在线测验 382
9.2.3 在线编辑美史联盟成员信息 386
第10章 MySQL管理简介 393
10.1 MySQL组件 393
10.3 访问控制与安全性 395
10.4 数据库维护、备份和复制 395
第11章 MySQL数据目录 397
11.1 数据目录位置 397
11.2 数据目录结构 398
11.2.1 MySQL服务器提供的数据访问方式 399
11.2.2 数据库在文件系统里的表示 400
11.2.3 表在文件系统里的表示 400
11.2.4 视图和触发器在文件系统里的表示 401
11.2.5 SQL语句与表文件操作的对应关系 401
11.2.6 操作系统对数据库对象名字的约束 402
11.2.7 影响表最大长度的因素 403
11.2.8 数据目录结构对系统性能的影响 404
11.2.9 MySQL状态文件和日志文件 405
11.3 迁移数据目录的内容 407
11.3.1 迁移方法 407
11.3.2 迁移注意事项 408
11.3.3 评估迁移带来的影响 408
11.3.4 迁移整个数据目录 409
11.3.5 迁移单个数据库 409
11.3.6 迁移单个表 409
11.3.7 迁移InnoDB系统表空间 410
11.3.8 迁移状态文件和日志文件 410
第12章 MySQL的基本管理 412
12.1 保护新安装的MySQL 412
12.1.1 为初始的MySQL账户建立密码 413
12.1.2 为附加服务器设置密码 416
12.2 安排MySQL服务器的启动和关闭 416
12.2.1 在Unix里运行MySQL服务器 417
12.2.2 在Windows里运行MySQL服务器 420
12.2.3 指定服务器启动选项 422
12.2.4 控制服务器的连接监听 423
12.2.5 停止服务器 424
12.2.6 当你无法连接服务器时重新获得对它的控制 425
12.3 使用系统变量和状态变量 426
12.3.1 查看和设置系统变量值 427
12.3.2 查看状态变量值 430
12.4 插件接口 431
12.5 存储引擎配置 433
12.5.1 选择存储引擎 433
12.5.2 选择默认存储引擎 434
12.5.3 配置InnoDB存储引擎 435
12.6 全球化问题 440
12.6.1 配置时区支持 440
12.6.2 选择默认字符集和排序规则 441
12.6.3 选择出错信息的显示语言 442
12.6.4 选择区域设置 442
12.7 服务器调整 442
12.7.1 用于服务器调整的通用型系统变量 443
12.7.2 存储引擎调整 445
12.7.3 使用查询缓存 449
12.7.4 硬件优化 450
12.8 服务器日志 451
12.8.1 出错日志 453
12.8.2 普通查询日志 454
12.8.3 慢查询日志 454
12.8.4 二进制日志 455
12.8.5 中继日志 456
12.8.6 使用日志表 456
12.8.7 日志管理 457
12.9 运行多个服务器 462
12.9.1 运行多个服务器的常见问题 462
12.9.2 配置和编译不同的服务器 464
12.9.3 指定启动选项的策略 465
12.9.4 使用mysqld_multi来管理服务器 466
12.9.5 在Windows里运行多个服务器 468
12.9.6 运行多个服务器的客户端 469
12.10 升级MySQL 469
第13章 安全性与访问控制 471
13.1 保护对MySQL文件系统的访问 472
13.1.1 如何窃取数据 472
13.1.2 保护MySQL安装 473
13.2 管理MySQL用户账户 477
13.2.1 MySQL账户的高级管理 479
13.2.2 权限分配 482
13.2.3 显示账户权限 490
13.2.4 撤销权限 490
13.2.5 更改密码或重置丢失的密码 491
13.2.6 避免访问控制风险 491
13.2.7 插入式身份认证和代理用户 494
13.3 权限表结构和内容 496
13.3.1 权限表访问范围列 498
13.3.2 权限表权限列 498
13.3.3 权限表身份认证列 499
13.3.4 权限表SSL相关列 499
13.3.5 权限表资源管理列 500
13.4 服务器如何控制客户端访问 500
13.4.1 访问范围列的内容 500
13.4.2 语句访问验证 502
13.4.3 访问范围列匹配顺序 503
13.4.4 权限难题 503
13.5 使用SSL建立安全连接 506
第14章 数据库维护、备份和复制 510
14.1 预防性维护的基本原则 510
14.2 在服务器运行时维护数据库 511
14.2.1 为只读或读/写访问锁定单个表 512
14.2.2 为只读访问锁定所有数据库 514
14.3 基本的预防性维护 514
14.3.1 运用服务器的自动恢复功能 514
14.3.2 制订预防性维护计划 515
14.4 数据库备份 516
14.4.1 存储引擎的可移植特点 517
14.4.2 用mysqldump程序制作文本备份 518
14.4.3 制作二进制数据库备份 521
14.4.4 备份InnoDB表 522
14.5 将数据库复制到另一个服务器 522
14.5.1 使用备份文件来复制数据库 523
14.5.2 将数据库从一个服务器复制到另一个 523
14.6 检查和修复数据库表 524
14.6.1 使用CHECK TABLE检查表 525
14.6.2 使用REPAIR TABLE修复表 525
14.6.3 使用mysqlcheck检查修复表 525
14.7 使用备份来恢复数据 526
14.7.1 恢复整个数据库 527
14.7.2 恢复单个表 527
14.7.3 重新执行二进制日志文件里的语句 528
14.7.4 应对InnoDB的自动恢复问题 529
14.8 设置复制服务器 530
14.8.1 复制的工作原理 530
14.8.2 建立主从复制关系 531
14.8.3 二进制日志格式 533
14.8.4 使用复制从服务器来制作备份 534
附录A 本书所需要的各类软件 535
附录B 数据类型参考 543
附录C 操作符与函数参考 555
附录D 系统变量、状态变量和用户变量参考 608
附录E SQL语法参考 651
附录F MySQL程序参考 721
· · · · · · (收起)
读后感
这本书深度还是有的。 对查询相关的调优,所用的运用都有直观的说明。 感觉是,缺少了实际应用中关于集群架构上的说明。有些遗憾。。 请尊重创作者的劳动,勿提供下载信息、或转载他人的文章。 为了鼓励有益的分享, 少于50字的评论将在前页论坛里发表。 如果评论涉及电...
这本书深度还是有的。 对查询相关的调优,所用的运用都有直观的说明。 感觉是,缺少了实际应用中关于集群架构上的说明。有些遗憾。。 请尊重创作者的劳动,勿提供下载信息、或转载他人的文章。 为了鼓励有益的分享, 少于50字的评论将在前页论坛里发表。 如果评论涉及电...
这本书深度还是有的。 对查询相关的调优,所用的运用都有直观的说明。 感觉是,缺少了实际应用中关于集群架构上的说明。有些遗憾。。 请尊重创作者的劳动,勿提供下载信息、或转载他人的文章。 为了鼓励有益的分享, 少于50字的评论将在前页论坛里发表。 如果评论涉及电...
这本书深度还是有的。 对查询相关的调优,所用的运用都有直观的说明。 感觉是,缺少了实际应用中关于集群架构上的说明。有些遗憾。。 请尊重创作者的劳动,勿提供下载信息、或转载他人的文章。 为了鼓励有益的分享, 少于50字的评论将在前页论坛里发表。 如果评论涉及电...
这是一本很适合非专业DBA的攻城狮在阅读《高性能MySQL》前热身的书,如果仅仅是普通的MySQL开发,这本书已经够用了。 总体上看这是一本在实际开发中使用的“工具书”,偏于应用,有部分原理的解释,但并不深入,涵盖面广,基本上除了数据库三范式这类理论性的知...
用户评价
这本书拿到手里的时候,我就被它厚重的质感和严谨的排版所吸引。封面设计低调内敛,但信息量却不容小觑,一看就知道是能沉下心来啃硬骨头的技术宝典。我之前接触过一些MySQL的入门书籍,那些大多停留在SQL语法和基础概念层面,读完之后感觉对数据库的“骨架”和“血肉”依然模糊不清。这本书显然不是那种“速成”读物,它更像是一本深入骨髓的解剖手册,目标读者是那些真正想弄明白MySQL是如何在底层运作的工程师。我花了整整一个周末通读了前三章,发现作者对存储引擎的演变、事务隔离级别的实现原理,以及索引结构(尤其是B+树在磁盘I/O优化上的精妙设计)的剖析,简直是教科书级别的。很多平时工作中遇到的性能瓶颈问题,比如慢查询的优化,读完这些章节后,都能找到理论依据和解决方案的雏形。它没有过多纠缠于炫酷的新特性,而是把重点放在了“为什么是这样”和“如何更高效地利用它”这两个核心问题上。对于需要长期维护和深度调优生产环境的开发者来说,这种扎根于底层逻辑的讲解,远比浮于表面的功能罗列来得宝贵得多。
坦白讲,这本书的难度系数不低,如果抱着快速学习一门新技术的目的来翻阅,可能会感到吃力甚至沮丧。它要求读者对计算机底层原理,比如操作系统、网络通信,有一定的预备知识。但正是这种对基础知识的坚实要求,保证了书中所传授的知识的长期有效性和深度。它没有被过时的版本特性所困扰,而是致力于阐述那些跨越多个版本的核心设计哲学。我个人最欣赏的是它对性能调优的指导思想:先从宏观的系统资源瓶颈入手,再逐步下钻到SQL执行层的具体优化,最后回归到存储引擎的物理I/O层面。这种递进式的排障思路,完全颠覆了我过去那种“改个索引试试”的盲目试错法。这本书更像是一本武功秘籍,需要勤学苦练,但一旦练成,便能举一反三,应对各种复杂的数据库挑战,绝对是数据库技术人员书架上不可或缺的重磅参考资料。
对于我这种习惯于通过代码和源码来理解技术的工程师来说,这本书的叙述逻辑非常契合我的思维习惯。它不是那种充满华丽辞藻的理论堆砌,而是逻辑严密、层层递进的工程文档风格。它的图表绘制得极为精良,那些复杂的内存结构、内存与磁盘的交互流程,通过恰到好处的示意图,瞬间变得清晰起来。例如,在讲解Buffer Pool内部的LRU链表管理时,它不仅解释了如何淘汰脏页,还细致地分析了如何应对Buffer Pool中热点数据的频繁访问,引入了Midpoint Insertion Policy来平滑热点数据的回收过程。这种对细节的执着,让我感觉作者真的是花费了大量时间在MySQL的源码层面进行探索和验证,而不是简单的引用或翻译前人的资料。它提供了一种自上而下、又自下而上打通的技术视角,让读者能够真正建立起对数据库“黑匣子”内部的信任感和掌控感。
说实话,我对技术书籍的耐心是有限的,很多工具书读起来就像在嚼白开水,味同嚼蜡。然而,阅读这本关于MySQL内核的书籍,却带来了一种解谜的乐趣。它不仅仅是告诉你“这样做”会得到“那种结果”,而是详细描绘了MySQL服务器内部各个组件如何协同工作的完整流程图。比如,它对查询优化器生成执行计划的步骤进行了庖丁解牛般的拆解,从代价模型到谓词下推的决策过程,每一步的权衡利弊都阐述得淋漓尽致。我特别喜欢其中关于锁和并发控制那一块的叙述方式,它没有简单地罗列MVCC的三个版本,而是结合实际的Buffer Pool和Redo Log的工作机制,说明了快照读和当前读在不同场景下的实际开销和数据一致性保证。这种将理论与实践场景深度融合的写作手法,极大地降低了理解复杂概念的门槛。读完后,我不再满足于简单的`EXPLAIN`输出,而是开始思考查询优化器可能“误判”的场景,这无疑是将我的数据库技能提升到了一个新的维度。
我职业生涯中接触过不少声称“全面”的数据库技术书籍,但很多时候“全面”的结果就是“泛泛而谈”,重要的细节被一笔带过。但这本书的厉害之处在于,它在保证覆盖面的同时,对核心、高频出现的问题模块进行了极度细致的挖掘。我尤其想强调一下它在集群和高可用性方面的阐述,这部分内容是当前互联网架构中绕不开的痛点。作者没有仅仅停留在介绍主从复制的几种模式,而是深入到了基于Binlog的同步机制中,如何处理网络延迟、半同步复制的延迟补偿,以及Group Replication内部的Gossip协议和事务排序的细节。这些都是线上故障排查中经常遇到的“黑匣子”问题。通过阅读这些章节,我清晰地构建了一个高可用架构的完整视图,理解了为什么在某些极端情况下,同步机制可能导致数据丢失或系统停机。这种深度,对于架构师级别的角色来说,是决定性的优势。
前面两三章有点枯燥,坚持过去,读书的感觉就来了,后面内容入门且兼具深度。
非DBA读者,适合用来巩固概念
入门读物
偏向运维,读了部分章节1,2,3,5,11,14
看名字有点吓到,其实就是一本全面详细清晰易懂的手册,可以说是入门必读了