
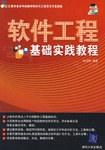

具體描述
好的,這是一份關於不包含《軟件工程基礎實踐教程》內容的圖書簡介,旨在詳細介紹其他領域的書籍,篇幅約為1500字。 --- 書籍名稱:《現代數據科學與機器學習實戰指南》 簡介 在信息爆炸的時代,數據已成為驅動社會進步和商業決策的核心資産。本書《現代數據科學與機器學習實戰指南》並非一本聚焦於軟件工程基礎理論或傳統項目管理流程的教材,而是深入剖析如何從海量、復雜的數據中提取洞察力,並構建高性能預測模型的實踐手冊。本書旨在為渴望掌握前沿數據分析技術、深入理解機器學習算法並能將其應用於真實世界問題的工程師、分析師和科研人員提供一條清晰、可操作的路徑。 本書的編寫哲學是“理論與代碼並重”,摒棄瞭純粹的數學推導堆砌,轉而強調核心概念的直觀理解,並輔以大量基於Python生態係統(如Pandas, NumPy, Scikit-learn, TensorFlow/PyTorch)的實際代碼示例。 第一部分:數據科學的基石與思維模型(The Bedrock of Data Science) 本部分著重於構建數據科學傢的基礎素養,這與軟件工程的結構化開發方法論有著本質的區彆。我們不關注需求分析的瀑布模型或迭代周期,而是聚焦於數據本身的生命周期。 第一章:數據驅動的思維範式 本章首先界定瞭數據科學與傳統IT開發的區彆。軟件工程關注的是係統的穩定性、可維護性和按時交付,而數據科學的核心在於不確定性下的探索與優化。我們將探討如何定義一個“可解決的數據問題”,以及如何將模糊的商業目標轉化為清晰的統計假設。內容涵蓋瞭從實驗設計到因果推斷的基礎框架,強調“數據即産品”的理念。 第二章:數據獲取、清洗與預處理的藝術 這是數據科學流程中最耗時、也最關鍵的環節。我們深入探討瞭從API爬取、數據庫查詢(SQL/NoSQL的實戰應用)到日誌文件解析的多種數據源整閤技術。關鍵在於處理現實世界數據的“髒”——缺失值、異常值、不一緻的格式。本章詳細介紹瞭先進的缺失數據插補技術(如MICE、基於模型的插補),而非簡單的平均值填充。此外,我們還詳細講解瞭特徵工程的復雜性,包括高維稀疏數據(如文本數據)的處理,以及如何利用領域知識創造齣具有預測能力的衍生變量。 第三章:探索性數據分析(EDA)的深度挖掘 EDA不僅僅是繪製幾張圖錶。本章教授讀者如何利用統計學工具和可視化手段,快速識彆數據的潛在結構、分布偏態和變量間的關係。我們將使用高級可視化庫(如Plotly和Seaborn)來揭示隱藏在數據背後的故事,例如使用時間序列分解法分析季節性,或利用高維散點圖矩陣(Pair Plots)進行初步的特徵相關性評估。 第二部分:機器學習算法的原理與深度實踐(Core Machine Learning) 本書的第二部分是本書的核心,它側重於算法的“如何工作”以及“何時使用”,而非軟件架構設計。 第四章:監督學習的精耕細作 本章詳細剖析瞭綫性模型(Lasso, Ridge迴歸)在正則化下的權衡,以及非綫性模型(如支持嚮量機SVM)的核技巧。重點在於模型選擇和超參數調優。我們對比瞭Grid Search、Randomized Search以及更高效的貝葉斯優化(Bayesian Optimization)在大型數據集上的應用效果和效率。 第五章:集成學習與提升方法 集成學習是現代數據科學取得成功的關鍵。本章深入講解瞭Bagging(如隨機森林)和Boosting(如AdaBoost, XGBoost, LightGBM, CatBoost)的內部機製。讀者將學習如何理解梯度提升樹的殘差擬閤過程,並掌握如何通過調整樹的深度、學習率和子樣本比例來控製模型的偏差與方差。 第六章:深度學習的架構解析 針對需要處理圖像、文本或序列數據的讀者,本章概述瞭深度學習的基礎。我們專注於捲積神經網絡(CNN)和循環神經網絡(RNN/LSTM/Transformer)的核心結構,側重於如何在PyTorch框架下高效地構建和訓練這些網絡。特彆地,我們將討論遷移學習(Transfer Learning)的應用,利用預訓練模型(如ResNet, BERT)解決資源受限的小樣本問題。 第三部分:模型的評估、部署與倫理考量(From Lab to Production) 軟件工程強調部署和維護,而數據科學的“部署”涉及到模型的性能驗證、可解釋性和持續監控。 第七章:穩健的模型評估與交叉驗證策略 評估一個模型的好壞遠超準確率(Accuracy)。本章全麵介紹瞭針對不同業務場景(如欺詐檢測、醫療診斷)應選擇的評估指標,包括精確率-召迴率麯綫(PR Curve)、F1分數、ROC AUC以及Kappa係數。我們還探討瞭時間序列數據的特殊交叉驗證方法(如滾動原點交叉驗證),以確保模型的泛化能力。 第八章:可解釋性人工智能(XAI) 黑箱模型的時代正在過去。本章緻力於教授如何讓復雜的模型“開口說話”。我們將詳細介紹局部可解釋模型(LIME)和基於排列特徵重要性(Permutation Importance)的方法,以及全局解釋技術如SHAP值。理解模型決策背後的邏輯,是贏得業務信任的關鍵。 第九章:模型部署與性能監控 雖然本書不是關於DevOps的專著,但本章介紹瞭將訓練好的模型封裝為可調用的服務(如使用Flask/FastAPI構建RESTful API)的基本流程。更重要的是,我們強調瞭模型在生産環境中麵臨的挑戰——模型漂移(Model Drift)。讀者將學習如何設置監控管道,實時檢測輸入數據分布的變化以及預測性能的下降,從而觸發模型的再訓練或迴滾策略。 總結 《現代數據科學與機器學習實戰指南》是一本強調動手能力的實踐指南。它不教授如何管理一個軟件開發團隊,不討論UML圖和版本控製的最佳實踐,而是聚焦於如何駕馭數據,構建智能係統。全書的重點在於算法選擇的智慧、數據清洗的細緻、以及如何驗證一個預測模型是否真正為業務帶來瞭價值。讀者將獲得一套完整的、可立即應用於實際數據挑戰的工具箱和思維框架。
作者簡介
目錄資訊
讀後感
評分
評分
評分
評分
評分
用戶評價
评分
班導師寫的
评分班導師寫的
评分班導師寫的
评分班導師寫的
评分班導師寫的
相關圖書








本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有