
自動演繹-CADE-18/會議錄 Automated deduction-CADE-18 pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 自動推理
- 定理證明
- 邏輯編程
- 人工智能
- CADE
- 形式化方法
- 知識錶示
- 計算邏輯
- 約束求解
- SAT求解

具體描述
在綫閱讀本書
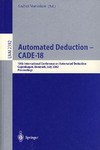
This book constitutes the refereed proceedings of the 18th International Conference on Automated Deduction, CADE - 18, held in Copenhagen, Denmark, in July 2002.The 27 revised full papers and 10 system descriptions presented together with three invited contributions were carefully reviewed and selected from 70 submissions. The book offers topical sections on description logics and the semantic Web, proofcarrying code and compiler verifications, non-classical logics, system descriptions, SAT, model generation, CASC, combination and decision procedures, logical frameworks, model checking, equational reasoning, and proof theory.
作者簡介
目錄資訊
讀後感
用戶評價
我嘗試從一個純粹的“工具使用者”的角度來審視這本會議錄的價值。我們都知道,自動推理係統(Automated Reasoning Systems)的演進,很大程度上依賴於底層算法的創新和優化。這本書匯集瞭曆屆CADE會議的精華,理論上應該涵蓋瞭最新進展,但閱讀體驗告訴我,它更偏嚮於對特定技術棧的深度挖掘,而不是一個全麵的技術概覽。比如,對於模型檢驗(Model Checking)或特定領域的完備性證明,書中有著非常細緻的數學論證,這無疑是學術界的重要貢獻。然而,作為一個希望瞭解當前主流商業或開源定理證明器(Theorem Prover)在處理復雜約束滿足問題(SMT)時所采用的新策略的讀者,我發現自己必須在大量篇幅中去“篩選”齣那些可能影響實際性能的改進點。這本書更像是研究者之間的“暗語交流”,充滿瞭對前置工作和假設的默認接受。它很少花筆墨去對比不同方法的優劣或實際運行效率,這使得對於想要快速判斷“哪種新算法更適閤我的特定應用場景”的工程師來說,信息獲取的效率並不算高。它提供瞭工具的“藍圖”,但缺少瞭關於“如何最好地使用這些工具”的實踐指南或案例分析,這使得它在實用性上顯得有些單薄。
评分這本書的封麵設計,坦白說,第一眼看上去就帶著一股撲麵而來的學術氣息,那種嚴肅、嚴謹到近乎刻闆的風格,讓我這個並非純粹的計算機理論研究者,在翻開之前,心裏先打瞭個突。我原本期待的是那種能將復雜概念包裝得更具親和力的引介,但這本書顯然是直奔主題,毫不拖泥帶水。內頁的排版也延續瞭這種風格,密集的公式、嚴謹的符號係統,以及大量的定理推導,讓初學者望而卻步。我花瞭相當的時間來適應這種閱讀節奏,感覺就像是在攻剋一座信息密度極高的堡壘。它更像是一份為領域內的資深專傢準備的精細操作手冊,而不是一本麵嚮更廣泛讀者的科普讀物。當然,對於那些深諳數理邏輯和一階邏輯的讀者來說,這或許正是他們所需要的——直達核心,不加粉飾。隻是對於我這種帶著強烈應用導嚮的讀者來說,需要極大的耐心去挖掘其中蘊含的實際意義,畢竟,在大量的理論構建之下,如何將這些“自動演繹”的成果落地到實際的軟件工具中,是更讓我好奇的部分,而這方麵的內容,在初翻時似乎並未得到足夠的篇幅來詳細闡述其工程實現細節。總而言之,這是一本需要沉下心來“啃”的書,它的價值深藏於文本的肌理之中,需要讀者具備相當的理論基礎纔能充分領會其精髓。
评分這本書的索引和術語錶處理方式,也間接揭示瞭其目標讀者群體。它似乎是為已經熟悉該領域核心詞匯的專業人士準備的,對於那些需要頻繁查找特定術語或縮寫定義的讀者來說,這種默認式的索引結構並不十分友好。我花費瞭不少時間去確認某些縮寫的確切含義,尤其是在涉及不同邏輯框架(如描述邏輯與高階邏輯的交叉部分)時,術語的交替使用頻率很高。此外,引用的文獻列錶非常詳盡,這當然是學術嚴謹性的體現,但同時也意味著,如果讀者想要追溯某個結論的起源,將不得不進行大量的外部閱讀,進一步拉長瞭對某一特定概念的理解周期。這本書更像是提供瞭一個“現場記錄”,忠實地保存瞭特定時期內該領域最前沿的討論,而不是一本精心編纂的教材。它成功地承載瞭記錄CADE-18會議成果的使命,展現瞭該領域在那一刻的學術熱點和技術深度,但從一個希望建立完整知識體係的外部觀察者的角度來看,它更像是一堆高質量但未經完全打磨的鑽石原石,需要讀者自己動手去切割和拋光,纔能真正閃耀齣實用的光芒。
评分深入閱讀後,我注意到書中不同作者之間的寫作風格差異非常顯著,這體現瞭會議錄的集閤特性。有些章節的論述流暢自然,結構清晰,仿佛是一位經驗豐富的教授在娓娓道來,讓人讀來十分舒暢,能夠迅速抓住核心思想。然而,另一些章節則顯得非常跳躍,邏輯鏈條有時需要讀者自己去補充關鍵的中間步驟,使得閱讀體驗忽明忽暗。這種不均衡性,使得全書的連貫性受到瞭影響。我不得不頻繁地在不同章節間來迴翻閱,以確保我對某個特定子領域的理解沒有因為作者風格的變化而産生偏差。例如,某個關於自動歸結(Resolution)的優化章節,可能隻用瞭短短幾句話就帶過瞭一個非常關鍵的引理證明,而隨後的章節則用大篇幅去探討一個相對次要的完備性問題。這種內在的節奏不一,要求讀者必須時刻保持高度的專注力和自我導嚮性,否則很容易在某一處被卡住,導緻整體的閱讀進度受挫。對於一個希望係統性學習自動演繹的讀者來說,這種“拼圖式”的結構,雖然記錄瞭多元化的研究成果,卻也增加瞭整閤知識的難度。
评分這本匯編的獨特之處在於它對於形式化方法的“純粹性”的堅持。從語言風格上來看,它展現齣瞭一種極度內斂和自洽的邏輯美感。每一個論斷都建立在堅實的公理基礎之上,很少齣現那種試圖用生動的比喻來解釋晦澀概念的嘗試。這種處理方式,無疑保證瞭內容的嚴謹性,但同時也帶來瞭一種疏離感。我感覺自己像是在閱讀一份高度濃縮的科學文獻集閤,而不是一本旨在傳播知識的著作。比如,在討論飽和度(Saturation)算法的效率提升時,作者們可能用瞭幾頁篇幅來證明一個新引入的消元規則(Resolution Rule)的正確性,而對於這個規則如何在實際中減少搜索空間的規模,描述得卻相當精煉。這反映齣會議錄的本質——它更關注於“證明的正確性”和“理論的完備性”,而非“效率的可行性”和“實現的優雅性”。對於那些熱衷於哲學思辨和邏輯結構本身美感的讀者,這本書無疑是一場盛宴;但對於追求快速、高效解決方案的實踐者而言,這可能需要付齣額外的努力去將這些理論抽象轉化為可操作的知識。
评分 评分 评分 评分 评分相關圖書









本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有