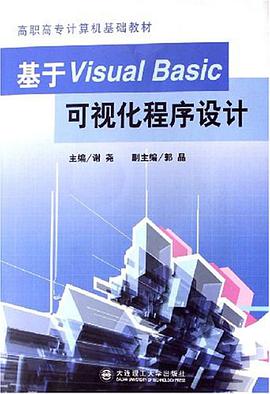

具体描述
前言
第1章 Visual Basic基础
第2章 窗体与基本控件
第3章 Visual Basic程序设计基础
第4章 常用控件
第5章 菜单设计
第6章 文件管理
第7章 图形
第8章 多文档界面
第9章 数据库管理
第10章 应用程序的发布
附录I 学生学籍及成绩管理系统
附录II 二手房置换管理信息系统
图书信息: 书名: 深入理解数据结构与算法:从理论到实践 作者: 张伟 著 出版社: 电子工业出版社 出版日期: 2023年10月 ISBN: 978-7-121-XXXX-X --- 深入理解数据结构与算法:从理论到实践 (图书简介) 导言:构建高效软件的基石 在当今信息技术飞速发展的时代,软件的性能和效率已经成为衡量其质量的关键指标。无论是支撑万亿级交易的金融系统,还是处理海量数据的科学计算平台,其底层的效率往往取决于所采用的数据结构和算法设计。然而,许多初学者或经验不足的开发者常常停留在“能跑就行”的阶段,对数据结构和算法的深刻理解有所欠缺,这使得他们在面对复杂的性能瓶颈和大规模数据挑战时显得力不从心。 本书《深入理解数据结构与算法:从理论到实践》,正是在这样的背景下应运而生。它并非一本枯燥的理论汇编,而是一本旨在帮助读者真正掌握计算机科学核心思想,并将这些思想转化为高效代码的实践指南。我们聚焦于如何选择、设计和实现最优的数据结构与算法,以应对现实世界中千变万化的工程需求。 第一部分:理论基础的夯实与精炼 本书的开篇部分,将数据结构与算法的基础知识进行了系统性的梳理和提炼,确保读者拥有坚实的理论基础,避免了传统教材中冗长繁琐的数学推导,而是强调核心概念的直观理解和工程意义。 1. 复杂度分析的深度剖析: 我们详细讲解了时间复杂度和空间复杂度,不仅仅停留在“大O表示法”的表面,而是深入探讨了最好、最坏和平均情况下的复杂度分析,以及如何通过精确的性能度量工具来验证算法的实际表现。尤其侧重于尾递归优化、常数因子对实际运行时间的影响等工程细节。 2. 线性结构的精妙运用: 数组和链表是编程的基石。本书不仅涵盖了单链表、双向链表和循环链表的实现,更着重探讨了它们在内存管理、缓存命中率(Cache Locality)方面的差异及其对现代CPU性能的影响。我们还用专门章节讨论了动态数组(如`ArrayList`或`std::vector`)的扩容策略及其摊还分析。 3. 栈、队列与递归: 栈和队列作为操作系统的基础组件,本书通过模拟函数调用栈、表达式求值(中缀转后缀/前缀)以及实现广度优先搜索(BFS)等经典应用场景,展示了其核心价值。递归部分则侧重于理解递归的本质、如何识别尾递归,以及如何通过迭代(消除递归)来规避栈溢出风险,同时保持代码的简洁性。 第二部分:非线性结构的优化之道 非线性数据结构是解决复杂关系问题的关键。本部分将重点放在如何利用树和图的特性,实现高效的数据检索、管理和路径规划。 4. 树结构的高效实现: 从基础的二叉树遍历(前序、中序、后序、层序)入手,本书迅速过渡到平衡二叉搜索树(AVL树和红黑树)。我们用图文并茂的方式解释了旋转操作的机制,重点分析了红黑树的五条性质以及它们如何确保对数时间复杂度的查找、插入和删除操作。此外,B树和B+树在数据库索引中的应用将被详细剖析,揭示其底层设计哲学。 5. 堆结构与优先队列: 堆(Heap)作为实现优先队列的有效工具,其最大堆和最小堆的构建过程将被细致讲解。我们探讨了使用堆进行堆排序(Heap Sort)的稳定性分析,以及堆结构在实现Dijkstra最短路径算法和Prim最小生成树算法中的关键作用。 6. 图论的算法实践: 图结构是网络、社交关系、地理信息系统的核心。本书系统介绍了图的表示方法(邻接矩阵与邻接表)的选择标准。核心算法部分,我们不仅讲解了深度优先搜索(DFS)和广度优先搜索(BFS)的实现与应用,还深入讲解了拓扑排序、连通分量识别、以及最核心的最短路径算法家族(Dijkstra、Bellman-Ford、Floyd-Warshall)的适用场景和性能权衡。 第三部分:高级主题与算法设计范式 真正的工程挑战往往需要超越基本数据结构的范畴,本书的后半部分专注于介绍解决复杂问题的通用算法设计范式。 7. 排序算法的性能对比与调优: 我们不仅实现了经典的冒泡、插入、选择排序,更重点分析了快速排序(Quick Sort)和归并排序(Merge Sort)的原理和稳定性。特别是针对快速排序,本书会深入探讨“基准选择”(Pivot Selection)对性能的巨大影响,并提供如何使用“三数取中法”等策略来规避最坏情况的实践建议。最后,会介绍如何利用这些排序算法的思想实现外部排序(External Sorting)。 8. 动态规划(DP)的艺术: 动态规划被誉为“算法的皇冠”。本书将DP解题思路分解为“状态定义、状态转移方程、边界条件”三步法。通过背包问题、最长公共子序列、矩阵链乘法等经典案例,帮助读者建立对“最优子结构”和“重叠子问题”的深刻认识,并演示如何从记忆化搜索(自顶向下)转向表格填充(自底向上)的优化过程。 9. 贪心算法与分治策略: 对于贪心算法,我们着重分析其“局部最优是否能导向全局最优”的证明方法,并通过活动安排问题、霍夫曼编码等实例加深理解。分治策略(如二分查找的推广应用、Strassen矩阵乘法)则被用来展示如何通过递归地将大问题分解为小问题来提高效率。 10. 散列表(哈希表)的深入探究: 散列表因其平均$O(1)$的查找效率而成为应用最广泛的数据结构之一。本书详细解析了哈希函数的设计原则(如何均匀分布),并重点对比了处理冲突的几种主要方法:链地址法(Separate Chaining)和开放定址法(Open Addressing,包括线性探测、二次探测和双重哈希)。此外,我们还会讨论负载因子(Load Factor)对性能的影响以及散列表的重哈希(Rehashing)机制。 结语:面向未来的代码质量 《深入理解数据结构与算法:从理论到实践》的最终目标是培养读者的“算法思维”。我们相信,只有真正理解了底层的数据组织方式和处理逻辑,才能在面对新技术浪潮时,快速构建出既能满足功能需求,又具备卓越性能的健壮系统。本书的所有代码示例均采用现代化的编程语言实现,侧重于代码的清晰度、可读性以及与实际工程环境的贴合度,是软件工程师、系统架构师以及计算机专业学生提升核心竞争力的必备参考书。