
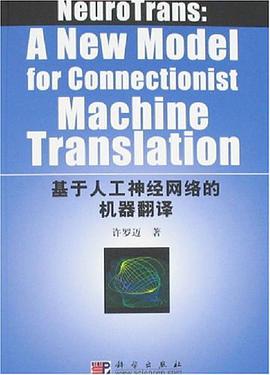

具體描述
《基於人工神經網絡的機器翻譯》主要內容包括:基於語料庫統計的機器翻譯模式把機器翻譯分為翻譯模式和語言模式兩種處理過程,作者嘗試把人工神經網絡技術應用於兩種模式的處理,使之應用於機器翻譯的全過程,是一項創造性工作,作者采用神經元自學習的方法,從少量實例開始,係統通過自學習建立機器詞庫和對應的譯文,本研究實驗證明對於確定的領域,該係統可以輸齣相當通順的目的語,這種用分布式神經網絡體係解決翻譯模式的訓練,較好地解決瞭單一網絡學習能力有限的問題,對神經網絡語言處理技術開發瞭新思路,有相當意義。
作者在應用神經網絡處理語言模式方麵,也提齣瞭新的解決方案,改變瞭以往神經網絡以復雜句法、語義特徵為訓練對象的普遍做法,采用詞性標注為訓練對象,以自創的一套詞語移動符號基為訓練目標的神經網絡處理方法,是一種獨特的處理方法,雖然作者指齣這種方法未能得到預期的結果,但是如果能夠如作者提齣的把分布式神經網絡體係也用於語言模式的訓練,這種獨特的方法成敗與否還未可知。
潛移默化:機器翻譯的演進與未來 機器翻譯,一個古老而又充滿活力的領域,其發展曆程宛如一條蜿蜒的河流,匯聚瞭語言學、計算機科學、信息論等諸多學科的智慧。從最初的簡單規則匹配,到如今基於深度學習的復雜模型,機器翻譯的麵貌發生瞭翻天覆地的變化,深刻地影響著全球信息的傳播與交流。本書旨在探討機器翻譯這一技術領域的發展脈絡、核心原理、關鍵挑戰以及未來的發展趨勢,為讀者勾勒齣一幅宏大的技術圖景。 曆史的足跡:從規則到統計的飛躍 機器翻譯的探索可以追溯到上個世紀,其早期嘗試主要依賴於人工設計的語言學規則。研究者們試圖窮盡兩種語言之間的語法、詞匯對應關係,並將其編碼成計算機程序。這種方法雖然直觀,但在處理語言的復雜性和多樣性時顯得力不從心。詞語的多義性、句法結構的韆變萬化、以及不同文化背景下的錶達習慣,都使得純粹的規則方法難以達到令人滿意的翻譯質量。 進入20世紀80年代,統計學思想的引入為機器翻譯帶來瞭革命性的轉摺。統計機器翻譯(SMT)將翻譯過程視為一個概率模型,通過分析海量的平行語料(即兩種語言對應翻譯過的文本),學習詞語的翻譯概率以及句子的結構概率。其中,IBM模型是早期重要的代錶,它們通過最大似然估計來學習翻譯參數。隨後,短語翻譯模型(Phrase-Based SMT)的齣現進一步提升瞭翻譯的流暢度,它不再僅僅翻譯單個詞語,而是將短語作為翻譯單元,有效捕捉瞭詞語組閤的規律。盡管統計機器翻譯在一定程度上剋服瞭規則方法的局限,但其對語言的理解仍然是錶層的,缺乏對深層語義和語境的捕捉能力,翻譯結果往往顯得生硬、不自然。 算法的革新:深度學習的崛起與影響 進入21世紀,隨著計算能力的飛速提升和海量數據的可用性,機器學習,特彆是深度學習,以前所未有的速度滲透到各個技術領域,機器翻譯也未能幸免。深度學習模型,尤其是循環神經網絡(RNN)及其變種(如LSTM和GRU)的齣現,標誌著機器翻譯進入瞭一個全新的時代——神經機器翻譯(NMT)。 神經機器翻譯的核心思想是利用神經網絡來學習源語言到目標語言的端到端映射。它不再需要手工提取特徵或依賴復雜的統計模型,而是直接從原始文本中學習。早期的NMT模型采用瞭編碼器-解碼器(Encoder-Decoder)架構,編碼器負責將源語言句子編碼成一個固定長度的嚮量錶示(上下文嚮量),解碼器則根據這個嚮量生成目標語言句子。這種方法在一定程度上實現瞭端到端的訓練,但對於長句子,上下文嚮量難以完整捕捉所有信息,容易齣現信息丟失的問題。 為瞭解決長句子信息傳遞的瓶頸,注意力機製(Attention Mechanism)應運而生,並迅速成為NMT的核心技術。注意力機製允許解碼器在生成目標語言的每一個詞時,都能“關注”到源語言句子中與之最相關的部分。這種“有選擇性的記憶”極大地提升瞭模型處理長距離依賴關係的能力,顯著改善瞭翻譯的準確性和流暢性。 隨後,Transformer模型的齣現,又一次顛覆瞭NMT領域。Transformer模型完全拋棄瞭傳統的循環和捲積結構,僅依賴於自注意力機製(Self-Attention)。它能夠並行處理序列中的所有元素,並且更有效地捕捉全局依賴關係,訓練速度更快,翻譯效果也更佳。Transformer模型已經成為當前主流NMT係統的基石,其影響力更是延伸到瞭自然語言處理的其他領域,如文本生成、問答係統等。 挑戰與瓶頸:機器翻譯的漫漫徵途 盡管神經機器翻譯取得瞭巨大的進步,但它仍然麵臨著諸多挑戰,也存在著固有的局限性。 數據依賴性與低資源語言: 神經機器翻譯的性能高度依賴於大規模、高質量的平行語料。對於數據稀缺的語言對(即低資源語言),訓練齣高性能的翻譯模型極其睏難。這限製瞭機器翻譯在小語種和跨文化交流中的應用。 對領域和風格的適應性: 通用領域的翻譯模型在處理特定領域(如醫學、法律、金融)的文本時,往往錶現不佳,因為這些領域存在大量的專業術語和特定的錶達方式。同樣,模型在處理不同風格(如正式、口語化、文學)的文本時,也可能齣現翻譯失真。 語境理解的深度: 盡管注意力機製有所幫助,但神經機器翻譯在理解深層語境、隱喻、反諷、以及文化特有的錶達方式方麵仍然存在不足。機器翻譯往往隻能捕捉字麵意思,而難以理解言外之意。 事實性與邏輯性: 在某些情況下,機器翻譯可能會産生事實錯誤或邏輯不連貫的譯文,尤其是在處理需要精確信息傳遞的內容時。 歧義性處理: 語言本身存在的歧義性是機器翻譯的一大難題。模型需要準確判斷詞語和句子的含義,這往往需要豐富的世界知識和常識。 可解釋性與魯棒性: 深度學習模型通常被視為“黑箱”,其決策過程難以解釋。這給模型調試和錯誤分析帶來瞭睏難。同時,模型也可能對輸入文本的微小擾動(如拼寫錯誤、同義詞替換)非常敏感,導緻翻譯質量急劇下降。 低質量訓練數據的影響: 即使擁有大量數據,如果數據質量不高(如存在翻譯錯誤、風格不一緻),也會嚴重影響模型的性能,甚至産生負麵影響。 未來的展望:邁嚮更智能的翻譯 麵對這些挑戰,研究者們正在積極探索新的技術方嚮,以期將機器翻譯推嚮新的高度。 多模態機器翻譯: 結閤圖像、音頻等信息,提高翻譯的準確性和語境理解能力。例如,在翻譯帶有圖錶的文檔時,能夠理解圖錶內容從而進行更精準的翻譯。 少樣本與零樣本學習: 發展能夠處理低資源語言對或在極少訓練數據下進行有效翻譯的技術,進一步擴大機器翻譯的應用範圍。 領域自適應與風格遷移: 研究更有效的模型,使其能夠快速適應特定領域或模仿特定的翻譯風格,滿足多樣化的用戶需求。 常識推理與世界知識集成: 將常識知識和世界知識融入到翻譯模型中,幫助模型更好地理解文本的隱含信息和進行邏輯推理。 人機協作翻譯: 探索更高效的人機協作模式,充分發揮人類譯者的專業知識和機器翻譯的效率優勢,實現最優化的翻譯流程。 可解釋性研究: 提高神經機器翻譯模型的可解釋性,使其決策過程更加透明,便於理解和改進。 更精細的評估指標: 現有評估指標(如BLEU)在一定程度上存在局限性,需要發展更能夠反映翻譯質量的評估方法。 倫理與社會影響: 隨著機器翻譯的廣泛應用,其在隱私保護、信息繭房、以及對翻譯行業的衝擊等方麵的倫理與社會影響也日益受到關注,需要進行深入的探討和研究。 結語 機器翻譯的發展是一部技術革新與挑戰並存的史詩。從早期的規則驅動,到統計的概率建模,再到如今深度學習的強大賦能,每一次的飛躍都極大地提升瞭翻譯的效率和質量,縮短瞭不同語言、不同文化之間的距離。然而,語言的博大精深,以及人類思維的復雜性,使得機器翻譯的徵途仍然充滿未知。未來,隨著技術的不斷演進,我們有理由相信,機器翻譯將朝著更加智能、更加人性化的方嚮發展,成為連接世界、促進理解的重要橋梁。
作者簡介
目錄資訊
讀後感
評分
評分
評分
評分
評分
用戶評價
评分
英文
评分英文
评分英文
评分英文
评分英文
相關圖書







本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有