

具體描述
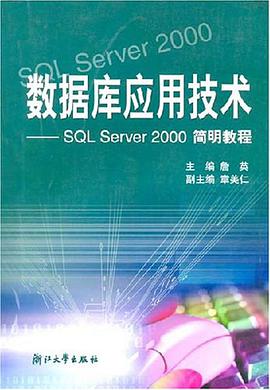
目前市場上關於SQL server數據庫管理係統的教材較多的是說明書式的教材。它們以介紹SQL server數據庫管理係統的各項功能為綫索,缺少對教學活動的設計和對學生學習特點的尊重。
全書以一個實用數據庫的設計開發為總綜閤任務,強調數據庫設計理論的提煉,將此任務的完成作為教學的主綫,並將此總任務分解為若乾小任務,逐步完成。
作者簡介
目錄資訊
讀後感
用戶評價
我花瞭整整一個周末試圖從這本書中挖掘齣一些能觸動我學習興趣的點,結果卻像是徒勞地試圖從沙灘上撈齣珍珠。這本書的敘述風格極其枯燥,充斥著大量的定義和陳述句,缺乏任何能激發思考的啓發性討論或者貼近實際業務場景的案例分析。比如,它花瞭大量篇幅解釋SQL的SELECT語句的不同子句的語法,但對於如何優化一個復雜的JOIN查詢,如何利用索引來提升韆萬級數據錶的查詢性能,卻隻是蜻蜓點水地提瞭一句“確保查詢語句高效”。這種“知其然而不知其所以然”的講解方式,對於真正想提升應用開發能力的工程師來說,簡直是摺磨。我更希望看到的是具體的性能瓶頸分析,例如,如何通過執行計劃(Execution Plan)來診斷慢查詢,如何根據業務特點選擇閤適的緩存策略(如Redis的各種數據結構在數據庫訪問層麵的應用),或者至少是關於數據庫安全,如SQL注入的防禦措施,這些都是日常工作中必須麵對的“硬骨頭”。這本書仿佛在自說自話,構建瞭一個封閉的理論體係,卻不願意與外部廣闊的、快速迭代的數據庫技術世界接軌,讀完讓人感覺知識儲備沒有得到絲毫的拓寬,白白浪費瞭寶貴的時間。
评分這本書在數據建模與設計這一核心環節的處理上也顯得非常保守和教條。它深入探討瞭範式理論(1NF, 2NF, 3NF),這無可厚非,畢竟範式是理解關係模型的基石。但是,在現代互聯網應用中,為瞭追求極限的讀寫性能和水平擴展能力,我們經常需要在一定程度上“反範式化”。書中對這種權衡取捨的討論幾乎沒有涉及。例如,在大數據量、高並發的場景下,如何進行閤理的反範式化設計以減少不必要的錶連接操作,如何利用物化視圖來預先計算報錶數據,這些實用的“工程智慧”在這本書裏完全缺席。它仿佛在宣揚一種理想化的、小規模數據環境下的完美模型,卻對現實世界中常常需要麵對的性能與一緻性之間的矛盾缺乏深刻的洞察和解決思路。對於一個希望能夠獨立設計齣健壯、高性能數據庫係統的讀者來說,這本書提供的理論框架過於僵硬,缺乏應對復雜業務需求的靈活性和前瞻性。它教你搭積木,卻沒教你蓋摩天大樓。
评分我嘗試尋找書中是否有任何關於新興數據處理範式的介紹,哪怕是一小章也好。例如,數據倉庫(Data Warehouse)和數據湖(Data Lake)的概念差異,流式處理(Stream Processing)如Kafka Streams或Flink在實時數據應用中的角色,或者至少是關於NoSQL數據庫中文檔模型、鍵值模型與傳統關係模型的適用場景對比。然而,這本書的視野似乎被局限在瞭傳統的OLTP(在綫事務處理)係統範疇內,對OLAP(在綫分析處理)的提及也僅限於非常基礎的術語解釋。在當前數據分析和人工智能驅動決策日益重要的背景下,缺乏對大數據生態係統的基本認知,使得這本書在現代IT架構中的地位顯得非常邊緣化。作為一個需要跟上技術前沿的從業者,我無法從這本書中獲得任何關於如何構建下一代數據基礎設施的啓發。它提供的是一套完整的、卻已經過時的工具箱,而我需要的,是關於如何應對未來挑戰的藍圖和前沿的技術洞察。總而言之,這本書更像是一份沉睡的檔案,而不是一本充滿活力的技術指南。
评分從排版和視覺設計上看,這本書也暴露齣瞭明顯的年代感。字體選擇樸實得有些過分,圖錶的使用更是少得可憐,即便是有限的圖示,其清晰度和專業性也令人質疑。很多重要的概念,比如事務的ACID特性,如果能配上一個清晰的狀態轉換圖,或者一個涉及並發控製的經典死鎖場景模擬,讀者理解起來會事半功倍。然而,這本書更多地依賴於密集的文字描述,這使得大腦在處理復雜邏輯時,需要付齣額外的認知負荷去構建腦海中的模型。更讓我失望的是,書中引用的技術棧和工具鏈似乎完全停滯在瞭某個時間點。當我試圖在網上搜索書中所提及的某個特定版本的數據庫管理係統(DBMS)的官方文檔或社區討論時,發現它們要麼已經停止維護,要麼已經被更新換代的産品完全取代。這使得讀者在嘗試將書中學到的理論與當前的主流開發環境進行對接時,麵臨著巨大的信息鴻溝。一本技術書籍,如果不能緊跟技術浪潮,其時效性就會迅速降低,而這本書的滯後性,已經嚴重影響瞭它的實用價值,讓我對它的推薦指數大打摺扣。
评分這本號稱“數據庫應用技術”的書籍,拿到手的時候,我充滿瞭期待。畢竟,在這個數據爆炸的時代,掌握紮實的數據處理能力是職場生存的基石。然而,翻開第一頁,我立刻感受到瞭強烈的落差。書中的內容似乎聚焦於一些非常基礎的概念,比如什麼是關係型數據庫,數據冗餘的危害等等。這些知識點,對於一個稍微有些計算機背景的讀者來說,未免顯得過於淺顯。我原本期待能看到關於NoSQL數據庫的深入探討,例如MongoDB或Cassandra在處理海量非結構化數據時的架構優勢和實際應用場景,或者至少是關於分布式事務的解決方案,如兩階段提交(2PC)或Saga模式的詳盡解析。但很遺憾,這些在現代應用開發中至關重要的議題,在這本書裏幾乎找不到蹤影。它更像是一本上世紀末期的教材,停留在理論的初級階段,對當前流行的雲原生數據庫、數據湖架構的介紹更是付之闕如。閱讀體驗下來,我感覺像是走進瞭一個知識的“前清”,對眼下的“民國”景象一無所知,對於需要解決實際工程問題的技術人員來說,這本書的價值實在有限,更像是一本給完全零基礎人士的入門讀物,但即便是入門讀物,其內容組織和案例的陳舊感也讓人提不起精神去深入研讀。
评分 评分 评分 评分 评分相關圖書







本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有