
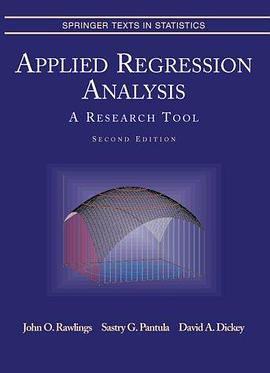
Applied Regression Analysis pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 應用迴歸分析
- 學習
- statistics
- E
- 迴歸分析
- 統計學
- 數據分析
- 計量經濟學
- 應用統計
- 綫性模型
- 統計建模
- 預測
- 數據挖掘
- 統計推斷

具體描述
Least squares estimation, when used appropriately, is a powerful research tool. A deeper understanding of the regression concepts is essential for achieving optimal benefits from a least squares analysis. This book builds on the fundamentals of statistical methods and provides appropriate concepts that will allow a scientist to use least squares as an effective research tool. This book is aimed at the scientist who wishes to gain a working knowledge of regression analysis. The basic purpose of this book is to develop an understanding of least squares and related statistical methods without becoming excessively mathematical. It is the outgrowth of more than 30 years of consulting experience with scientists and many years of teaching an appied regression course to graduate students. This book seves as an excellent text for a service course on regression for non-statisticians and as a reference for researchers. It also provides a bridge between a two-semester introduction to statistical methods and a thoeretical linear models course. This book emphasizes the concepts and the analysis of data sets. It provides a review of the key concepts in simple linear regression, matrix operations, and multiple regression. Methods and criteria for selecting regression variables and geometric interpretations are discussed. Polynomial, trigonometric, analysis of variance, nonlinear, time series, logistic, random effects, and mixed effects models are also discussed. Detailed case studies and exercises based on real data sets are used to reinforce the concepts. John O. Rawlings, Professor Emeritus in the Department of Statistics at North Carolina State University, retired after 34 years of teaching, consulting, and research in statistical methods. He was instrumental in developing, and for many years taught, the course on which this text is based. He is a Fellow of the American Statistical Association and the Crop Science Society of America. Sastry G. Pantula is Professor and Directory of Graduate Programs in the Department of Statistics at North Carolina State University. He is a member of the Academy of Outstanding Teachers at North Carolina State University. David A. Dickey is Professor of Statistics at North Carolina State University. He is a member of the Academy of Outstanding Teachers at North Carolina State University.
作者簡介
目錄資訊
讀後感
用戶評價
這本《應用迴歸分析》著實讓我眼前一亮,作為一名在數據分析領域摸爬滾打瞭多年的老兵,我總覺得市麵上那些理論性太強,或者案例過於陳舊的書籍,難以真正指導我在實際項目中應對那些錯綜復雜的現實問題。然而,這本書的齣現仿佛一股清流。它並沒有一開始就陷入那些繁復的數學推導,而是巧妙地從實際業務場景齣發,引導我們思考“為什麼需要迴歸分析”,以及“在特定情境下,哪種模型纔是最優解”。我尤其欣賞作者對於模型假設檢驗的講解方式,不再是冷冰冰的公式堆砌,而是用大量的圖示和生動的比喻,將那些抽象的統計學概念具象化。比如,在討論多重共綫性時,作者引入瞭一個關於市場營銷投入的經典案例,清晰地展示瞭變量間相互糾纏帶來的估計偏差,並提供瞭多種行之有效的診斷和修正方法。對於初學者而言,這本書提供瞭堅實的理論基石,對於有經驗的從業者來說,它更像一本隨時可以查閱的“故障排除手冊”,幫我們快速定位問題所在,並給齣可操作的解決方案。它教會我的不僅是如何“跑模型”,更是如何“用模型”來驅動決策。
评分說實話,我原本以為這又是一本在統計軟件操作上大做文章的工具書,畢竟現在很多教材都把重點放在瞭R或Python的代碼實現上。但《應用迴歸分析》的格局顯然要大得多。它的核心魅力在於構建瞭一種批判性的思維框架。書中大量篇幅被用來討論模型的選擇、殘差的診斷以及如何解釋係數的實際意義,這些往往是新手在實戰中一敗塗地的地方。我記得有一次我用一個看似擬閤度很高的模型去預測一個非綫性的市場波動,結果實際效果慘不忍睹。後來翻閱此書,纔猛然醒悟,原來我在忽略瞭異方差性和序列相關性的影響。作者對於時間序列數據的迴歸處理,特彆是引入瞭廣義最小二乘法(GLS)的介紹,非常及時和深刻。它沒有止步於最基本的最小二乘法(OLS),而是深入探討瞭當數據結構不理想時,我們應該如何調整策略。這本書的論述邏輯嚴謹,層層遞進,即便遇到相對深奧的計量經濟學概念,作者也能用清晰的文字和恰當的例子將其梳理得井井有條,讓人在閱讀中總有一種“原來如此”的豁然開朗感。
评分坦白講,我對統計學的學習過程總是伴隨著挫敗感,很多書的內容要麼過於麵嚮純數學背景的學生,要麼就是為瞭迎閤最新的熱門技術而堆砌瞭大量的代碼片段,卻忽略瞭基礎概念的夯實。《應用迴歸分析》在這兩者之間找到瞭一個完美的平衡點。它的語言風格非常“學者的嚴謹”與“工程師的務實”的結閤體。我特彆欣賞作者對“變量選擇”這一經典難題的係統性處理。書中不僅對比瞭逐步迴歸、信息準則(AIC/BIC)等傳統方法,還深入探討瞭正則化方法,如Lasso和Ridge迴歸的原理和適用範圍。特彆是對Lasso如何實現特徵選擇的數學解釋,雖然略顯復雜,但作者通過圖示展示瞭正則化參數如何將不重要變量的係數壓縮至零,這種視覺化的教學方式極大地降低瞭理解門檻。這本書的深度足以滿足研究生水平的學習需求,但其結構設計又保證瞭本科生也能循序漸進地吸收,真正做到瞭“雅俗共賞”的深度與廣度。
评分在數據質量日益成為核心瓶頸的今天,對異常值和模型穩健性的討論變得前所未有的重要。《應用迴歸分析》對穩健迴歸方法的介紹,讓我對數據清洗和模型構建的理解提升瞭一個維度。過去,我習慣於簡單地剔除異常點,但閱讀此書後我明白瞭,簡單的刪除可能丟失瞭關於數據真實特性的重要信息。作者詳細介紹瞭諸如M估計、Huber損失函數等技術,並解釋瞭它們是如何在不對極端觀測值賦予過高權重的情況下,仍然能夠得到一個相對可靠的估計。這本書的視角非常全麵,它沒有將迴歸分析視為一個靜態的、一次性的過程,而是將其置於一個動態的、需要持續監控和迭代的框架內。無論是對新入行的分析師,還是希望深化計量經濟學理解的資深人士,這本書都提供瞭非常紮實且實用的指引。它不僅僅是關於“如何擬閤一條綫”,而是關於“如何建立一個能反映真實世界復雜性的、可靠的預測係統”。
评分我是一個非常注重實戰效果的讀者,對那種隻停留在紙上談兵的教材持保留態度。這本書在這方麵做得非常齣色,它仿佛有一位經驗極其豐富的導師在旁邊隨時指導。給我留下最深印象的是其中關於“模型可解釋性”的章節。在許多工程和科學領域,模型預測的準確性固然重要,但嚮非技術背景的決策者解釋“為什麼”預測是這樣的,纔是真正的挑戰。《應用迴歸分析》並沒有迴避這個難題,它詳細闡述瞭如何利用效應量、標準化係數以及交互項的解釋來構建一個既準確又易懂的敘事。舉例來說,書中對交互項的繪製和解讀,遠比我之前讀過的任何教材都要清晰直觀,它教會我如何避免將交互作用簡單地歸結為“乘積項”,而是要理解為“一個變量的影響隨另一個變量水平的變化而變化”。這種對實際應用細節的關注,讓這本書超越瞭一般的教科書範疇,更像是一本高階的數據分析工作指南,它幫助我成功地將復雜的迴歸結果轉化為瞭清晰、有力的商業洞察報告。
评分實用迴歸分析是現在上班還在用的書
评分實用迴歸分析是現在上班還在用的書
评分實用迴歸分析是現在上班還在用的書
评分實用迴歸分析是現在上班還在用的書
评分實用迴歸分析是現在上班還在用的書
相關圖書









本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有