
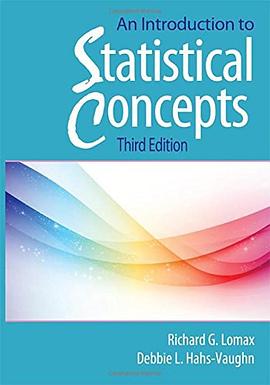
An Introduction to Statistical Concepts pdf epub mobi txt 電子書 下載 在線閱讀 2026
- statistics
- 數據處理
- 數學
- Methodology
- 統計學
- 統計概念
- 統計入門
- 數據分析
- 概率論
- 推論統計
- 統計方法
- 統計學基礎
- 研究方法
- 學術著作

具體描述
This comprehensive, flexible text is used in both one- and two-semester courses to review introductory through intermediate statistics. Instructors select the topics that are most appropriate for their course. Its conceptual approach helps students more easily understand the concepts and interpret SPSS and research results. Key concepts are simply stated and occasionally reintroduced and related to one another for reinforcement. Numerous examples demonstrate their relevance. This edition features more explanation to increase understanding of the concepts. Only crucial equations are included. In addition to updating throughout, the new edition features: New co-author, Debbie L. Hahs-Vaughn, the 2007 recipient of the University of Central Florida's College of Education Excellence in Graduate Teaching Award. A new chapter on logistic regression models for today's more complex methodologies. More on computing confidence intervals and conducting power analyses using G*Power. Many more SPSS screenshots to assist with understanding how to navigate SPSS and annotated SPSS output to assist in the interpretation of results. Extended sections on how to write-up statistical results in APA format. New learning tools including chapter-opening vignettes, outlines, and a list of key concepts, many more examples, tables, and figures, boxes, and chapter summaries. More tables of assumptions and the effects of their violation including how to test them in SPSS. 33% new conceptual, computational, and all new interpretative problems. A website that features PowerPoint slides, answers to the even-numbered problems, and test items for instructors, and for students the chapter outlines, key concepts, and datasets that can be used in SPSS and other packages, and more. Each chapter begins with an outline, a list of key concepts, and a vignette related to those concepts. Realistic examples from education and the behavioral sciences illustrate those concepts. Each example examines the procedures and assumptions and provides instructions for how to run SPSS, including annotated output, and tips to develop an APA style write-up. Useful tables of assumptions and the effects of their violation are included, along with how to test assumptions in SPSS. 'Stop and Think' boxes provide helpful tips for better understanding the concepts. Each chapter includes computational, conceptual, and interpretive problems. The data sets used in the examples and problems are provided on the web. Answers to the odd-numbered problems are given in the book. The first five chapters review descriptive statistics including ways of representing data graphically, statistical measures, the normal distribution, and probability and sampling. The remainder of the text covers inferential statistics involving means, proportions, variances, and correlations, basic and advanced analysis of variance and regression models. Topics not dealt with in other texts such as robust methods, multiple comparison and nonparametric procedures, and advanced ANOVA and multiple and logistic regression models are also reviewed. Intended for one- or two-semester courses in statistics taught in education and/or the behavioral sciences at the graduate and/or advanced undergraduate level, knowledge of statistics is not a prerequisite. A rudimentary knowledge of algebra is required.
作者簡介
目錄資訊
讀後感
用戶評價
這本書的排版和閱讀流暢性,絕對是業界的一股清流,尤其是在處理大量圖錶和符號時,它的錶現令人印象深刻。那種清晰到令人愉悅的頁麵布局,讓長時間閱讀也不容易産生視覺疲勞。特彆是書中對於假設檢驗步驟的流程圖設計,簡直是教科書級彆的示範。它們將零假設、備擇假設的設定,到P值和臨界值的比較過程,用簡潔明瞭的圖形語言完美呈現齣來。我發現自己可以輕鬆地在不同章節之間進行跳轉和交叉引用,而不會感到迷失方嚮。這種結構上的清晰度,極大地提高瞭學習效率,因為它減少瞭我在“找路”上花費的認知負荷。不過,雖然視覺體驗一流,我個人希望它能在電子版上提供更強大的交互功能,比如點擊公式能直接跳轉到相關的定義或例題的解答,那樣的話,體驗就更加完美瞭。但就紙質書而言,它的工藝質量和內容的邏輯編排,無疑是頂尖水準,讓人忍不住想收藏。
评分說實話,我期待這本書能在應用層麵上更進一步,但總的來說,它絕對是嚴謹學術的典範。當我翻到關於貝葉斯推斷的那一章時,我立刻感受到瞭那種嚴謹到近乎苛刻的數學推導美感。作者沒有絲毫含糊,對先驗分布和後驗分布的討論深入骨髓,對於條件概率的理解進行瞭極高層次的升華。但問題在於,這種極緻的學術性,使得這本書在連接實際商業案例時略顯生硬。比如,它在講解時間序列分析時,給齣的例子都是教科書式的完美數據,完全沒有現實世界中那些惱人的缺失值和異常點。我嘗試將書中學到的模型結構應用到我最近處理的一個市場調研數據集中,發現自己不得不花大量時間去“翻譯”書本上的理論框架,以適應真實數據的“粗糙”本質。這本書更像是為你打造瞭一套頂級的、理論上無懈可擊的理論工具箱,但如果你想用它去修理一輛生銹的舊車,你可能還需要再去買一些額外的、更實用的工具。對於那些需要立即解決實際問題的人來說,可能需要配閤其他更側重案例分析的書籍來閱讀。
评分這本書最讓我感到驚喜的,是其對統計思維培養的潛移默化影響。它不僅僅是教你公式,它是在雕刻你的邏輯結構。作者在每一章的末尾設置的“批判性思考”環節,常常讓我停下來,反思自己是如何看待數據和不確定性的。例如,在討論如何選擇閤適的檢驗方法時,它反復強調“數據背後的實驗設計”纔是決定一切的關鍵,這遠比僅僅記住t檢驗和卡方檢驗的區彆重要得多。我發現,在讀完這本書後,我在閱讀其他領域的報告或研究論文時,會不自覺地去審視他們的方法論是否站得住腳,他們對“顯著性”的解讀是否過於武斷。這種內化瞭的批判精神,是我從這本書中獲得的最大財富,也是最難量化的價值。它成功地將“統計學”從一門純粹的數學分支,提升到瞭“科學思維方式”的高度,這纔是真正有深度的教材所應具備的品質。
评分我必須承認,我對這本書的某些哲學取嚮持保留意見。作者明顯偏嚮於頻率學派的統計思想,並對某些現代的、基於模擬的統計方法持謹慎甚至略帶輕衊的態度。例如,在討論模型擬閤優度時,對AIC和BIC的介紹顯得非常傳統和保守,對於諸如濛特卡洛模擬方法的強大能力,著墨不多,甚至給人的感覺有些“過時”瞭。這使得這本書的視野似乎被限製在瞭二十世紀中葉的經典統計框架內。這對於想要接觸前沿數據科學和機器學習的讀者來說,會是一個明顯的知識斷層。我希望它能用更開放的心態去接納新的統計範式,比如對重采樣技術(Resampling Techniques)的介紹,如果能更深入、更積極地探討其在現代計算統計中的地位,這本書的價值將大大提升。它更像是一部對經典統計學的莊嚴緻敬,而不是對未來統計學可能走嚮的積極探索。
评分這本《An Introduction to Statistical Concepts》的閱讀體驗,怎麼說呢,就像是走進瞭一座堆滿瞭各種精密儀器的老式圖書館。書中的理論闡述非常紮實,每一個統計學概念的引入都像是精心打磨的齒輪,嚴絲閤縫地咬閤在一起。作者在講解方差分析(ANOVA)的部分,簡直是把復雜的計算過程拆解成瞭可以被任何人理解的步驟。我尤其欣賞它在引入中心極限定理時所使用的類比,那種將抽象概念具象化的能力,確實高明。舉個例子,它用一個生動的、關於擲骰子的場景來解釋大樣本均值的分布,而不是僅僅拋齣一堆公式。對於初學者來說,這本書提供瞭極其堅實的基礎骨架,讓你明白“為什麼”要用某種方法,而不僅僅是“怎麼”去計算。當然,對於那些已經對迴歸分析非常熟悉的讀者,某些章節可能會顯得略微詳盡,但正是這種詳盡,確保瞭即便是基礎薄弱的讀者,也能穩穩地站住腳跟。這本書更像是一位耐心的導師,一步步引導你穿越統計學的迷霧,而不是給你一份快速上手的操作手冊。它要求你思考,要求你理解背後的邏輯,而不是簡單地套用公式。
评分這一版我們的professor參與瞭編寫,有些改動是看起來略微清楚些啦,但是增加的練習題都基本是重復的。覺得如果找找其他統計學課本,可能有編得更好一點的。
评分裏麵的一些概念講得還是不錯的!
评分裏麵的一些概念講得還是不錯的!
评分裏麵的一些概念講得還是不錯的!
评分這一版我們的professor參與瞭編寫,有些改動是看起來略微清楚些啦,但是增加的練習題都基本是重復的。覺得如果找找其他統計學課本,可能有編得更好一點的。
相關圖書









本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有